


- @whweia


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
摘要:本文系统梳理了模型服务层性能压测的关键要点。压测核心关注推理服务的系统性能,包括四大指标:延迟(P95/P99响应时间、TTFB)、吞吐(QPS、token/s)、成功率(HTTP200/超时/错误比例)和资源瓶颈(GPU显存/利用率)。采用分阶段压测方法,通过逐级增加并发观察性能拐点,结合资源监控定位瓶颈。模型层压测能确定单实例并发能力、部署需求和扩容方案,但不验证决策稳定性和输出可靠性。
AI 对传统测试真正有意思的地方,我觉得并不是:AI 会不会把测试工程师替代掉。这个问题现在讨论意义没那么大。以前一个测试工程师需要自己完成的需求理解、影响分析、测试设计、脚本开发、失败定位和结果整理,现在有哪些环节可以让 AI 一起参与?如果只是:ChatGPT → 生成 Case很快就会发现没什么东西可讲。需求、Repo、Code Diff、接口、Log、历史 Case、项目规则AI 处理 →
本文从零开始演示如何申请并调用智谱 AI 大模型 API,通过一个最小 Python Demo 跑通完整链路。在此基础上,站在测试工程师视角,系统梳理了 messages 结构、role 使用、模型版本差异、temperature 稳定性、异常场景、网络超时与鲁棒性等关键测试点。文章重点强调:大模型并非“黑盒魔法”,而是一个需要被验证、约束和工程化的系统,适合正在转向 AI 测试或 AI 工程实践
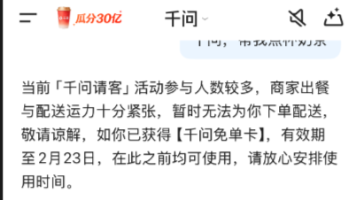
一次使用千问点奶茶失败的经历,引发了我对 Agent 系统完整链路的重新审视。本文不是从模型能力出发,而是从真实执行失败的现象入手,拆解了一次 Agent 任务从输入理解、规划、工具调用到业务系统执行的完整过程,并分析了失败通常发生在哪些环节。在此基础上,进一步梳理了 Agent 场景下性能与稳定性测试的关注重点,说明为何很多问题并不出在大模型本身,而是在链路设计与失败处理机制上。
很多人把“大模型性能测试”简单理解为压模型并发和响应时间,但在实际 AI 项目中,模型层压测只是其中一部分。本文结合实际 Agent 项目经验,从模型服务层与 Agent 系统层两个维度出发,梳理 AI 性能测试的分层思路:模型并发能力验证、决策层稳定性验证、状态层并发安全,以及生成层结构可靠性。通过对比两类测试目标与核心指标,明确真正的 AI 性能测试应该是“分层设计、分层验证”的系统工程,而不
新迭代需求来了,第一个问题是:数据集怎么准备?按常规思路,去问上一个迭代的同事。但他已经调去别的部门,找他很麻烦,每次只能问一点,他还让我去问另一个同事。问了几轮之后发现,不同同事站的角度完全不同——有人从APP测试角度讲,有人从算法角度讲,越问越乱。最后的解法是:停止问人,自己断定。我是这个迭代的主要测试,得有自己的判断。跟AI反复聊了需求文档,梳理出核心问题:∙这个迭代测的是什么场景?∙验收标
控制变量、等价类划分、边界值分析、多次采样、归因分层不是AI测试独有的,是科学实验几百年沉淀下来的方法论。但在AI测试里,它们比传统测试更重要。因为AI系统的不确定性更大、链路更长、输入空间更广,没有这些思维兜底,测出来的结论经不起推敲。工具会变,框架会变,但思维方式不会过时。
本文探讨了RAG系统中生成层的作用与实现机制。文章指出生成层的核心功能不是"找答案"而是"组织答案",将检索到的内容转化为用户可直接使用的自然表达。通过拆解真实流程,揭示了教学资料(静态知识)和用户指令(动态需求)的分工关系:资料提供内容,指令决定表达方式。重点解析了Prompt的构造方法,强调其由模板、检索结果和用户指令拼接而成。最后指出生成层的关键在于确
文章摘要:本文讨论了CV模型评测中的关键问题与指标体系构建。首先指出仅依赖准确率指标的局限性,特别是样本不平衡时的误导性。随后提出完整的CV评测指标体系,包括准确率(需结合权重)、召回率(用户视角)、混淆矩阵(错误分析)和P99延迟(性能瓶颈)。在版本对比方面,强调环境对齐、样本覆盖度和结果波动分析的重要性。最后对比了CV模型(确定性)与Agent系统(概率性)的评测差异,指出CV评测需关注指标选
本篇记录一次多文档 RAG 测试中的真实踩坑过程:从 PDF 解析异常(内容未进入 chunks),到多文档污染(scope 依赖 top1),再到显式文档约束解析与跨文档对比边界控制。通过增加 forced_doc 规则、compare gate 以及 scope 回归断言,逐步稳定多文档行为,并以 v0.4 版本打 tag 冻结代码。本篇聚焦问题暴露与修复过程,而非算法优化。