- @weixin_47895059


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
老师要用mindspore 做作业,可真是难为我了。。。。折腾了好久才算上手,感谢李老师给我一个这么充实的清明假期。。。。。主要代码还是参考官网教程。简单线性函数拟合 — MindSpore master documentation就算华为的框架有一千个不好用,它中文的入门教程绝对比pytorch的好读懂的多,这是我喜欢他的一点。"""Linear Regression TutorialThis
例4.2:杰克管理一个全国性汽车出租公司的两个地点。每天一些顾客到这两个地点租车。如果有车可租,杰克就将车租出并从公司得到10美元的回扣。如果这个地点没车,杰克就失去了这笔生意。还回的车第二天就可以出租。为了使需要车的地点有车可租,每天晚上,杰克可以在两个地点间移动车辆,移动每辆车的费用是2美元。我们假设每个地点的车的需求量和归还量都是泊松分布变量。假设租车的期望值是3和4,还车的期望值是3和2。
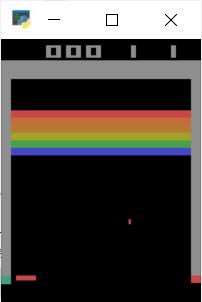
import torchimport atari_pyimport pandas as pdimportnumpy as npimport gymimport timeimport PIL.Image as Imageimport torch.nn as nnclass DQBReplayer:def __init__(self,capacity):self.memory = pd.DataFra
整体伪代码如下初始化价值网络 V 和策略网络 pi对于 i 在范围 1500 内循环:# 通过自对弈收集数据环境重置()初始化根节点当未完成时循环:动作, 动作概率 = 玩家获取动作()# 通常在 get_action 函数中涉及 400 次选择和扩展。# 如果任何一次迭代达到游戏结束,更新 MCTS 节点的值。当前状态 = 下一状态将根节点移至当前状态的节点如果收集到的数据 > 批量大小:使用收
代码都是学习别人的,但我分享几点我踩过的大坑。1.蒙特卡洛的V值2.样本不是独立同分布之后再 详述一下""""""import torch.nn.functional as Fimport torchvision.models as modelsimport retroimport hiddenlayer as hlimport torch# import retroimport pandas a
多智能体强化学习mappo算法实践,含pytorch代码
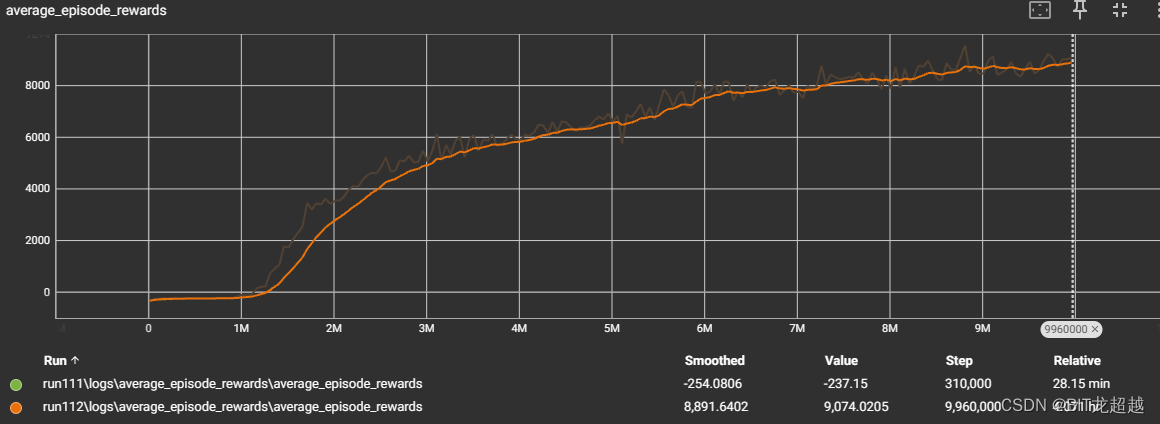
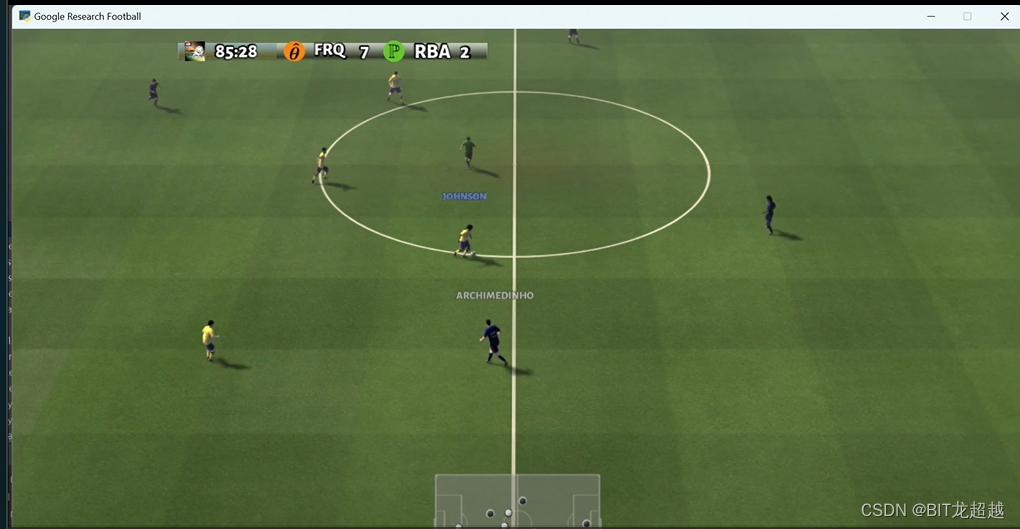
实验场景:5v5(控制蓝方一名激活球员),跳4帧,即每个动作执行4次实验点:修复dense奖励后智能体训练效果能否符合预期实验目的:对比gru 长度为16 和 dense net作为aggrator的区别实验效果reward。
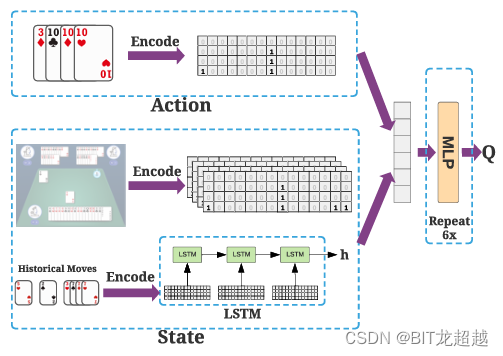
深度蒙特卡洛算法是一种使用深度神经网络来进行蒙特卡洛估计的强化学习算法,它最早于2020年在《DouZero: Mastering DouDizhu with Self-Play Deep Reinforcement Learning》被提出用于解决斗地主问题。深度蒙特卡洛算法使用深度网络拟合每个时刻,智能体状态和采取每种动作的价值函数,即Q value,所以其属于value base 类方法。
方法:1.wget ‘网址’网址在这里找,动作讲究一个快准狠,慢了链接就失效了
import cv2import numpy as npglobal imgglobal point1,point2global g_rectdef on_mouse(event,x,y,flag,param):global img, point1,point2,g_rectimg2=img.copy()if event ==cv2.EVENT_LBUTTONDOWN:print("1-EVENT