


- @weixin_45564943


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
DETR:基于Transformer的端到端目标检测新范式 DETR(DEtection TRansformer)是Facebook AI提出的革命性目标检测模型,完全摒弃了传统方法中的锚框、NMS等手工设计组件,首次将Transformer架构引入目标检测领域。其核心创新包括:1)采用集合预测方式直接输出固定数量检测结果;2)利用Transformer的自注意力机制实现全局建模;3)通过二分图匹
目录1.python实现对doc文档的读取2.python实现对txt文档的读取3.python实现对xls表格的读取1.python实现对doc文档的读取#读取docx中的文本代码示例import docx#获取文档对象file=docx.Document("path")print("段落数:"+str(len(file.paragraphs)))#段落数为13,每个回车隔离一段#输出每一段的
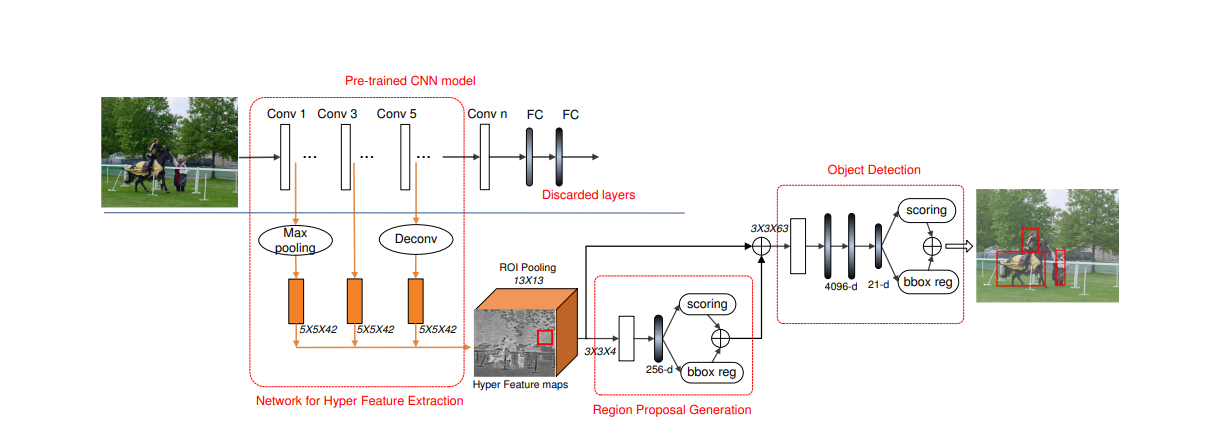
目录1.背景:2.结构图:3.优点4.加速策略:5.产生优异效果:6.轻量化方法:1.背景:卷积神经网络的特点是,深层的特征体现了强语义特征,有利于进行分类与识别,而浅层的特征分辨率高,有利于进行目标的定位。原始的Faster RCNN方法仅仅利用了单层的feature map(例如VGGNet的conv5-3),对于小尺度目标的检测较差,同时高IoU阈值时,边框定位的精度也不高。 在2016 C
目录1. 显卡驱动2.cuda3.cudnn4.pytorch简单的关系如下图:1. 显卡驱动显卡驱动是电脑上服务于显卡的驱动程序,有了显卡驱动显卡的功能才能被最大化利用!显卡驱动的作用就是用来驱动显卡的,这是电脑硬件中所对应的一个软件。通过添加驱动程序计算机中的硬件就能正常的工作,当然不同的硬件使用的驱动程序也不一样。显卡对应的就是显卡驱动。显卡在电脑中提供图形的重要显示部分,直接关系到电脑的图
本文系统整理了Physical Intelligence(PI)在机器人基础模型方向的π系列研究主线,包括π0-FAST的动作表示、π0.6-MEM的长时记忆等核心工作。该系列研究旨在构建能控制多种机器人、理解自然语言、适应真实场景并通过经验持续改进的通用机器人基础模型。研究路线从π0的VLM+flowmatching基础架构出发,通过FAST实现高效动作token化,π0.5实现开放世界泛化,π
目录1.背景介绍2.压缩方法概述3.压缩方法详述3.1参数剪枝3.2参数量化3.3低秩分解(张量分解)3.4参数共享3.5紧凑网络3.6知识蒸馏3.7混合模型3.8不同压缩模型比较1.背景介绍深度学习模型的压缩和加速是指利用神经网络参数的冗余性和网络结构的冗余性精简模型,在不影响任务完成度的情况下,得到参数量更少、结构更精简的模型.被压缩后的模型计算资源需求和内存需求更小,相比 原始模型能够满足更

本文摘要:本文系统梳理了深度学习和计算机视觉中的核心概念与技术。重点解析了Focal Loss、主动学习等算法原理,对比了BEV与PV视角特性,阐述了浅层/深层特征差异。详细介绍了Head模块设计、Bottleneck结构、LSS算法等技术细节,并对比了BN与LN的适用场景。同时涵盖了UNet、DiT、Embedding等模型架构,以及BMM、WarmUp等关键操作策略。内容涵盖目标检测、自动驾驶
linux下对摄像头曝光度的命令调节命令模式调节唯一的好处可以,用此命令的接口制作软件。 安装v4l2-ctlsudo apt install v4l-utilsv4l2-ctl -l#列出所有可以修改的选项及值v4l2-ctl -C exposure_auto#列出对应选项的值v4l2-ctl -c exposure_auto=1#修改对应选项值 ,(1为手动模式,3为自动模式)v4l2-ctl
目录1.背景介绍2.压缩方法概述3.压缩方法详述3.1参数剪枝3.2参数量化3.3低秩分解(张量分解)3.4参数共享3.5紧凑网络3.6知识蒸馏3.7混合模型3.8不同压缩模型比较1.背景介绍深度学习模型的压缩和加速是指利用神经网络参数的冗余性和网络结构的冗余性精简模型,在不影响任务完成度的情况下,得到参数量更少、结构更精简的模型.被压缩后的模型计算资源需求和内存需求更小,相比 原始模型能够满足更
主要区别简单来说如下:传统方法:检测速度比较快,但是准确度较差,召回率较低。CNN方法:速度慢,但是准确度和召回率好很多。
