- @victor_manches


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
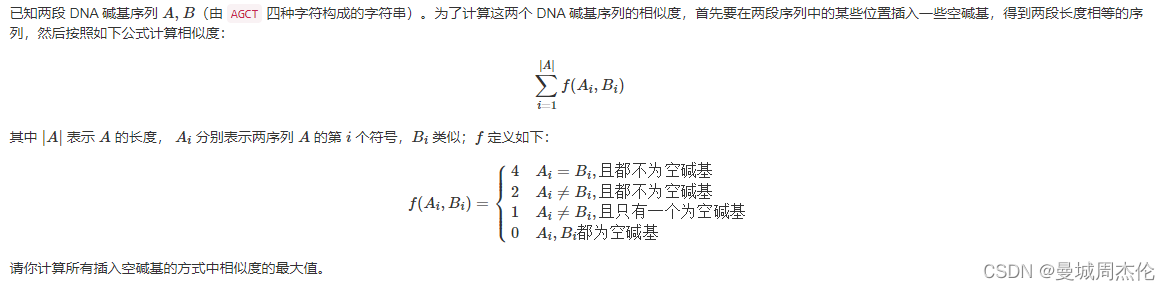
驭风计划是由清华大学老师教授的,其分为四门课,包括: 机器学习(张敏教授) , 深度学习(胡晓林教授), 计算机语言(刘知远教授) 以及数据结构与算法(邓俊辉教授)。代码和报告均为本人自己实现,由于篇幅限制,只展示任务布置以及关键代码,如果需要报告或者代码可以私聊博主。数据结构与算法部分授课老师为邓俊辉教授,主要通过从贪心,分治,图搜索,动态规划 , 散列表, 计算几何入门数据结构与算法,有想法的
课程链接:驭风计划是由清华大学老师教授的,其分为四门课,包括: 机器学习(张敏教授) , 深度学习(胡晓林教授), 计算机语言(刘知远教授) 以及数据结构与算法(邓俊辉教授)。本人是综合成绩第一名,除了数据结构与算法其他单科均为第一名。代码和报告均为本人自己实现,由于篇幅限制,只展示任务布置以及关键代码,如果需要报告或者代码可以私聊博主部分授课老师为邓俊辉教授,主要通过从贪心,分治,图搜索,动态规
— 此功能允许 RAG 系统通过与用户的多次交互不断完善查询和生成内容,从而提升用户满意度和系统的整体准确率。:基于灵活的代码库,支持多种检索与生成策略,无需微调模型即可实现低内存占用、易于部署和极佳的可扩展性。:通过多步检索与生成,用户可自定义组件,打造高度定制化系统,以应对复杂和不断变化的数据需求。:通过查询扩展、模式和单元格检索,为语言模型提供关键信息,从而提高生成响应的准确性和效率。:支持
大多数常用的数据分块方法(chunking)都是基于规则的,采用 fixed chunk size(译者注:将数据或文本按照固定的大小进行数据分块)或 overlap of adjacent chunks(译者注:让相邻的数据块具有重叠内容,确保信息不会丢失。) 等技术。对于具有多个层级结构的文档,可以使用 Langchain 提供的 RecursiveCharacterTextSplitter,

多模态大模型越来越火,效果也越来越好,比如Qwen2-VL效果就不错,其支持不同尺寸图片理解、视频理解,其目前已经开源,且最大开源到了72B。关于其技术报告,官方已经发了paper,大家可以自行阅读,而笔者主要想通过实操来看一下其实际效果以及提前踩一些坑,给大家提供一些具体的demo代码,方便大家迅速上手,甚至以此为开端上手所有多模态模型。
通过以上从内容、语言、结构和风格等多个方面对文章进行润色和优化的方法,可以有效地去除 AI 写作带来的机械味,使文章更加符合人类的阅读习惯和审美需求,从而提高文章的质量和可读性。例如在描写一个感人的场景时,AI 可能会使用一些通用的词汇来描述悲伤或喜悦,但无法像人类作者那样融入自己的真情实感,读者在阅读时也就难以产生情感共鸣。它会按照常见的文章结构,如总分总、递进式等进行内容的组织。它可能会频繁使
本人项目地址大全:Victor94-king/NLP__ManVictor: CSDN of ManVictor原文地址: 如何从头训练大语言模型: A simple technical report - 知乎写在前面: 笔者更新不易,希望走过路过点个关注和赞,笔芯!!!写在前面: 笔者更新不易,希望走过路过点个关注和赞,笔芯!!!写在前面: 笔者更新不易,希望走过路过点个关注和赞,笔芯!!!随着

创建一个数据集并定义初始提示词。在这个例子中,我们的目标是生成有吸引力的推文。{"topic": "人工智能", "example_tweet": "人工智能正改变我们的世界!#未来"},{"topic": "气候变化", "example_tweet": "气候变化是真实存在的,现在行动刻不容缓!#环保"},{"topic": "区块链", "example_tweet": "区块链技术为金融带

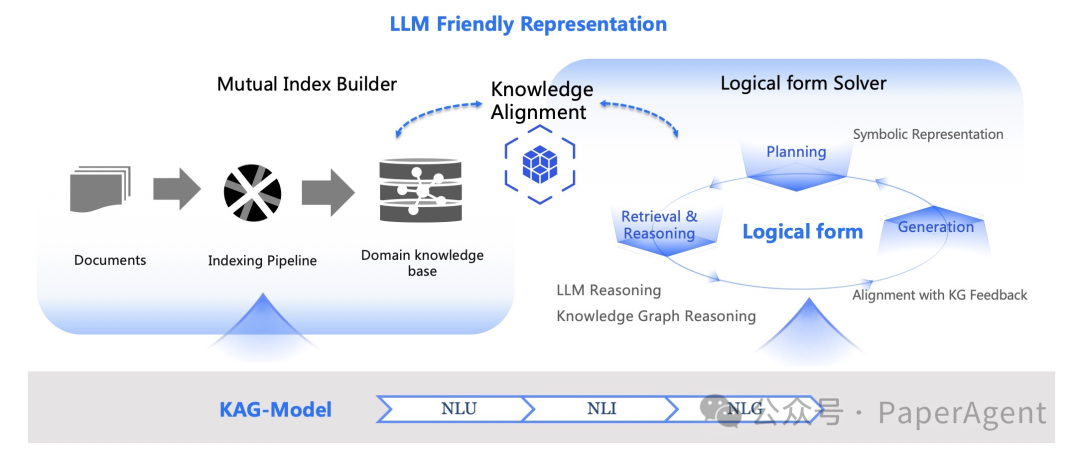
一个对大型语言模型(LLMs)友好的知识表示框架。SPG属性被划分为知识和信息领域,也称为静态和动态领域,它们分别与具有强模式约束的决策专长和具有开放信息表示的文档检索索引知识兼容。归功于在构建更有效的索引、知识对齐和混合解决库方面的创新,KAG框架在多跳问答任务中相比于现有的RAG方法有显著的性能提升,KAG框架介绍了一个基于逻辑形式的混合推理和求解引擎,它能够将自然语言问题转化为结合语言和符号
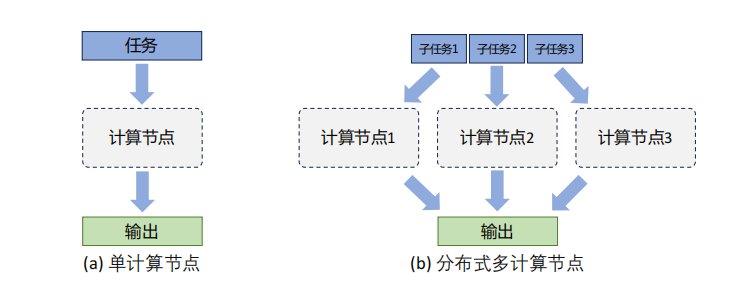
随着大模型时代的到来,模型参数量、训练数据量、计算量等各方面急剧增长。