- @u010681011


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
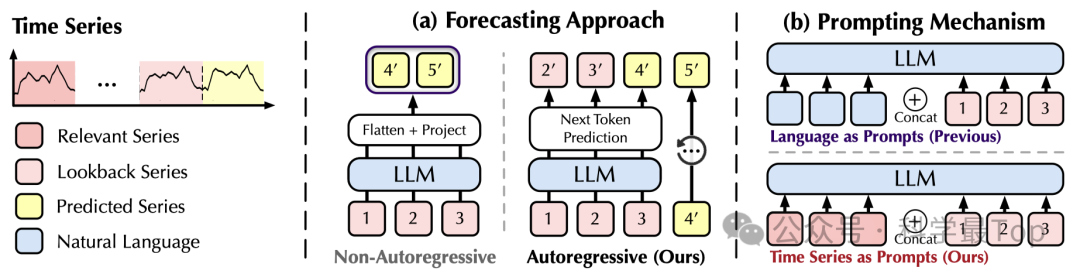
最近大家在读ICLR25的文章吗?感觉高分论文需要的知识储备好多,阅读门槛也太高了~回到这篇文章,本文提出“AutoTimes”方法,旨在将大型语言模型重新用于自回归时间序列预测,通过把时间序列投射到语言标记的嵌入空间中,并以自回归的方式生成任意长度的未来预测结果。“AutoTimes”将时间序列表述为提示信息,将预测的上下文扩展到回顾窗口之外,这被称为“上下文内预测”。通过引入嵌入大型语言模型的
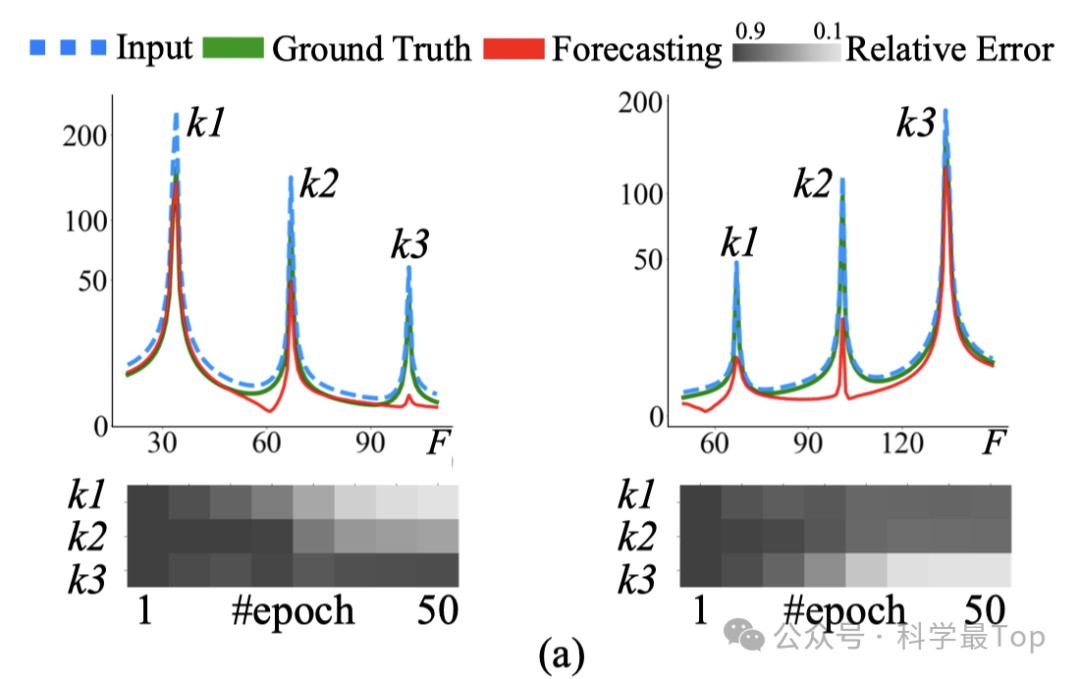
这篇文章发表于KDD2024,作者的出发点以及写作思路特别好,属于先通过定量分析发现时序预测任务中,频域信息利用不合理的问题,然后有针对性的设计了Fredformer模型,最后进行实验评估。所以论文读下来很顺畅,模型设计也让你感觉有据可循。所以理解这篇文章,首先要跟着作者的思路。来看上面这张图,作者挑选了三个模型,分别是FEDformer、Patch TST和本文模型。其中绿线是真实数据,红线是模
论文标题:Patch-wise Structural Loss for Time Series Forecasting代码链接:https://github. com/Dilfiraa/PS_Loss。
FEDformer这篇文章发表于2022年的ICML。其实如果只比较性能的话,到如今其实早已被各类新模型超越。但是考虑到FEDformer一直是时序预测的一个重要baseline。此外,论文采用的周期趋势项分解策略,通过多次分解降低了输入输出的波动这种策略在后续很多论文被反复使用,使得Transformer能够更好地学习长时序中的依赖关系,提升了预测精度。因此,尽管论文发表时间较早,我还是将其列入

论文标题:Patch-wise Structural Loss for Time Series Forecasting代码链接:https://github. com/Dilfiraa/PS_Loss。
这篇文章发表于KDD2024,作者的出发点以及写作思路特别好,属于先通过定量分析发现时序预测任务中,频域信息利用不合理的问题,然后有针对性的设计了Fredformer模型,最后进行实验评估。所以论文读下来很顺畅,模型设计也让你感觉有据可循。所以理解这篇文章,首先要跟着作者的思路。来看上面这张图,作者挑选了三个模型,分别是FEDformer、Patch TST和本文模型。其中绿线是真实数据,红线是模
FEDformer这篇文章发表于2022年的ICML。其实如果只比较性能的话,到如今其实早已被各类新模型超越。但是考虑到FEDformer一直是时序预测的一个重要baseline。此外,论文采用的周期趋势项分解策略,通过多次分解降低了输入输出的波动这种策略在后续很多论文被反复使用,使得Transformer能够更好地学习长时序中的依赖关系,提升了预测精度。因此,尽管论文发表时间较早,我还是将其列入
在本篇文章,我们基于pytorch框架,构造了LSTM模型进行天气预测,并对数据进行了可视化分析,非常值得入门学习。该数据集提供了2013年1月1日至2017年4月24日在印度德里市的数据。数据集和完整可用的代码可以在后台回复"代码04"获取。

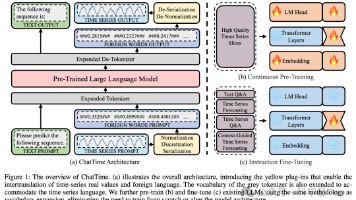
从本质上来说,用于预测下一个单词的语言模型和用于预测下一个值的时间序列模型,都是对历史数据的序列结构进行建模,以预测未来情况。两者的核心都是一个 n 阶马尔可夫过程。本文构建的 ChatTime并时间序列概念化为一门外语(通过归一化和离散化,将连续无界的时间序列转换为一组有限的离散值,然后通过添加标记字符将它们表征为外语单词)。使用与词汇扩展相同的方法对预训练的大语言模型进行持续预训练和指令微调,
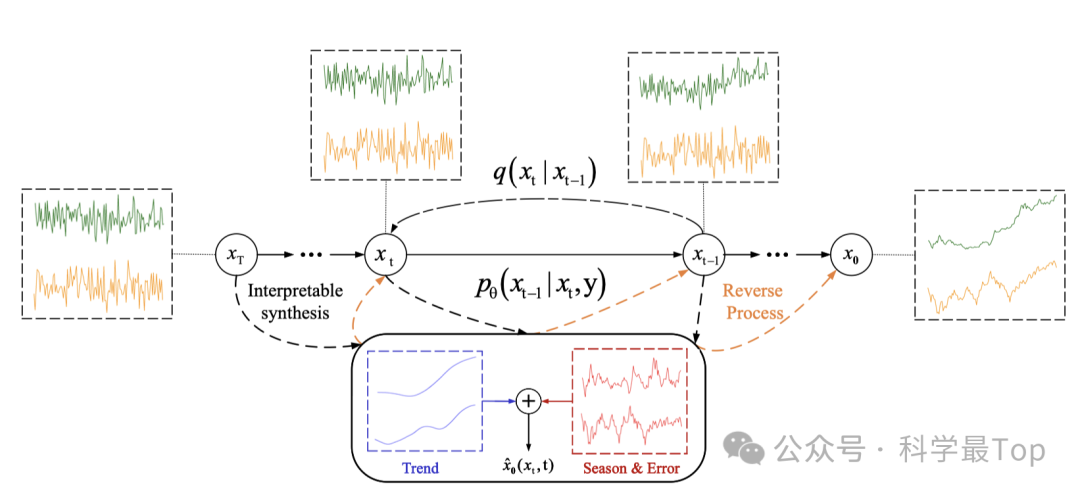
这种目标构建方式受到以下观察的启发:扩散模型的前向过程,即按顺序将数据分布破坏为标准正态分布,直观上与将细粒度数据平滑为粗粒度表示的过程相吻合,两者都导致了精细分布特征的逐渐丧失。在这个框架中,论文采用一种分解技术,使Diffusion-TS能够捕捉到时间序列的语义含义,而Transformer则负责从带有噪声的模型输入中深入挖掘详细的序列信息。去噪过程则以易到难的方式进行,首先生成最粗糙的趋势,