- @stephen147


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
mask矩阵形状[b, s, d],显存占用bsd bytes。:mask矩阵形状[b, s, d],显存占用bsd bytes。:mask矩阵形状[b, h, s, s],显存占用bhs。:形状[b, s, 4d],显存占用8bsd bytes。:形状[b, s, d],显存占用2bsd bytes。:形状[b, s, d],显存占用2bsd bytes。:形状[b, h, s, s],显存占用

老大看了演示demo也想跟着做个agent工具,但踩坑太多,含泪写下博客。

注意-e http_proxy=***是容器container内部的代理,和docker自身程序无关,同理这里的代理也只在pull的时候生效不在容器内生效。然后再docker run就能正常下载镜像了。设置了docker程序内部的代理后,使用。首先在7890端口打开代理服务。一开始使用设置系统代理。
再次刷新端侧多模态天花板,面壁「小钢炮」 MiniCPM-V 2.6 模型重磅上新!该模型基于 SigLip-400M 和 Qwen2-7B 构建,仅 8B 参数,取得 20B 以下单图、多图、视频理解 3 SOTA 成绩,一举将端侧AI多模态能力拉升至全面对标 GPT-4V 水平。更有多项功能首次上「端」:小钢炮一口气将实时视频理解、多图联合理解、多图 ICL 等能力首次搬上端侧多模态模型,更接

图中左侧是用户使用界面,罗列了上述所说的两种调用方式(注意,如前文所说,做demo用的api server官方已经不再维护了,openai_api_server才是官方推荐的使用方式,user custom server目前还没有实现)。右侧则是开发者界面,不难发现LLMEngine是vLLM的核心逻辑。我们来看开发者界面下的几个函数,先来看**LLMEngine。

核心就在于采样策略,一图胜千言:上图中(language model) 的预测输出其实是字典中所有词的概率分布,而通常会选择生成其中概率最大的那个词。不过图中出现了一个采样策略 (sampling strategy),这意味着有时候我们可能并不想总是生成概率最大的那个词。设想一个人的行为如果总是严格遵守规律缺乏变化,容易让人觉得乏味;同样一个语言模型若总是按概率最大的生成词,那么就容易变成 XX讲

人类对自身的研究和模仿由来已久,在我国2000多年前的《列子·汤问》里就描述了有能工巧匠制作出会说话会舞动的类人机器人的故事。声音包含丰富的个体特征及情感情绪信息,对话作为人类最常使用亲切自然的交互模式,是连接人与智能世界至关重要的环节。近日,阿里通义实验室发布并开源了语音大模型项目,旨在深化人类与大型语言模型(LLMs)之间的自然语音交互体验。这一框架的核心是两个创新模型:SenseVoice和

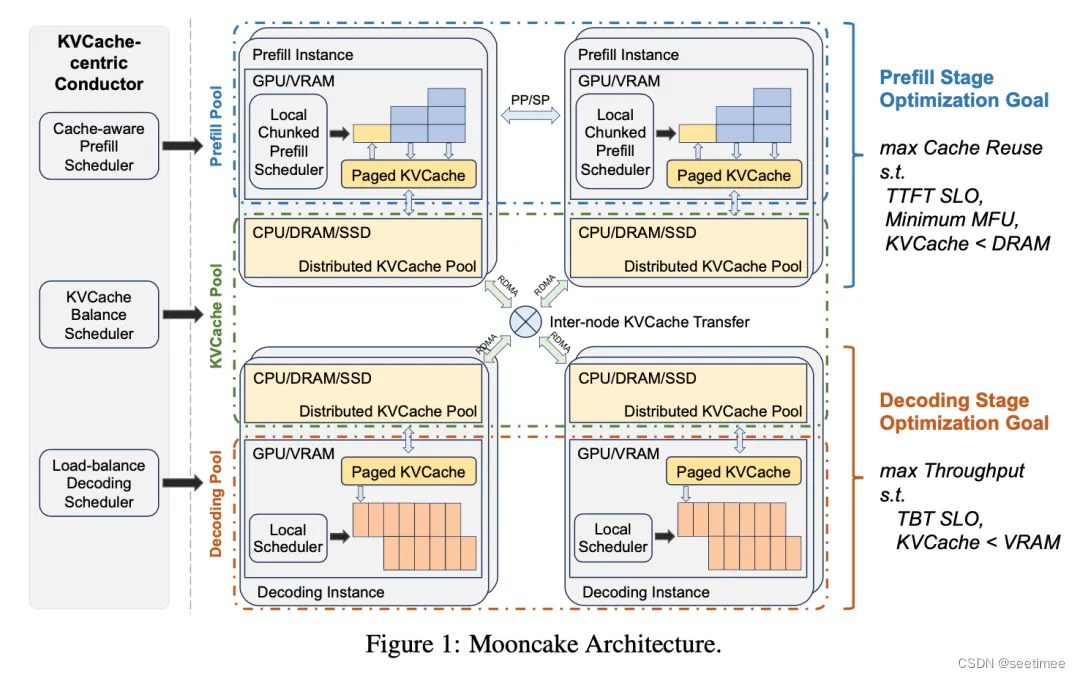
现代大型语言模型(LLMs)基于Transformer架构,该架构利用注意力机制和多层感知器(MLP)来处理输入。基于流行的Transformer模型,例如GPT [10] 和 LLaMA [11],采用的是仅解码器结构。每个推理请求在逻辑上被划分为两个阶段:预填充阶段和解码阶段。在预填充阶段,所有输入token并行处理。此阶段生成第一个输出token,同时存储计算出的中间结果,这些中间结果被称为
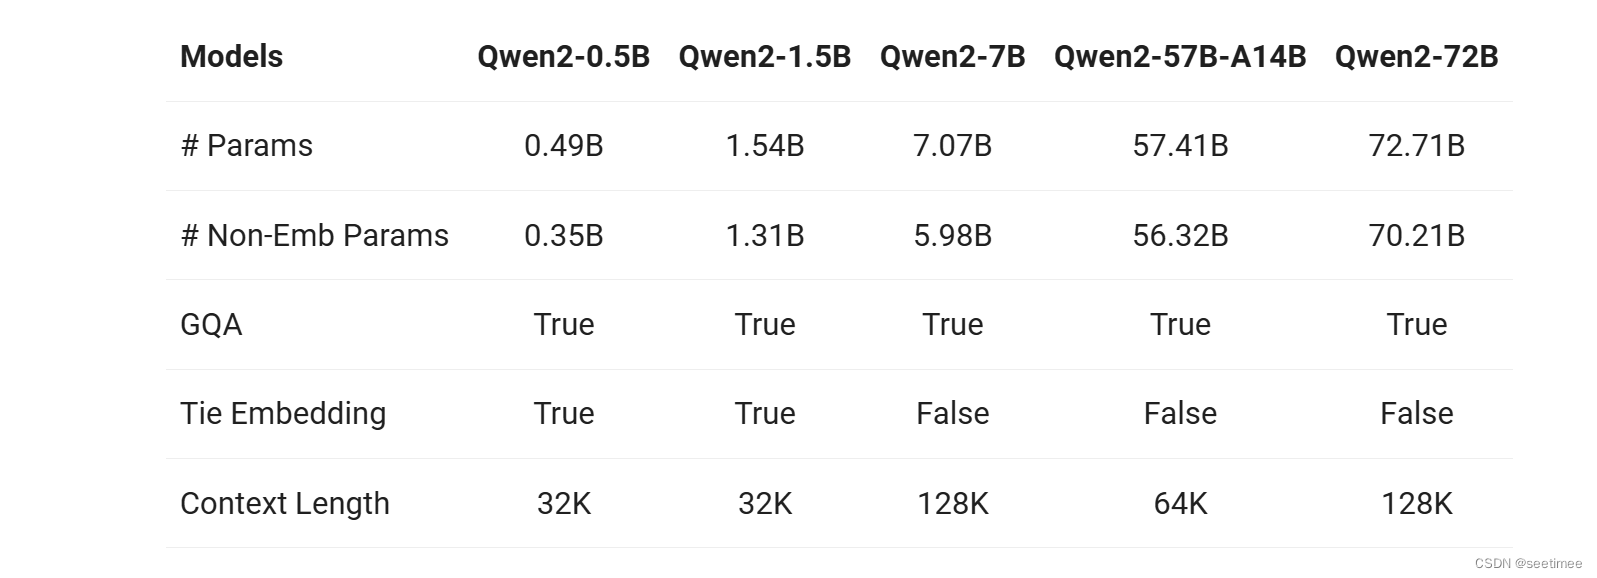
除英语和中文外,还接受过 27 种语言的数据培训显着提高编码和数学表现;Qwen2-7B-Instruct 和 Qwen2-72B-Instruct 的扩展上下文长度支持高达 128K 令牌更详细的benchmark建议去看官网blog。
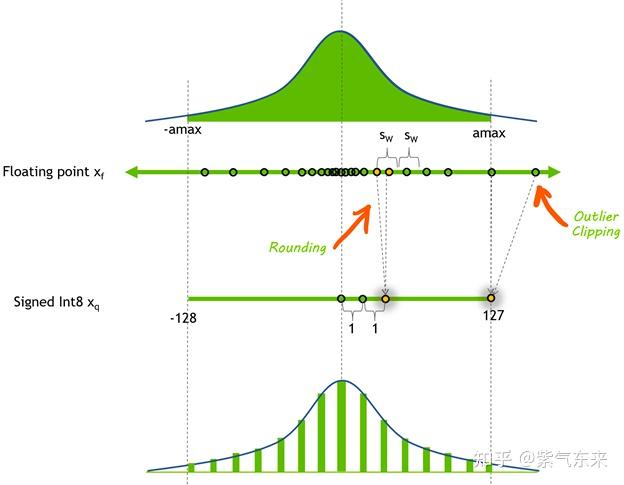
由于量化前的激活值变化范围较大,即使对于同一 token,不同channel数值差异较大,对每个 token 的量化也会造成精度损失,但是不难看出较大值一般出现在同一 channel,因此作者也分析了采用 per-channel 的量化方式,这种量化方式能很好的避免精度损失,但是硬件不能高效执行,增加了计算时间,因此大多数量化仍采用 per-token 及 per-tensor 的量化方式。最后,