- @sqc3375177


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
一个只做过预训练的语言模型,本质上是个"超级接话机器":你给它一段文本,它接着往下写。 一个只做过预训练的语言模型,本质上是个" 超级接话机器 ":你给它一段文本,它接着往下写。 它可能写出通顺的文章,也可能顺着你的问题 编造一段看起来很像答案的东西 ——它没有"这是我该回答的问题"这个概念,更没有"哪个回答更好"的偏好。 但你今天用的助手: - 会拒绝不合理的请求; - 会按指定格式输出; -

一个 AI 助手 App(跨 iOS/Android/桌面)的共享 Rust 核心,它负责三件事: 17.1 我们要交付什么(产品视角) 一个 AI 助手 App(跨 iOS/Android/桌面)的 共享 Rust 核心 ,它负责三件事: 为什么这个分工合理?回顾第 1 课的定位: 把"会变慢、要跨端共享、容易出 bug"的业务核心收进 Rust ——LLM 调用、SSE 解析、历史存储、权限边
第 12 课的线程模型有个物理瓶颈:线程是操作系统资源——每个线程要一块独立栈(默认几 MB),上下文切换有内核开销。1 万个并发连接开 1 万线程,系统直接顶不住。而网络/LLM/文件这类场景,绝大多数时间线程只是等(等网络包、等响应),…
今天看到了一个swift的学习网站,里面收集了很多学习资源Swift 介绍Swift介绍 来自 Apple 官方Swift简介 (@peng_gong) 一篇不错的中文简介[译]Swift 首席架构师 Chris Lattner 简介(黄利民) Swift 背后的男人,他的个人主页。Swift 观点如何评价
本课介绍大语言模型 LLM 的基础概念与完整训练流程。LLM 本质是基于 Transformer 架构,通过自回归方式逐个预测 token 的概率生成文本。文中梳理了 LLM 发展历程,列举写作、编程、Agent 调用等十大应用场景。模型训练分为预训练、监督微调 SFT、人类反馈强化学习 RLHF/DPO 三阶段:预训练学习海量文本形成基础能力,SFT 教会模型遵循指令对话,RLHF/DPO 依靠
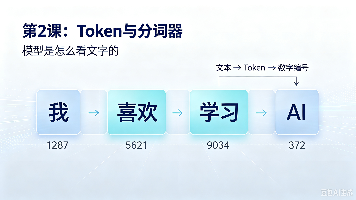
本课讲解 Token 与分词器原理,Token 是大模型处理文本的最小单元,文字会被切分后转换为数字编号供模型读取。主流 BPE 分词算法通过高频片段合并,兼顾词汇表规模与生词处理能力,此外还有 WordPiece、SentencePiece 等分词方案。中文因无天然分隔,同等语义会消耗更多 Token,直接影响接口计费与上下文窗口。文中介绍 tiktoken 工具实现 Token 统计与文本截断
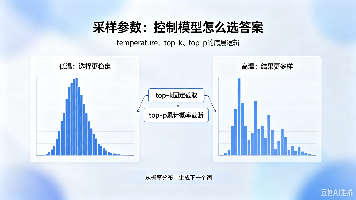
本课讲解大模型关键生成采样参数。LLM 输出并非查询标准答案,而是依据概率分布挑选 token。temperature 如同调节旋钮,控制输出的确定性与创造性;top‑k 按固定数量筛选候选词,top‑p 基于累计概率动态截断候选集合。另外存在频率、存在惩罚参数,用于缓解模型内容重复问题。文中附带简易 Python 采样模拟代码,同时给出不同业务场景的参数配置参考,提醒避免多参数盲目同时调整,帮助
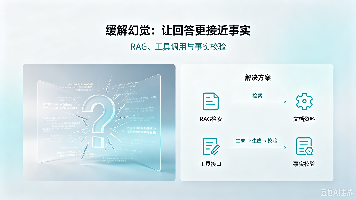
本课讲解大模型幻觉问题,幻觉指模型输出语句通顺自信,但事实虚假的现象。根源在于 LLM 以预测下一个 token 为目标,并非专门查证事实,还受知识截止、训练数据失真影响,分为事实型、逻辑型、指令型三类幻觉。文中介绍 Prompt 层面的优化技巧,同时介绍 RAG 检索增强、工具调用、结果校验等工程方案,区分幻觉与创意生成。提醒医疗、法律等高风险场景不能裸答模型,应当补充资料、接入工具并做好人工复
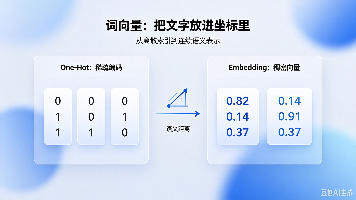
本课介绍 Embedding 词向量技术。Token 编号仅代表标识,无法表达语义,One‑Hot 编码存在维度爆炸、无语义关联的缺陷。Embedding 将词语映射为稠密向量,语义相近的词向量距离更近。Word2Vec 依据上下文学习词的含义,通常使用余弦相似度衡量向量之间语义远近。现代 Embedding 模型可直接生成句子、文档向量,广泛应用于语义搜索、RAG 知识库问答、文本聚类、内容去重
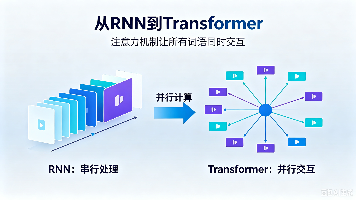
本课详解大模型核心 Transformer 架构。传统 RNN 存在长距离遗忘、无法并行、梯度消失三大缺陷,Transformer 依靠自注意力机制实现全部词并行处理。课程梳理完整执行流程,介绍多头注意力、FFN 前馈网络、残差连接、LayerNorm 等关键组件。当前主流大模型均采用 Decoder‑Only 结构,依靠因果掩码防止偷看后续 token。文中以 Llama‑7B 举例拆解参数分布