


- @smileyboy2009


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
大数据平台,数据湖,数据湖分层

zeppelin 作为数据湖的交互式分析平台,可以在上面写sql,python,java等多种语音和数据库的交互式分析工具,可以通过一个个片段进行分析,支持片段上下文,支持参数和结果传递,不需要进行IDE进行编程,直接在页面上操作。
我们现在数据湖产品,开发基本上都是大数据人员操作,能不能java 开发,比如用java web 开发在线创建表,创建分区,在线修改表字段。做数据湖Iceberg的元数据管理呢,因为我们大部分的表修改希望通过应用修改,并查看应用。对java人员,最麻烦就是安装hadoop,hive,现在这个例子,不需要hadoop和hive,对Iceberg数据湖进行表管理开发。接下来将在window上,通过一个d

最近网上和各大公司在对比spark 和flink , 也有一部分人,演讲时不分析代码原理,不根据事实,直接吹嘘flink比spark好,flink 能干掉spark 的话,今天就跟大家从技术,应用和未来发展角度对两个产品进行对比。先说产品特性:1.spark中批处理使用 RDD, 流处理使用 DStream,flink中批处理使用 Dataset, 流处理使用 DataStreams。目前flin
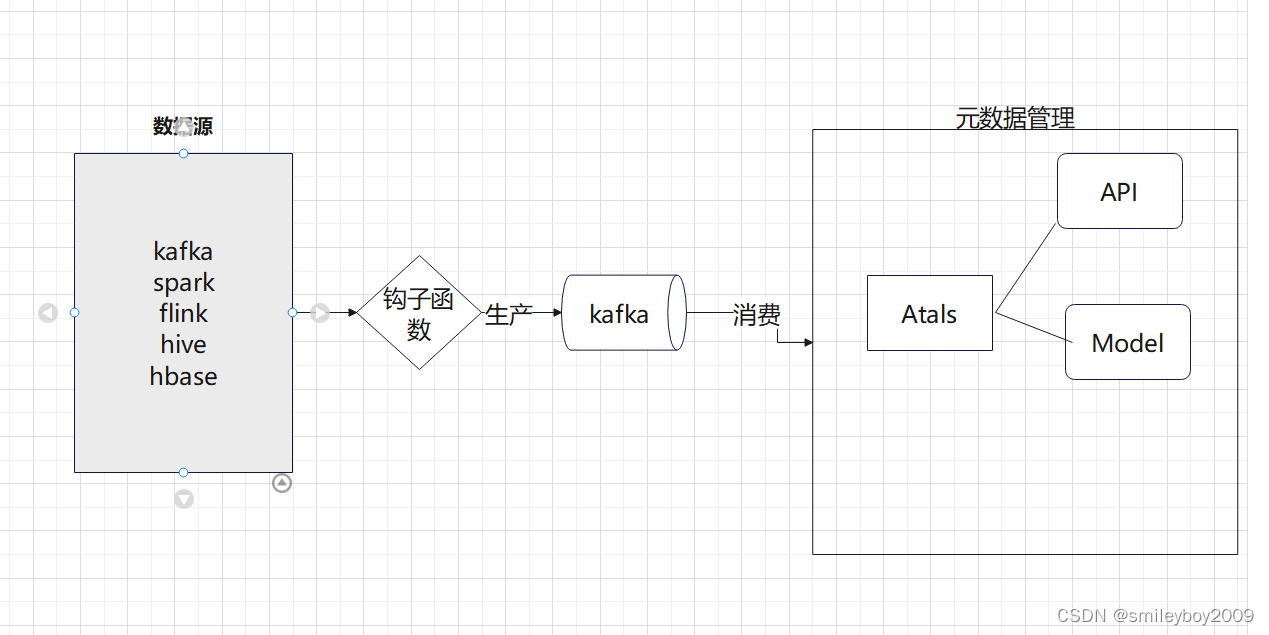
就是你连接的是什么数据库,什么程序,字段,表,视图等这些信息需要进行注册,毕竟不同的库,这些信息不一样,比如hive 和hbase 的属性肯定不一样。我们了解钩子函数先了解,数据源,所谓钩子函数,其实是需要源系统配合,这个其实就是源系统的一个监听机制,就是在客户端(写sql)——执行端,在中间有个监听程序,可以获取sql解析过程。目前市场上开源的元数据管理工具有Atlas, Datahub, Op
最近网上和各大公司在对比spark 和flink , 也有一部分人,演讲时不分析代码原理,不根据事实,直接吹嘘flink比spark好,flink 能干掉spark 的话,今天就跟大家从技术,应用和未来发展角度对两个产品进行对比。先说产品特性:1.spark中批处理使用 RDD, 流处理使用 DStream,flink中批处理使用 Dataset, 流处理使用 DataStreams。目前flin
iceberg 通过java 代码实现增删改查,不需要hadoop 相关组件
对服务提供商而言,接口成为核心资产。同时,本地大模型的算力消耗、接口调用的网络流量,都将成为新的收费点 —— 用户可能购买 “月度 Token 套餐”,或按单次调用付费,彻底摆脱传统 App 的订阅陷阱。大模型通过多模态感知能力,深度理解用户需求的本质 —— 当你说 “找一部适合全家看的喜剧电影”,AI 不仅识别关键词,更会关联家庭成员年龄、观影历史、当前时段等上下文,生成 “家庭喜剧 + 无暴力
└─────┴─────┴──┘│ 长期记忆│└─────┴─────┘。│视觉 │语音 │触││ 知识融合││机械臂│智能│。│模型 │模型 │觉│→特征信号→│ 逻辑推理│→控制指令→││家居│。摄像头小模型检测行人(98%准确率,15ms)人类类比AI对应。