- @shuz0612


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
本文介绍了大语言模型在文本分类任务上的微调方法,以垃圾短信分类为例。首先通过平衡数据集解决类别不平衡问题,并使用填充技术处理不同长度文本。然后修改预训练模型架构,替换输出层为二分类结构,并冻结大部分参数仅训练输出层。
大语言模型是在海量文本数据上进行预训练。然而,文本数据是离散的,无法直接用于执行神经网络训练所需的数学运算。因此,我们需要将文本数据转换为‘嵌入’的数值向量形式。下面我们学习如何为训练大模型准备输入数据。
注意力机制可以将输入元素转换为增强的上下文向量表示。自注意力机制通过对输入进行加权求和来计算上下文向量表示。使用矩阵乘法替代for循环,可以提高计算效率。引入了可训练的权重矩阵来计算输入的中间变换:查询矩阵、值矩阵和键矩阵。我们从一个基础版本的自注意力机制开始,然后逐步加入可训练的权重。因果注意力机制在自注意力的基础上增加了额外掩码,使得大语言模型可以一次生成一个单词。最后,多头注意力将注意力机制
将嵌入的输入词元与相应的注意力权重。
本文介绍了构建类GPT大语言模型的关键组件及其实现方法。首先阐述了层归一化技术如何通过调整激活值分布来提升训练稳定性,随后对比了ReLU、GELU等激活函数的特性,并实现了包含GELU的前馈神经网络模块。文章详细讲解了快捷连接在缓解梯度消失问题中的作用,以及如何将多头注意力机制与前馈网络结合形成Transformer块。最后展示了GPT模型的整体架构,包括文本生成机制从词元编码到解码的全过程,并指
下图展示了人工智能、机器学习、深度学习和大语言模型以及生成式大语言模型之间的关系。人工智能是包括机器学习、深度学习等众多分支的领域,旨在开发能够执行需要人类智能水平的任务(包括语音理解、模式识别、决策制定)的机器。机器学的重点研究内容是实现人工智能的算法。机器学习涉及开发能够从数据中学习的算法。无需明确编程,这些算法就能基于数据做出预测或决策。深度学习是机器学习的一个分支,它主要利用 3 层及以上
Ollama是一款开源工具,其目标是简化大语言模型在本地环境的部署和使用。它支持多种流行的开源大语言模型,如 Llama 2、Qwen2.5等。介绍Ollama部署和常用命令。

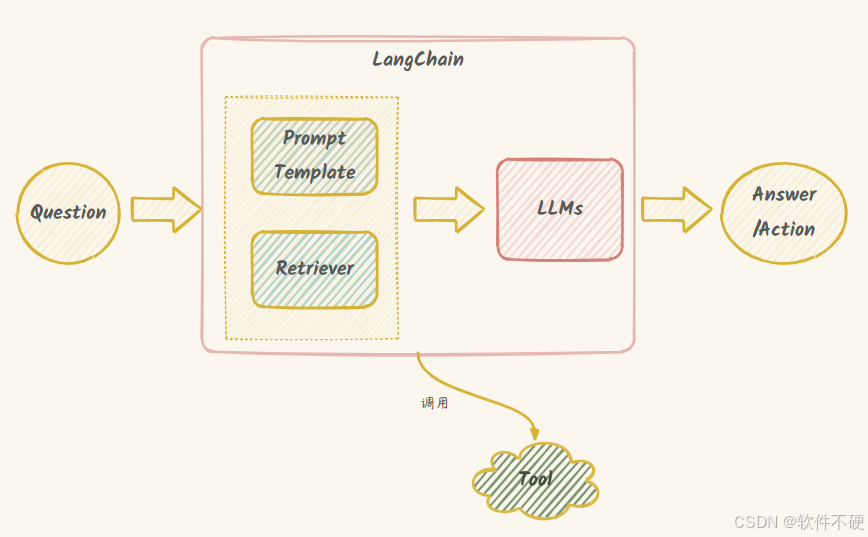
LangChain是一个开源框架,用于快速开发部署由LLM驱动的应用。LangChain使LLM不仅可以处理文本,还能够在更广泛的环境中进行操作和响应,从而扩展LLM的应用范围。如果把LLM比作CPU,那么LangChain类似于传感器。