


- @rmysjm


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
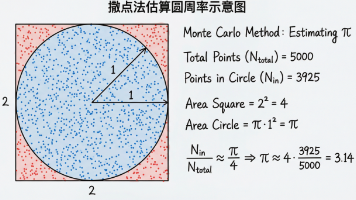
蒙特卡洛方法是一种利用随机试验解决复杂问题的数学方法。通过大量随机采样估算结果,适用于难以用传统方法求解的问题。文章通过不规则池塘面积估算和圆周率计算等生动例子,解释了该方法的核心思想:用随机试验的成功比例推算答案。蒙特卡洛方法在天气预报、金融投资等领域有广泛应用,虽结果不够精确但简单通用。文章还提供了Python代码示例,帮助读者理解实现过程。这种方法证明,有时"随机尝试"反
摘要:华为云推出的DevUI企业级前端解决方案与MateChat智能交互平台,构建了从视觉到智能的全链路技术生态。DevUI作为企业级前端"操作系统",提供Token驱动的主题系统、表单引擎和微前端适配,实现设计一致性。MateChat专注AI交互,支持大模型编排、知识库检索和工具调用,解决"AI孤岛"问题。二者深度融合后,通过JSON驱动组件渲染,将静态界

Kurator是华为云开源的分布式云原生平台,通过整合Karmada、KubeEdge、Volcano等主流开源项目,提供统一的多集群管理、调度、流量治理和监控能力。其创新在于构建统一抽象层,引入舰队(Fleet)概念简化运维,实现开箱即用的多云管理体验。Kurator显著提升应用部署效率约50%,资源利用率15-20%,同时避免厂商锁定。作为云原生新手入门工具,Kurator降低了分布式环境的学

摘要:2024-2025年是AI工程化落地的关键时期,但基础设施成为主要瓶颈。Kurator作为分布式云原生平台,通过整合Volcano调度器、Karmada多云编排和KubeEdge边缘计算,有效解决AI工程化的三大挑战:算力资源弹性调度、分布式训练复杂性和多云管理碎片化。平台支持大模型训练、边缘AI推理和MLOps实验平台等场景,显著提升资源利用率并降低成本。未来,Kurator有望通过增强A
Kurator:多云K8s集群管理的开源解决方案 Kurator是一个开源的分布式云原生管理平台,旨在解决企业多云Kubernetes集群管理中的痛点。它整合了Karmada、Istio、KubeEdge等优秀开源项目,提供了统一的管理层,简化了多云环境下的集群管理。 核心功能包括: Fleet抽象:可将多个集群组成舰队统一管理 跨集群应用分发:支持差异化配置部署 统一监控:集成Prometheu
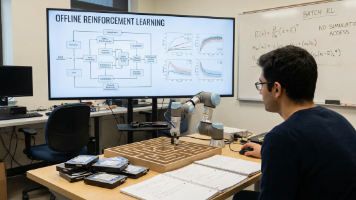
摘要:Offline RL正从理论走向工业应用,在推荐系统、工业控制和医疗领域取得突破。落地关键遵循"保守优先"原则,IQL因稳定性成为首选。Offline-to-Online微调面临性能骤降挑战,需平衡新旧数据比例。与大模型融合是前沿方向,DPO将RLHF简化为隐式Offline RL,Decision Transformer用序列建模替代Q-learning。开放问题包括数
摘要: Deep Folding利用深度神经网络实现蛋白质结构的端到端预测,解决了传统方法(如分子动力学和同源建模)计算复杂、精度不足的问题。其核心技术包括进化信息挖掘(MSA)、几何注意力机制和扩散模型,能高效预测蛋白质、DNA等分子的三维结构及相互作用。2025年的前沿方向涵盖动力学预测、逆向蛋白质设计及语言模型应用。Deep Foldin作为AI for Science的典范,大幅加速生命科
本文通过数学推导对比了标准卷积、深度可分离卷积(MobileNet)、分组卷积(ShuffleNet)和Ghost Module的计算差异。标准卷积计算量为H×W×Cin×Cout×K²,而深度可分离卷积将其分解为Depthwise和Pointwise两步,计算量约为标准卷积的1/9。分组卷积通过将通道分组使计算量降为1/g。Ghost Module利用特征图冗余性,通过生成少量本征图和大量幻影图
摘要:SE-Block是一种创新的通道注意力机制,通过Squeeze-Excitation操作自动学习特征通道的重要性权重。其核心包括全局平均池化获取通道信息、全连接层学习通道间关系,最后对特征通道进行加权。该方法以极小的计算开销(仅增加0.26%参数量)显著提升模型性能,如SE-ResNet50在ImageNet上的Top-1错误率降低1.5%。SE-Block证明了注意力机制在特征筛选中的有效
XGBoost是一种高效的梯度提升决策树算法,在结构化数据领域占据统治地位。本文从直觉理解、数学原理和工程实现三个层面深入解析XGBoost:1) 通过Boosting思想逐步修正预测误差;2) 创新性地引入二阶泰勒展开优化目标函数,并加入正则化项防止过拟合;3) 采用特征预排序、加权分位数略图等工程优化实现高速训练。实战部分展示了Python代码实现乳腺癌分类案例,并提供了详细的调参指南,包括结