


- @qq_45398836


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
拿图 3 中的顶点 V1 来说,通过构建好的十字链表得知,以该顶点为弧头的顶点只有存储在数组中第 3 位置的 V4(因此该顶点的入度为 1),而以该顶点为弧尾的顶点有两个,分别为存储数组第 1 位置的 V2 和第 2 位置的 V3(因此该顶点的出度为 2)。而使用邻接表存储有向图时,通常各个顶点的链表中存储的都是以该顶点为弧尾的邻接点,因此通过统计各顶点链表中的节点数量,只能计算出该顶点的出度,而

遍历的概念想必大家都不会陌生,即就是从链表的头开始,逐步向后进行每一个元素的访问,这就是遍历,对于遍历操作,我们可以衍生出很多常用的数据操作,比如说查询元素,修改元素,获取元素个数,打印整个链表数据等等。删除元素要建立一个前驱结点和一个当前结点,当找到了我们需要删除的数据时,直接使用前驱结点跳过要删除的结点指向要删除结点的后一个结点,再将原有的结点通过free函数释放掉。以上的操作均用到了遍历的思
本篇文章将向您介绍循环单/双链表的插入、删除、遍历操作原理及如何进行,文章最后会给正在学习链表操作的小伙伴提供两道力扣经典习题,后附参考代码。
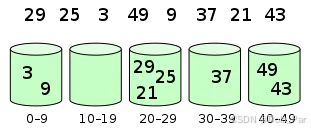
计数排序的核心在于将输入的数据值转化为键存储在额外开辟的数组空间中。作为一种线性时间复杂度的排序,计数排序要求输入的数据必须是有确定范围的整数。
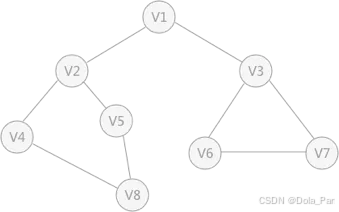
前面已经给大家介绍了有关生成树和生成森林的有关知识,本节来解决对于给定的无向图,如何构建它们相对应的生成树或者生成森林。其实在对无向图进行遍历的时候,遍历过程中所经历过的图中的顶点和边的组合,就是图的生成树或者生成森林。图 1 无向图例如,图 1 中的无向图是由 V1~V7 的顶点和编号分别为 a~i 的边组成。当使用深度优先搜索算法时,假设 V1 作为遍历的起始点,涉及到的顶点和边的遍历顺序为(

本节介绍了两种遍历图的方式:深度优先搜索算法和广度优先搜索算法。深度优先搜索算法的实现运用的主要是回溯法,类似于树的先序遍历算法。广度优先搜索算法借助队列的先进先出的特点,类似于树的层次遍历。
问题二的核心思想是记录处理,处理方式是:记录顶点在"最小生成树"中的终点,顶点的终点是"在最小生成树中与它连通的最大顶点"。然后每次需要将一条边添加到最小生存树时,判断该边的两个顶点的终点是否重合,重合的话则会构成回路。在剩下的所有未选取的边中,找最小边,如果和已选取的边构成回路,则放弃,选取次小边。c)继续寻找权值最小的边,将两个顶点之间连接起来,如果选择的边使得最小生成树出现了环路,则放弃该边

其次,将刚才合成的数据作为右孩子,左孩子从未处理的数据中选出最小的一个,作为左孩子,他们的根同样为左右孩子的权值和。由上文的分析可知,构建哈夫曼树时,我们需要根据各个结点的权重值,筛选出其中值最小的两个结点,构建二叉树。霍夫曼编码是一种无前缀编码。不断重复上述的步骤,直到将所有的数据全部处理完并构建出二叉树,这棵二叉树就是我们的哈夫曼树。首先,选出我们数据中最小的两个数据,构建成二叉树的左孩子和右

一般翻译做散列、杂凑,或音译为哈希,是一个典型的利用空间换取时间的算法,把任意长度的输入(又叫做预映射pre-image)通过散列算法变换成固定长度的输出,该输出就是散列值。
本篇文章主要介绍虚拟机软件下载流程及安装步骤。
