- @qq_42166929


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
如标题所言,创建GraphFrame,会出现Py4JJavaError: An error occurred while calling o138.loadClass.: java.lang.ClassNotFoundException: org.graphframes.GraphFramePythonAPI这个问题在国内搜了半天没见有用的解决方案,最后在stackoverflow上找到了...
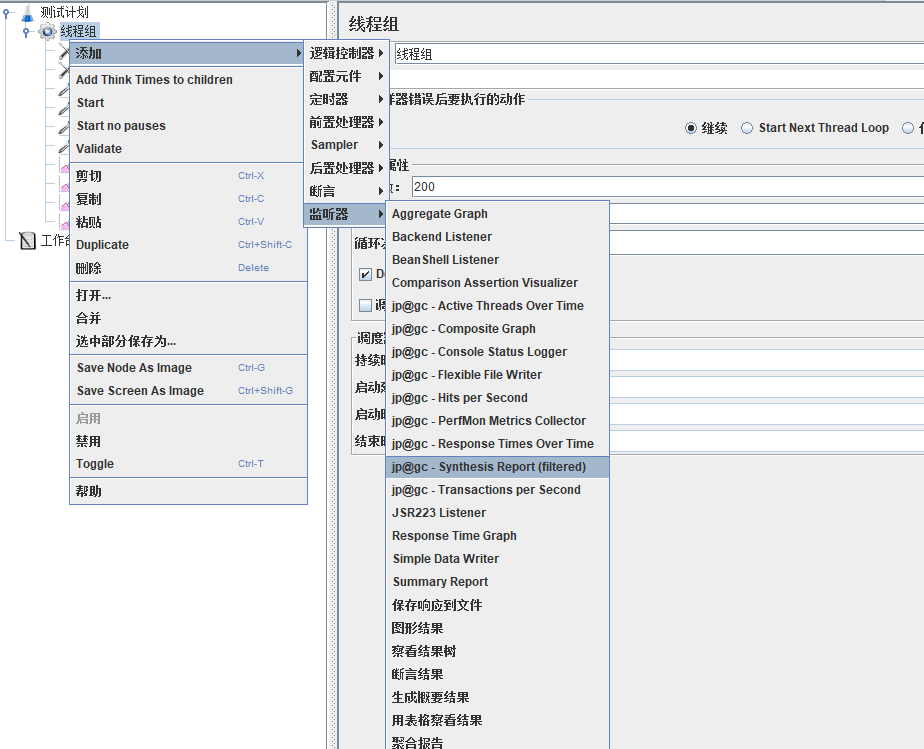
一、性能工具的安装部署1、下载JMeterPlugins-Standard-1.4.0.zip的安装包2、解压JMeterPlugins-Standard-1.4.0.zip,将其中\lib\ext\JMeterPlugins-Standard.jar包复制到jmeter安装目录下的\lib\ext下;3、重启jmeter,选择监听器,我们可以看到监听器中多了一些东西(这里边就有我们监控要用到的功
一:打开Windows子系统由于现在网上的安装方法都是装在C盘,且执行lxrun /install /y安装的过程会出现“lxrun’ 不是内部或外部命令,也不是可运行的程序 或批处理文件”因此按照此方法可以完美安装ubantu打开设置——选择更新与安全打开开发者选项–打开开发者人员模式打开程序和功能打开启用或关闭Windows功能勾选适用于Linux的Windows子系统,然后确认并重启就可以了
非结构化数据和结构化数据的提取2.1 正则表达式RE模块什么是正则表达式正则表达式匹配规则Python 的 re 模块re 模块的一般使用步骤如下:compile 函数match 方法search 方法findall 方法finditer 方法split 方法sub 方法匹配中文注意:贪婪模式与非贪婪模式2.2 案例:使用正则表达式的爬虫2.3 Xpath与lxml库什么是XMLXML 和 HTM
使用PySpark的机器学习1.创建特征2. 使用字符串索引3.分类算法*1. 贝叶斯分类器**2. 多层感知器分类**3.决策树分类*4.回归模型1.线性模型2. 决策树回归*3. 梯度增强决策树*分类和回归ML库在Spark的帮助下,从UCI机器学习知识库开源数据集。iris数据集(https://archive.ics.uci.edu/ml/machine-learning-database
Deployment failed: repository element was not specified in the POM inside…(已解决)都搜到这里了你可以不用看其他文章了出现这个原因无非是想在本地的pom文件配置好之后,执行deploy命令,可以将maven所打的jar包上传到远程的repository,便于其他开发者和工程共享。但是!!!!!!你自己本地都没有!!!dist
机器学习实战预测婴儿出生率1.加载数据2.数据的探索:特征相关性3.统计校验4.创建最后的待训练数据集5.划分训练集和测试集6.开始建模7.Logistic 回归模型8.选取出最具代表性的分类特征9.随机森林模型机器学习是通过算法对训练数据构建出模型并对模型进行评估,评估的性能如果达到要求就拿这个模型来测试其他的数据,如果达不到要求就要调整算法来重新建立模型,再次进行评估,如此循环往复,最终获得满
第一章:数据清洗常用工具1.numpy常用数据结构常用清洗工具:numpy常用数据结构:Numpy常用方法数组访问方法练习(jupyter)代码下面是结果2.Numpy常用数据清洗函数数据的排序数据的搜索练习(jupyter)代码下面是结果3.Pandas常用数据结构series和dataframeseriesdataframe常用方法练习(jupyter)代码下面是结果1.numpy常用数据结构
数据清洗之数据转换日期数据格式处理练习字符串数据处理练习高阶函数数据处理练习数据集地址:https://pan.baidu.com/s/1kMH1AhE8RUyaT73rvJsVPQ提取码:aai6日期数据格式处理练习import numpy as npimport pandas as pdimport osos.chdir(r'G:\pythonProject\pc\Python数据清洗\dat
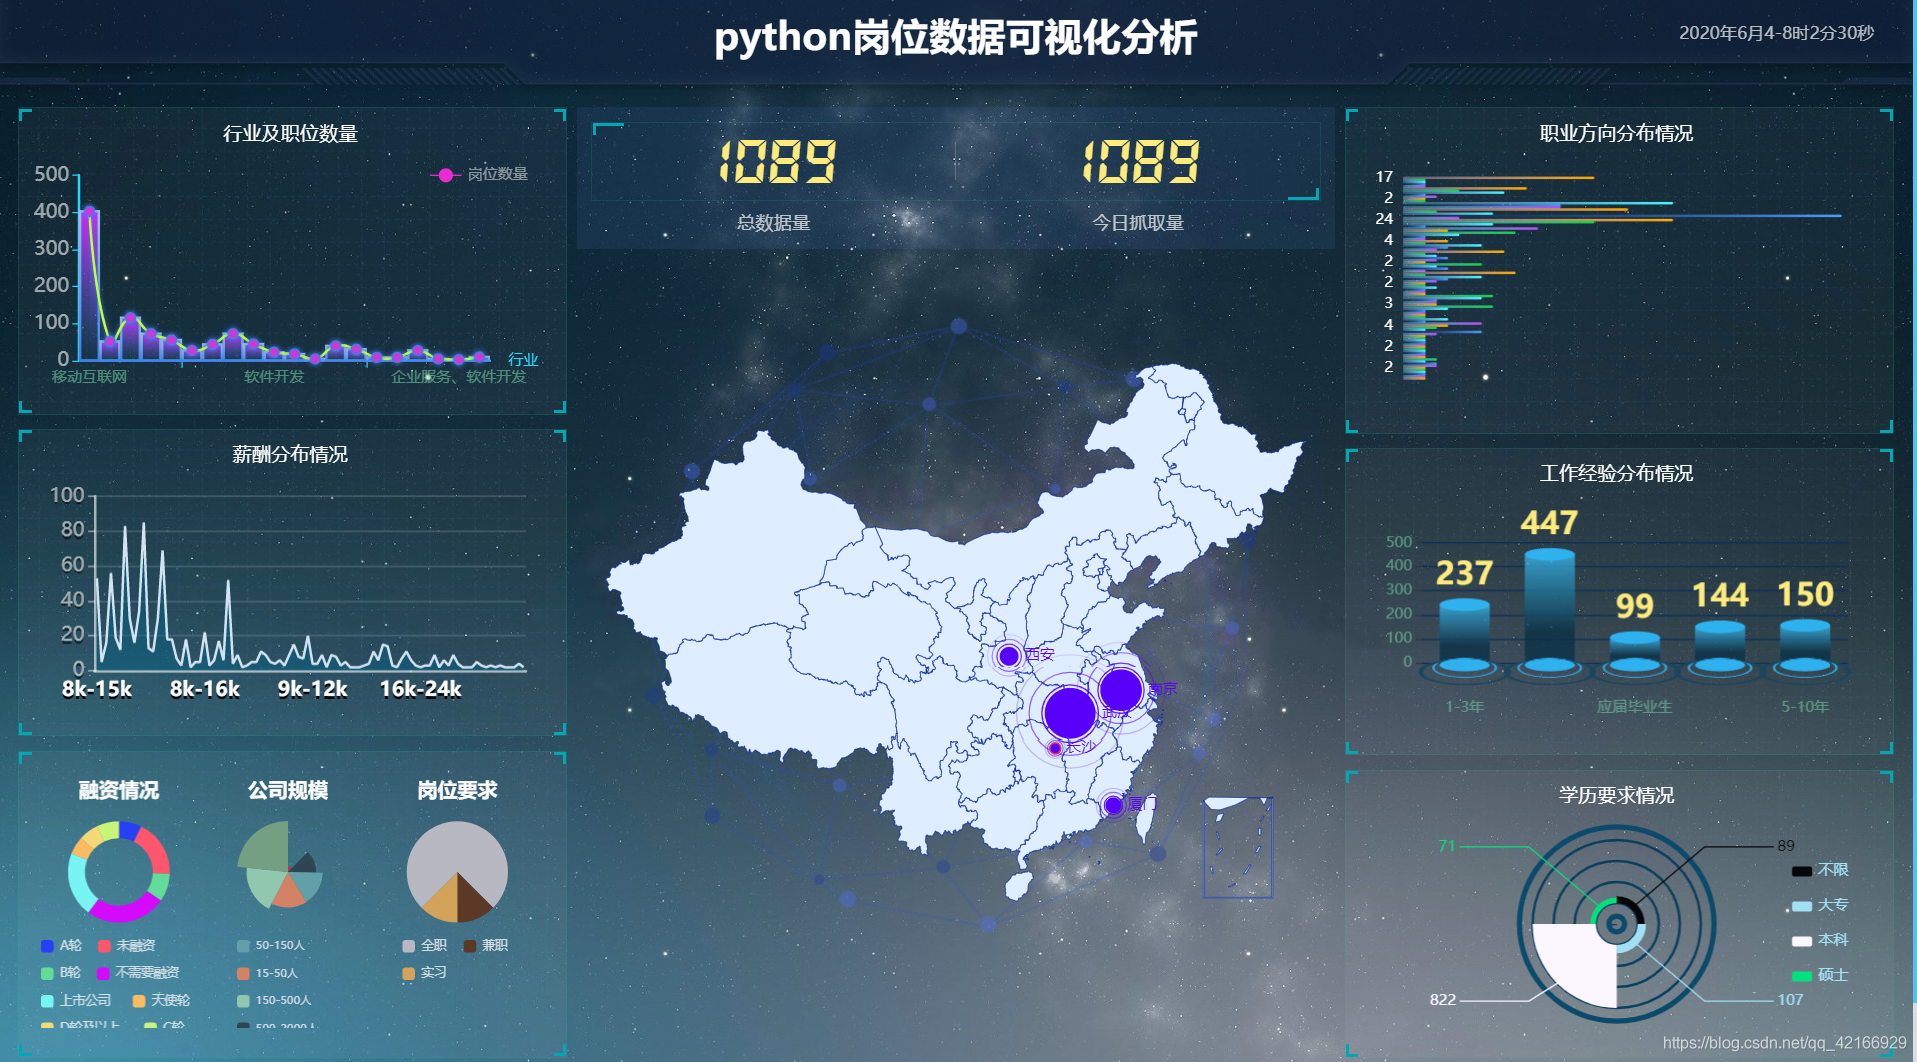
python招聘信息与岗位分析数据可视化第一部分(数据获取)1.数据库表创建2.数据爬取入库3.数据存储与查询第二部分(前端展示)第三部分(flask web应用)首先查看目录树第一部分(数据获取)1.数据库表创建首先通过python的sqlalchemy模块,来新建一个表。creat_lagou_tables.pyfrom sqlalchemy import create_engine, Int