


- @qq_38614074


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
🏙️浦东新区:超级人口引擎,引领全市⭐松江、嘉定:五大新城双星闪耀,人口增长新极点🏢中心城区:保持稳定,徐汇异军突起🌳生态涵养区:虹口、奉贤、崇明、金山,绿色发展特别值得注意的是,松江区凭借G60科创走廊的强劲动力,已超越嘉定成为五大新城人口第一;徐汇区在中心城区中表现抢眼,超越黄浦跻身前三。这些变化折射出上海人口正从"单中心"向"多中心"格局演变!人口是城市发展的基础,也是活力的源泉。未来
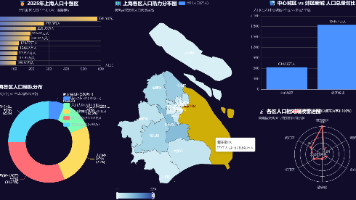
🏙️浦东新区:超级人口引擎,引领全市⭐松江、嘉定:五大新城双星闪耀,人口增长新极点🏢中心城区:保持稳定,徐汇异军突起🌳生态涵养区:虹口、奉贤、崇明、金山,绿色发展特别值得注意的是,松江区凭借G60科创走廊的强劲动力,已超越嘉定成为五大新城人口第一;徐汇区在中心城区中表现抢眼,超越黄浦跻身前三。这些变化折射出上海人口正从"单中心"向"多中心"格局演变!人口是城市发展的基础,也是活力的源泉。未来
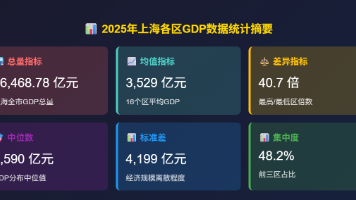
2025年上海各区GDP数据展现了"一核引领、多极支撑"的区域经济格局。浦东新区作为绝对龙头,引领全市经济发展;黄浦、静安等中心城区形成高端服务集群;五大新城和郊区正成为新的增长极。各区应根据自身定位和资源禀赋,在保持特色的同时,加强区域协同,共同推动上海建设具有世界影响力的社会主义现代化国际大都市!本文数据来源于上海市各区统计局公布的2025年GDP数据,可视化图表由Pyecharts生成,分析
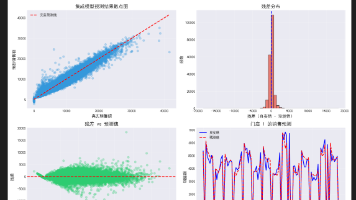
纽约出租车费预测是Kaggle上的一个经典回归预测问题。目标是根据出租车行程的起始时间、起终点经纬度坐标和乘客数量,预测出租车费用。这是一个典型的监督回归机器学习任务。通过本项目的完整实践,我们:✅数据探索:发现并处理了多种异常值✅特征工程:构建了空间、时间等多维度特征✅模型构建:实现了从基线到优化的全流程✅业务洞察:揭示了影响出租车费的关键因素最终成绩验证集RMSE:3.37美元相对于基线提升:

是Kaggle平台上的经典金融风控竞赛。竞赛任务是:基于匿名化的客户特征数据,预测客户未来是否会进行特定交易。数据集特点匿名性:200个特征全部匿名处理,名为var_0到var_199不平衡性:正样本(会交易)仅占10.05%大规模:20万条训练数据,20万条测试数据金融属性:反映了真实的银行客户行为模式🎯 性能提升:AUC分数从基准模型的0.7948提升到0.8686,相对提升约7.38%🔧
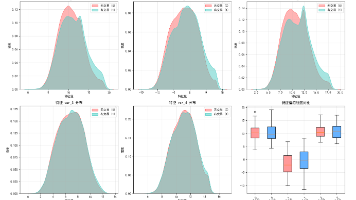
德国最大连锁药店Rossmann的销售预测挑战,不仅考验我们的机器学习技能,更是一场时间序列分析的盛宴。当1115家门店的未来6周销售预测摆在面前,我们该如何从历史数据中挖掘出销售规律?罗斯曼(Rossmann)是欧洲领先的连锁药店品牌,在7个欧洲国家经营着3000多家药店,Rossmann Store Sales竞赛的核心目标:基于844,392条历史销售记录,预测德国1115家Rossmann
项目核心总结print("项目总结与改进建议")# 业务结论"1. 核心影响因素:吸烟是保费的第一决定因素(相关性0.79),其次是年龄和BMI","2. 风险组合效应:吸烟+肥胖+高龄的客户保费最高,是保险公司高风险客群","3. 模型性能:梯度提升回归最优,测试集R²达0.87,平均预测误差约3000美元","4. 特征价值:交互特征(如年龄×吸烟)能显著提升模型预测能力","5. 数据规律:
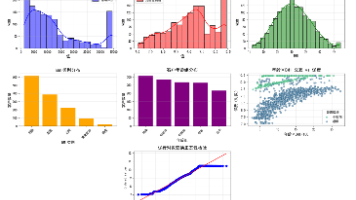
洪水作为全球发生频率最高、影响范围最广的自然灾害之一,每年造成数以百亿计的经济损失和大量人员伤亡。传统的洪水预警多依赖于水文监测站的实时数据和经验判断,存在预警滞后、覆盖范围有限、精准度不足等问题。本项目旨在通过机器学习技术,整合环境、人为、基础设施、社会经济等多维度数据,构建高精度的洪水概率预测模型。本项目使用的洪水预测数据集为专业气象与地理数据机构整理的结构化数据集,具备以下特征:探索性数据分

内外向人格是心理学中重要的人格特质之一。通过分析个人的社交行为模式,如独处时间、社交活动参与度等,可以预测其内外向性格倾向。本项目使用机器学习方法构建预测模型。id: 用户ID: 独处时间Stage_fear: 舞台恐惧程度: 社交活动参与度: 外出频率: 社交后是否疲惫: 朋友圈大小: 发帖频率: 人格类型(目标变量,0=内向,1=外向)
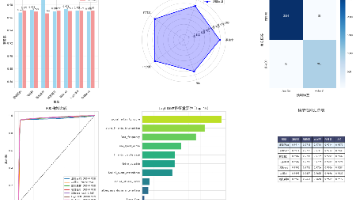
XGBoost残差修正模型# 准备XGBoost的输入数据# 将3D序列数据展平为2D特征矩阵# 定义XGBoost模型# train_residuals是:train_data-lstm_pred_data# 训练XGBoost模型# 使用XGBoost预测残差# 计算融合预测结果: LSTM+XGBoost残差数据生成功能:无需准备额外数据,可直接运行残差学习机制:XGBoost专门学习LST
