


- @m0_62396717


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
摘要:本文介绍了删除链表倒数第n个节点的两种方法。双指针法是更优解,通过快指针先走n+1步,然后快慢指针同步移动,当快指针到达末尾时慢指针正好指向要删除节点的前驱节点,实现一次性遍历删除。虚拟头节点的使用简化了边界处理(如删除头节点的情况)。另一种计算链表长度的方法需要两次遍历。时间复杂度均为O(L),但双指针法效率更高。文中详细解释了算法原理、边界条件处理,并提供了Python实现代码。

摘要:本文给出了寻找链表环入口节点的两种解法。哈希表法通过存储访问过的节点,空间复杂度O(n);快慢指针法使用双指针技巧,先判断环存在,然后根据数学推导(a=(k-1)(b+c)+c)重置指针找到入口,空间复杂度O(1)。快慢指针法满足题目"不修改链表"的要求,是更优解。两种方法时间复杂度均为O(n),但快慢指针在空间效率上更优,适合对空间有限制的场景。

本文系统梳理了网络安全渗透测试的核心技术框架,主要包含六个方面:1. 短信验证码绕过技术,包括爆破、回显、未绑定认证等漏洞利用;2. Fuzz模糊测试方法;3. 信息收集技术,区分主动/被动收集方式;4. 域名与IP信息收集,涵盖WHOIS查询、CDN绕过、端口扫描等;5. 网站指纹识别技术,涉及操作系统、中间件、CMS等识别;6. WAF识别与绕过。文中详细介绍了各类工具使用方法和漏洞利用原理,

本文探讨了自然语言处理中的词表示方法和自注意力机制。首先介绍了两种词表示方式:独热编码(简单但缺乏语义信息)和词向量(低维稠密且蕴含语义)。重点分析了自注意力机制的工作原理,包括其并行计算优势和位置不变性特点。针对位置信息缺失问题,详细阐述了基于三角函数的位置编码方法,说明其如何保持相对位置关系。最后通过代码示例展示了位置编码的实现方式,并比较了不同位置编码方案的优劣。文章指出自注意力虽具并行优势

本文介绍了求解盛水容器最大面积问题的两种方法。暴力枚举法通过双重循环计算所有可能的容器组合面积,时间复杂度为O(n²),空间复杂度O(1)。更优的双指针法则从数组两端开始,每次移动较矮的指针,在O(n)时间内找到最优解。双指针法的正确性在于:移动短边可能获得更高高度来弥补宽度损失。以示例[1,8,6,2,5,4,8,3,7]为例,双指针法能高效计算出最大面积49。相比暴力法,双指针法更适合处理大规
摘要:大语言模型面临的越狱攻击正成为严峻安全威胁,指通过特殊提示词等手段绕过安全机制诱导模型输出有害内容。主要类型包括提示越狱攻击、模型操控攻击和间接攻击,可能导致信息泄露、放大偏见等危害。当前防御体系包含安全性训练、红队测试等多层措施,但面临多模态攻击、系统级风险等新挑战。AI安全需贯穿模型全生命周期,实现攻防动态平衡,确保技术向善发展。
定义:使用外部LLM接口处理企业或个人数据时,敏感、机密或者受保护的数据因模型提供商的安全漏洞、配置不当、内部人员滥用或恶意攻击等原因,未经过授权而被披露、访问、窃取或传输的问题。应对场景:适用于将LLM集成到产品或服务中的任何场景,尤其是在实时交互和用户生成内容的环境中,需要对LLM的输入与输出进行严格的审核与过滤。应对场景:适用于AI模型的开发与发布流程,在模型投入生产环境前,进行代码级别的安
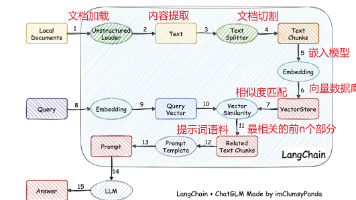
摘要:RAG(检索增强生成)技术能有效解决大模型的知识冻结和幻觉问题,通过检索外部知识提升回答准确率。RAG流程包括文件解析、切割、检索和重排序等难点环节,适用于高精度场景。Agent架构结合LLM、记忆、工具和规划能力,实现智能决策。大模型开发主要有纯Prompt、Agent+Function Calling、RAG和微调四种方式,其中RAG适合补充领域知识,而微调成本较高但能形成长期记忆。不同
Ollama是一个支持本地运行大模型的集成框架,主要用于LLaMA架构的开源模型。它支持跨平台部署(Mac/Linux/Windows),可自动下载和运行Qwen、Deepseek等主流模型。安装后,用户可通过命令行或图形界面交互,模型默认保存在C盘但可自定义路径。通过LangChain的ChatOllama模块可轻松调用本地模型(如deepseek-r1:8b),支持默认端口或自定义地址访问。O
本文介绍了LangChain中的Memory模块及其实现方式。Memory用于存储多轮对话的上下文信息,使大模型具备记忆能力。文章详细讲解了多种Memory组件:基础组件ConversationBufferMemory存储完整对话历史;ConversationBufferWindowMemory只保留最近K条对话;ConversationTokenBufferMemory基于token数量控制记忆
