


- @m0_57592634


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
简单的讲,数据倾斜就是我们在计算数据的时候,数据的分散度不够,导致大量的数据集中到了一台或者几台机器上计算,造成数据热点问题(数据倾斜的另一种说法),这些数据的计算速度远远低于平均计算速度,导致整个计算过程过慢(木桶效应)。map阶段数据倾斜现象:少数map任务比其他map任务结束的比较晚reduce阶段数据倾斜现象少数reduce任务比其他reduce任务结束的比较晚。

默认值是false,当有数据倾斜的时候进行负载均衡,生成的查询计划有两个MapReduce任务,第一个MR Job中,Map的输出结果会随机分布到Reduce中,每个Reduce做部分聚合操作,并输出结果,这样处理的结果是相同的Group By Key有可能被分发到不同的Reduce中,从而达到负载均衡的目的;第二个MR Job再根据预处理的数据结果按照Group By Key分布到Reduce中
打开 Spark UI,首先映入眼帘的是默认的 Jobs 页面。Jobs 页面记录着应用中涉及的 Actions 动作,以及与数据读取、移动有关的动作。其中,每一个 Action 都对应着一个 Job,而每一个 Job 都对应着一个作业。可以看到,导航条最左侧是 Spark Logo 以及版本号,后面则依次罗列着 6 个一级入口。每个入口的功能与作用如下的表格介绍序号入口页内容作用1JobsAct
下图展示Spark的五种连接计算方式,默认连接策略为ShuffleSortMergeJoin,适合大规模数据且无需广播,连接策略的选择核心在JoinSelection 类实现。左深树(Left-Deep Tree):树形结构向左倾斜,Join节点的右侧只能是叶子节点,很多数据库默认将左深树作为Join Reorder的搜索空间。右深树(Right-Deep Tree):树形结构向右倾斜,左深树的镜

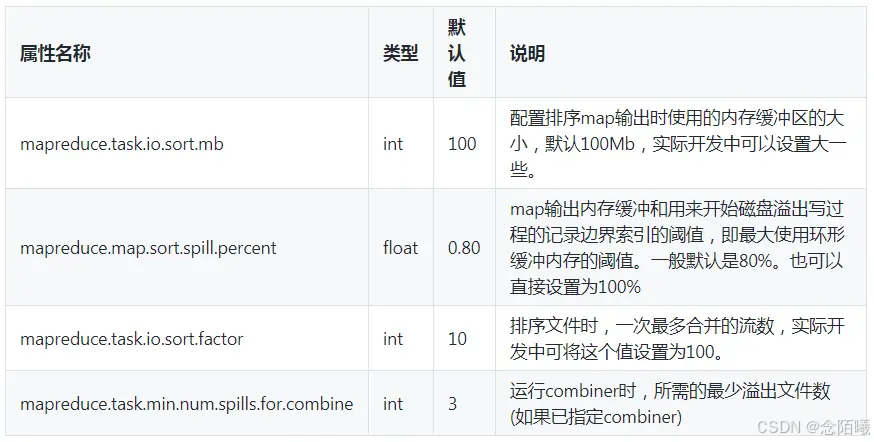
在 MapReduce 框架中, Shuffle 阶段是连接 Map 与 Reduce 之间的桥梁, Map 阶段通过 Shuffle 过程将数据输出到 Reduce 阶段中。由于 Shuffle 涉及磁盘的读写和网络 I/O,因此 Shuffle 性能的高低直接影响整个程序的性能。Spark 也有 Map 阶段和 Reduce 阶段,因此也会出现 Shuffle。

# 一、Flink 核心概念综述# 二、Flink 开发环境搭建# 三、Flink Data Source# 四、Flink Data Transformation# 五、Flink Data Sink# 六、Flink 窗口模型# 七、Flink 状态管理与检查点机制# 八、Flink Standalone 集群部署
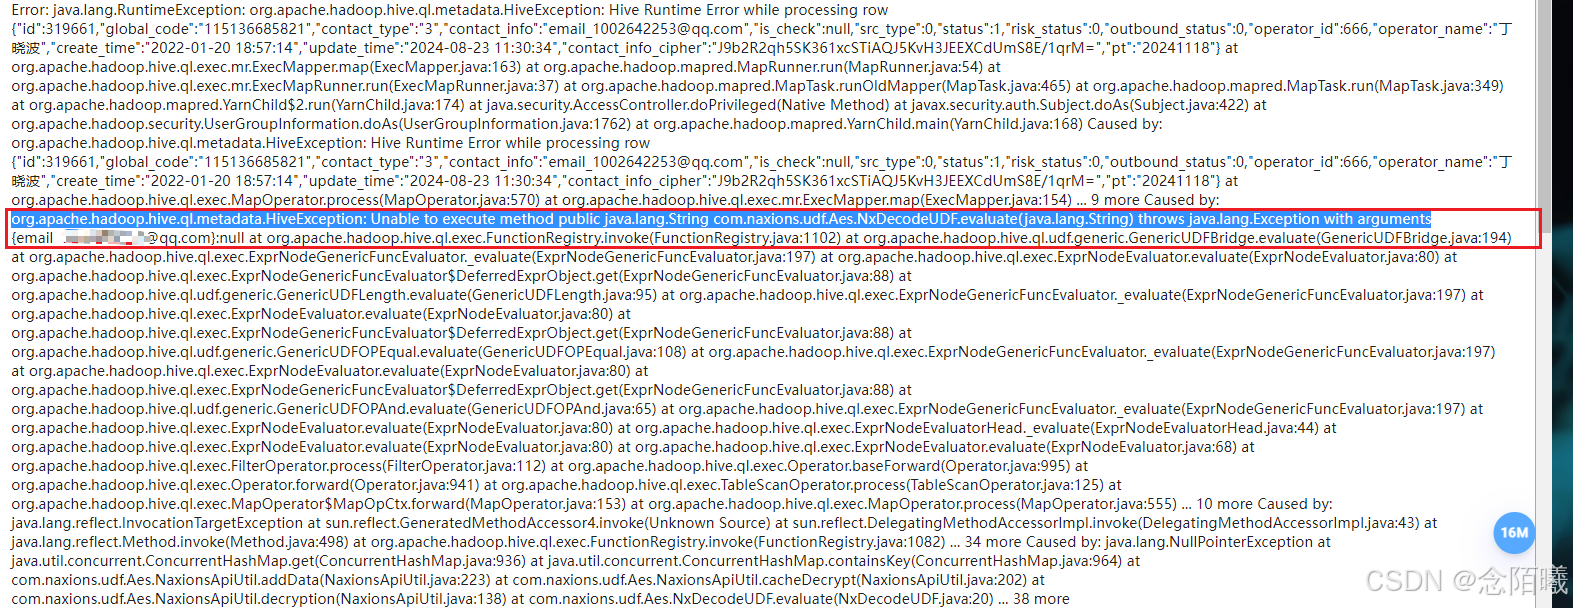
奇怪,数据不是被过滤掉了么,如下图,怎么还会传入最后的UDF函数报错。脚本执行,报错后查看Yarn执行日志,发现报错如。,大致原因是:自定义的UDF函数传入了错误的参数。被提前过滤,原因找到,应该是cbo自动优化导致。的条件过滤改在了在reduce阶段执行。在查找错误数据后发现错误数据的。
打开 Spark UI,首先映入眼帘的是默认的 Jobs 页面。Jobs 页面记录着应用中涉及的 Actions 动作,以及与数据读取、移动有关的动作。其中,每一个 Action 都对应着一个 Job,而每一个 Job 都对应着一个作业。可以看到,导航条最左侧是 Spark Logo 以及版本号,后面则依次罗列着 6 个一级入口。每个入口的功能与作用如下的表格介绍序号入口页内容作用1JobsAct