


- @hongchenshijie


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
错误详情java.lang.OutOfMemoryError: Unable to acquire 60 bytes of memory, got 0at org.apache.spark.memory.MemoryConsumer.allocatePage(MemoryConsumer.java:127)at org.apache.spark.util.collection.unsafe.sor
关闭hadoop集群时无意中使用 jps 发现dataNode 和 NodeManager 没关掉1.检查日志发现报错仔细看了一下关闭情况发现 多了个localhost于是打开/etc/hadoop/slaves这个配置文件vi ../etc/hadoop/slaves发现果然多了一个localhost 才想起以前配置的时候没有删除把localhost删除后保存退出jp...
文章目录1. 说明2. 依赖3. 详细代码1. 说明使用flink从中读取kafka中的json数据,然后把数据存储到elasticsearch7.9.1中并进行简单的校验.2. 依赖<?xml version="1.0" encoding="UTF-8"?><project xmlns="http://maven.apache.org/POM/4.0.0"xmlns:xsi="
文章目录一、环境的配置1. Hive开启MetaStore服务在 $HIVE_HOME/conf/hive-site.xml中添加如下配置2. 启动 metaStore 和 hiveserver23. SparkSQL整合Hive MetaStore拷贝 Hadoop 和 Hive 的配置文件到 Spark 的配置目录4. 把连接mysql 依赖的jar拷贝到 $SPARK_HOME/jars/
hive启动时 java.net.ConnectException:拒绝连接
准备工作:删除所有的 fsimage 文件和 edits 文件删除 fsimage 文件rm -rffsimage 文件存放地址例如:rm -rf /export/install/hadoop-2.6.0-cdh5.14.0/hadoopDatas/namenodeDatas/current/如果不知道fsimage文件在哪个目录下可以打开 hdfs-site.xml 文件查看 (...
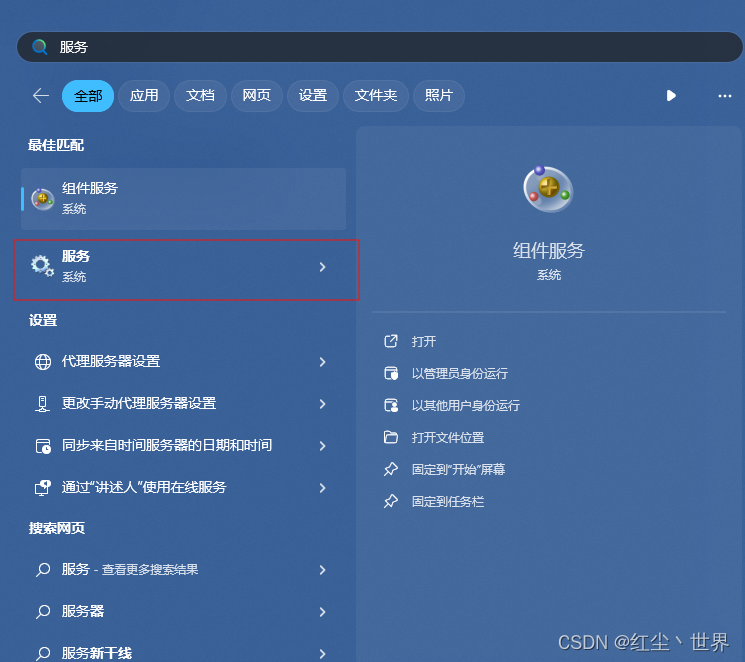
直接按 win 键输入“服务”
出现的错误:出错的原因:hadoop集群创建完成之后 namenode没有进行初始化解决方法以下均是在主节点操作我的hadoop安装目录是: /export/install/hadoop-2.6.0-cdh5.14.0/1.先关闭hadoop集群/hadoop的安装目录/sbin/stop-all.sh示例: /export/install/hadoop-2.6.0-cdh5...
logstash grok 规则
报错详情如下:org.apache.hadoop.hbase.client.RetriesExhaustedException: Failed after attempts=32, exceptions:Tue Dec 17 10:21:47 CST 2019, null, java.net.SocketTimeoutException: callTimeout=60000, callDura..