


- @WHYbeHERE


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
Power BI数据处理基础功能介绍:初始的数据调整转换、合并及查看数据分布
pip install --ignore-installed PyYAML先升级原来的pyyaml项目场景:提示:这里简述项目相关背景:例如:项目场景:示例:通过蓝牙芯片(HC-05)与手机 APP 通信,每隔 5s 传输一批传感器数据(不是很大)问题描述:提示:这里描述项目中遇到的问题:例如:数据传输过程中数据不时出现丢失的情况,偶尔会丢失一部分数据APP 中接收数据代码:@Overridepu
记录一下被屏蔽的解决方法。
交叉验证是什么?在模型建立中,通常有两个数据集:训练集(train)和测试集(test)。训练集用来训练模型;测试集是完全不参与训练的数据,仅仅用来观测测试效果的数据。一般情况下,训练的结果对于训练集的拟合程度通常还是挺好的,但是在测试集总的表现却可能不行。比如下面的例子:图一的模型是一条线型方程。 可以看到,所有的红点都不在蓝线上,所以导致了错误率很高,这是典型的不拟合的情况图二 的蓝线则更加贴
问题描述使用NLTK时,出现stopword资源找不到。解决方法在网上找到公开资源,下载文件后,解压到相应地址。解决方法博客链接查看地址路径:from nltk import dataprint(data.path)将下载的文件解压到下面目录里,没有文件夹的新建文件夹:我在解压时候没有这个目录,找到在/Users/mac/opt/anaconda3文件在目录下新建一个nltk_data文件夹;再在
Power BI windows下载安装流程
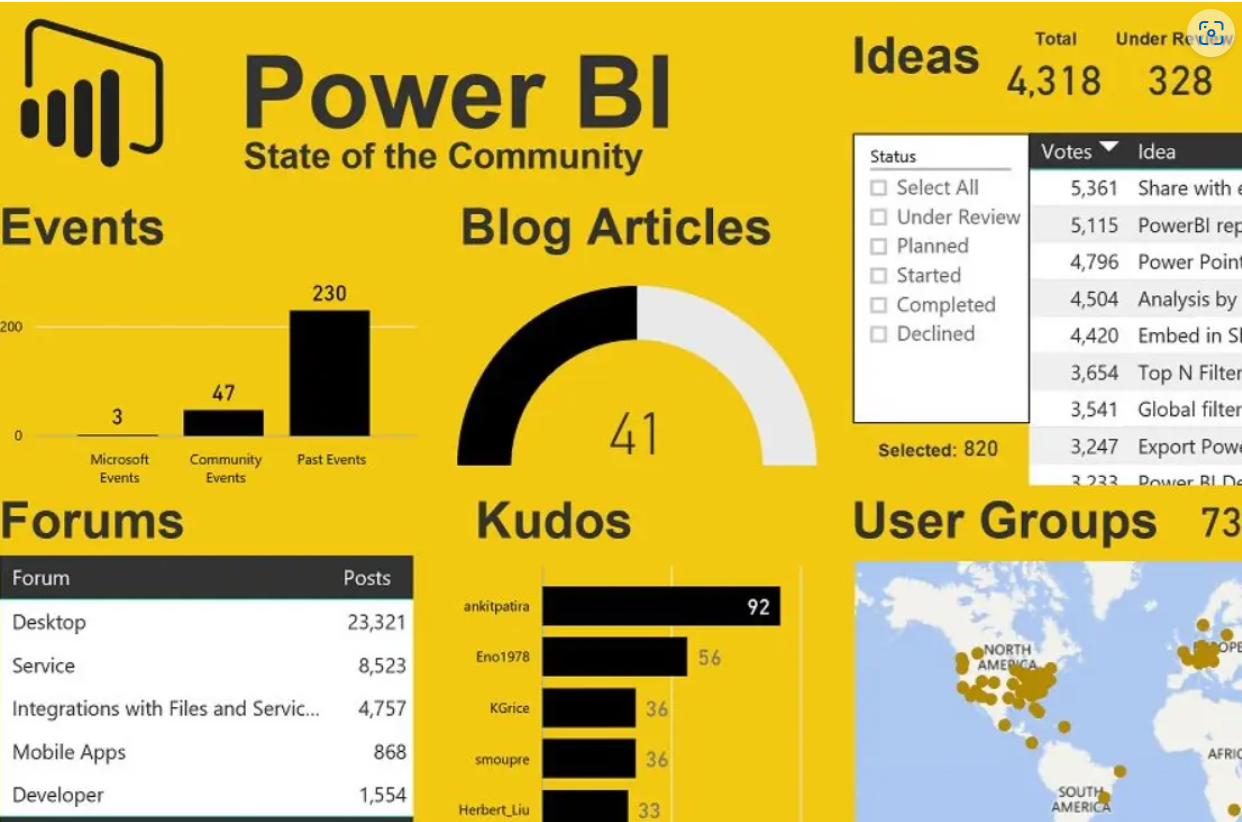
Power BI windows下载安装流程
本文根据西瓜书总结了一些关键知识点,介绍了集成学习的原理、类型以及结合策略。
主要介绍AIC、BIC的原理,对比其他模型评估方法和信息准则的不同,通过简单的线性回归例子展示AIC、BIC的计算。
Optuna是一个强大的开源工具,通过优雅的API设计和智能的搜索策略,可以显著提高调参的效率。本文将介绍Optuna的基本概念、使用方法以及与其他调参方式的对比。
