


- @Rabbit_QL


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
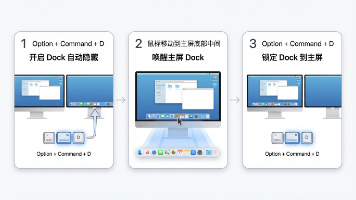
Mac外接显示器时Dock常会跑到副屏上,影响使用效率。解决方法:先按Option+Command+D开启Dock自动隐藏,再将鼠标移到主屏底部边缘唤出Dock,最后再次按下快捷键关闭自动隐藏。这个操作利用了macOS根据最近触发屏幕决定Dock位置的机制,通过"隐藏-主屏唤醒-固定"三步即可将Dock锁定在主屏。该方法简单有效,无需修改系统设置或重启,但需注意频繁在副屏操作仍
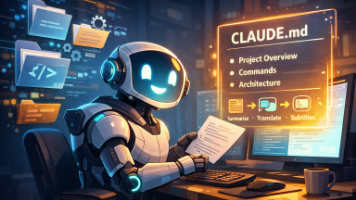
本文介绍了使用Claude CLI工具时的关键第一步——执行/init命令。文章指出,许多用户会直接让Claude优化代码,却忽略了初始化项目上下文的重要性。/init命令会引导Claude识别项目类型(如Git仓库、语言框架等),建立项目级上下文,从而避免后续出现理解偏差。执行该命令后,Claude会生成包含项目概览、架构说明等信息的文档,为后续协作提供基础。作者强调,先让Claude"
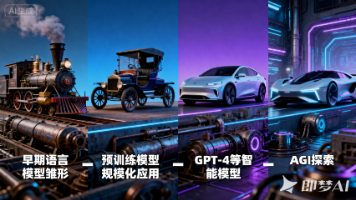
大模型token的增加,引发的思考
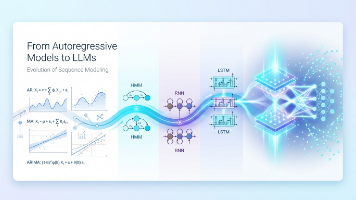
本文梳理了自回归模型到大语言模型(LLM)的技术演化。文章指出:传统 AR/ARIMA 通过“利用过去预测未来”奠定序列建模基础;RNN/LSTM 继承自回归思想并增强非线性表达;Transformer 则以注意力机制突破长依赖限制,并在因果 Mask 下继续采用自回归训练。最终,现代 LLM 本质上仍是自回归序列模型的规模化进化。理解自回归,是理解 LLM 的关键起点。
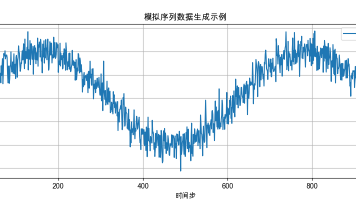
通过这篇博客,读者可以掌握从特征构建、单步预测、多步预测到隐变量AR建模的完整流程,并理解预测误差随步数增长的原理,为时间序列建模与分析提供参考。
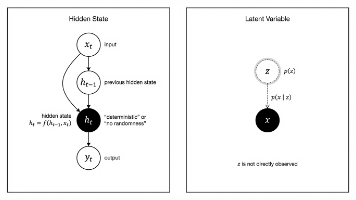
摘要: 神经网络中的hidden与概率模型中的latent虽均译为“隐”,但本质不同。Hidden是确定性中间表示(如RNN的$h_t$),通过前向传播直接计算;而latent是未观测的随机变量(如VAE的$z$),需通过推断(如后验分布)估计。关键区别在于:hidden是函数计算的确定值,latent是概率建模的随机变量。混用源于中文翻译相同及模型交叉(如VAE同时包含两者),但数学地位截然不同
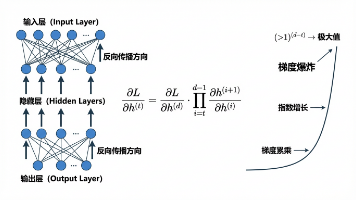
本文深入解析了深度学习中的梯度爆炸问题。梯度爆炸指反向传播时梯度值指数级增长,导致数值溢出和训练不稳定。其核心原因是深层网络梯度链式乘积中权重矩阵范数大于1时的累乘效应,尤其在ReLU激活函数下梯度路径筛选会放大该问题。数学推导和实验表明,即使初始梯度正常,连续矩阵相乘也会快速引发数值爆炸。梯度爆炸会导致浮点数溢出、参数更新失控等问题,严重影响模型训练。理解这一现象的成因有助于设计更稳定的网络结构
摘要: 深度神经网络训练中的数值稳定性问题常导致梯度消失或爆炸,表现为loss异常、参数更新停滞等。数值不稳定源于多层计算的连续叠加效应——前向传播中微小偏差被放大或压缩,反向传播中梯度尺度不断变化。这种尺度偏移并非单层异常,而是多层累积的结果。理解数值稳定性是解决训练不稳定的关键,需从计算过程而非单纯调参角度分析。后续将探讨反向传播中梯度的具体传播机制与尺度问题的形成过程。(149字)
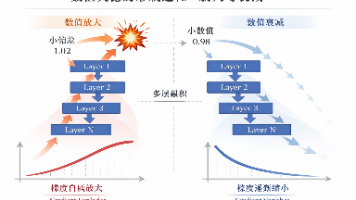
本文从反向传播的机制出发,分析了深度神经网络中梯度爆炸和梯度消失问题的本质。文章指出,这两种现象并非独立问题,而是梯度在多层连续计算中被不断缩放后的两种极端表现。当每一层对梯度的缩放作用略大于1时,多层叠加会导致梯度指数级增长(爆炸);当缩放作用略小于1时,梯度会逐渐衰减至消失。深度网络的连乘效应放大了单层计算的微小偏差,使梯度稳定性变得极其敏感。理解这一统一视角是解决神经网络训练稳定性问题的关键