


- @NCU_wander


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
在不显著损失“捕捉长期依赖、缓解梯度问题”核心能力的前提下,通过结构简化实现“轻量、高效、稳健、易落地”。它不是LSTM的“替代品”,而是“优化版”——适合大多数常规序列任务(文本分类、短序列预测、实时推理、小数据集场景);只有在极长序列(如1000+时间步的长文本生成)或对记忆精度要求极高的场景(如复杂机器翻译),LSTM才略占优势,但GRU仍是工程实践中的“首选”,因为它能以更低的成本达到接近
pdb是一款非常常用的编辑利器,之前有陈东大佬使用这个加快程序开发的进度,目前另一名同事也在使用pdb进行断点调试,调试速度与质量远远高于个人常用的print语句。后期要迅速且大胆的开展运用,将这个利器尽快应用于工作实践。python -m pdbnb evaluation.py:15clqs...
etc/profile :所有用户有效的配置文件~/.bashrc或~/.bash_profile :当前用户有效配置文件1、在PATH中找到可执行文件程序的路径。export PATH=$PATH:/opt/rh/devtoolset-3/root/usr/bin/export PATH=$OPENSSL:$PATH:$HOME/binexport PATH=$PATH:/usr/lo...
导航是现代生活必不可少的基础设施,大到俄乌冲突导弹互相暴揍,小到出门游玩,都离不开导航功能。我们常说导航,但是导航这一功能的核心是定位。沿着定位这条线我们开始本篇文章的内容。

验证加速核心:大模型通过「1次并行批量验证K个Token」替代「K次串行生成Token」,单批次验证耗时远小于逐Token生成总耗时;额外保障:小模型生成草稿的耗时极低,回滚机制仅修正错误不重复计算,进一步放大加速效果;关键结论:验证阶段的“批量并行”是投机解码(MTP)提速的核心,也是为什么“验证K个Token”比“生成K个Token”快一个数量级的根本原因。
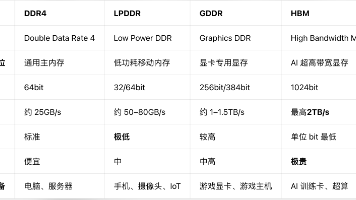
近期存储行情大涨,我们借这个机会完成对存储芯片的扫盲工作。先从存储的分类开始,无论何种存储芯片,都属于以下三种:1、Volatile Memory(易失性存储)断电丢数据,速度极快,做运行内存。2、Non-Volatile Memory(非易失性存储)断电不丢数据,长期存文件。3、Special Storage(专用存储)特定场景用,比如缓存、桥接、安全存储。
深度学习算法的效果离不开高质量数据集,因此在此对项目中用到的经典数据集进行梳理,本帖长期更新。1、TID2008TID2008是由乌克兰国家航空航天大学的N504信号接收、传输与处理系建立,包括25幅参考图像,四种不同变换幅度,1700幅失真图像。失真类型有17种包括:加性高斯噪声、颜色分量强于照明分量的加性噪声、空间位置相关噪声、掩膜噪声、高频噪声、脉冲噪声、量化噪声、高斯模糊、图像噪声、J..
第一张图是比较经典的RAG知识图谱,第二张图是更加详细扎实的介绍图。

PagedAttention 架构:vLLM 的核心设计就是围绕 KV Cache,没有 KV Cache,vLLM 就无法进行高效 decode,Decode 阶段必然依赖 KV Cache。enable-prefix-caching参数控制的是:不同请求之间不会共享 KV Cache,多轮聊天中:每一轮都会重新计算前缀的 KV,TTFT 会更高。在 vLLM中:KV Cache 是强制开启的基
在传统序列模型(如 RNN 或 LSTM)中,模型处理文本时必须像人类看书一样,从左到右逐字读取。由于隐藏状态(Hidden State)的容量有限,随着句子变长,前面的信息会被后面的信息逐渐“冲淡”,这就是经典的长距离依赖问题(Long-Range Dependency)。2017 年,Google 在论文中彻底颠覆了这一模式,提出了Self-Attention(自注意力)机制。消除时序的先后顺