


- @Lzx116


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
List functioncurrent_date()当前日期now() 或 current_timestamp() 当前时间datediff(endDate, startDate)日期相差天数months_between(endDate, startDate)日期相差月数date_add(startDate, numDays)日期加N天date_sub(startDate, numDays)日期
业务那边给了个需求,我们这边完成的话需要两个表进行join操作,小表(4800万条)大表(26亿条)。典型的小表和大表join,首先想到的就是 Broadcast Join对其进行一个最佳处理。
数仓之缓慢变化维拉链表解决方式

给一个表添加协处理器导致生产hbase集群挂掉重启之后出现rit问题,刺激!
我们有两个集群(ps:计算集群/存储集群),现在有个需求就是,计算集群运行Spark任务,从kafka取数据写到存储集群的hive。1,在远程连接Hive时Hive有两种服务Hive Metastore Server和HiveServer2HiveServer2是JDBC连接,使用这种方式会占用数据本地集群的计算资源(常用默认端口10000的那种)2,Spark连接Hive可以使用Hive Met
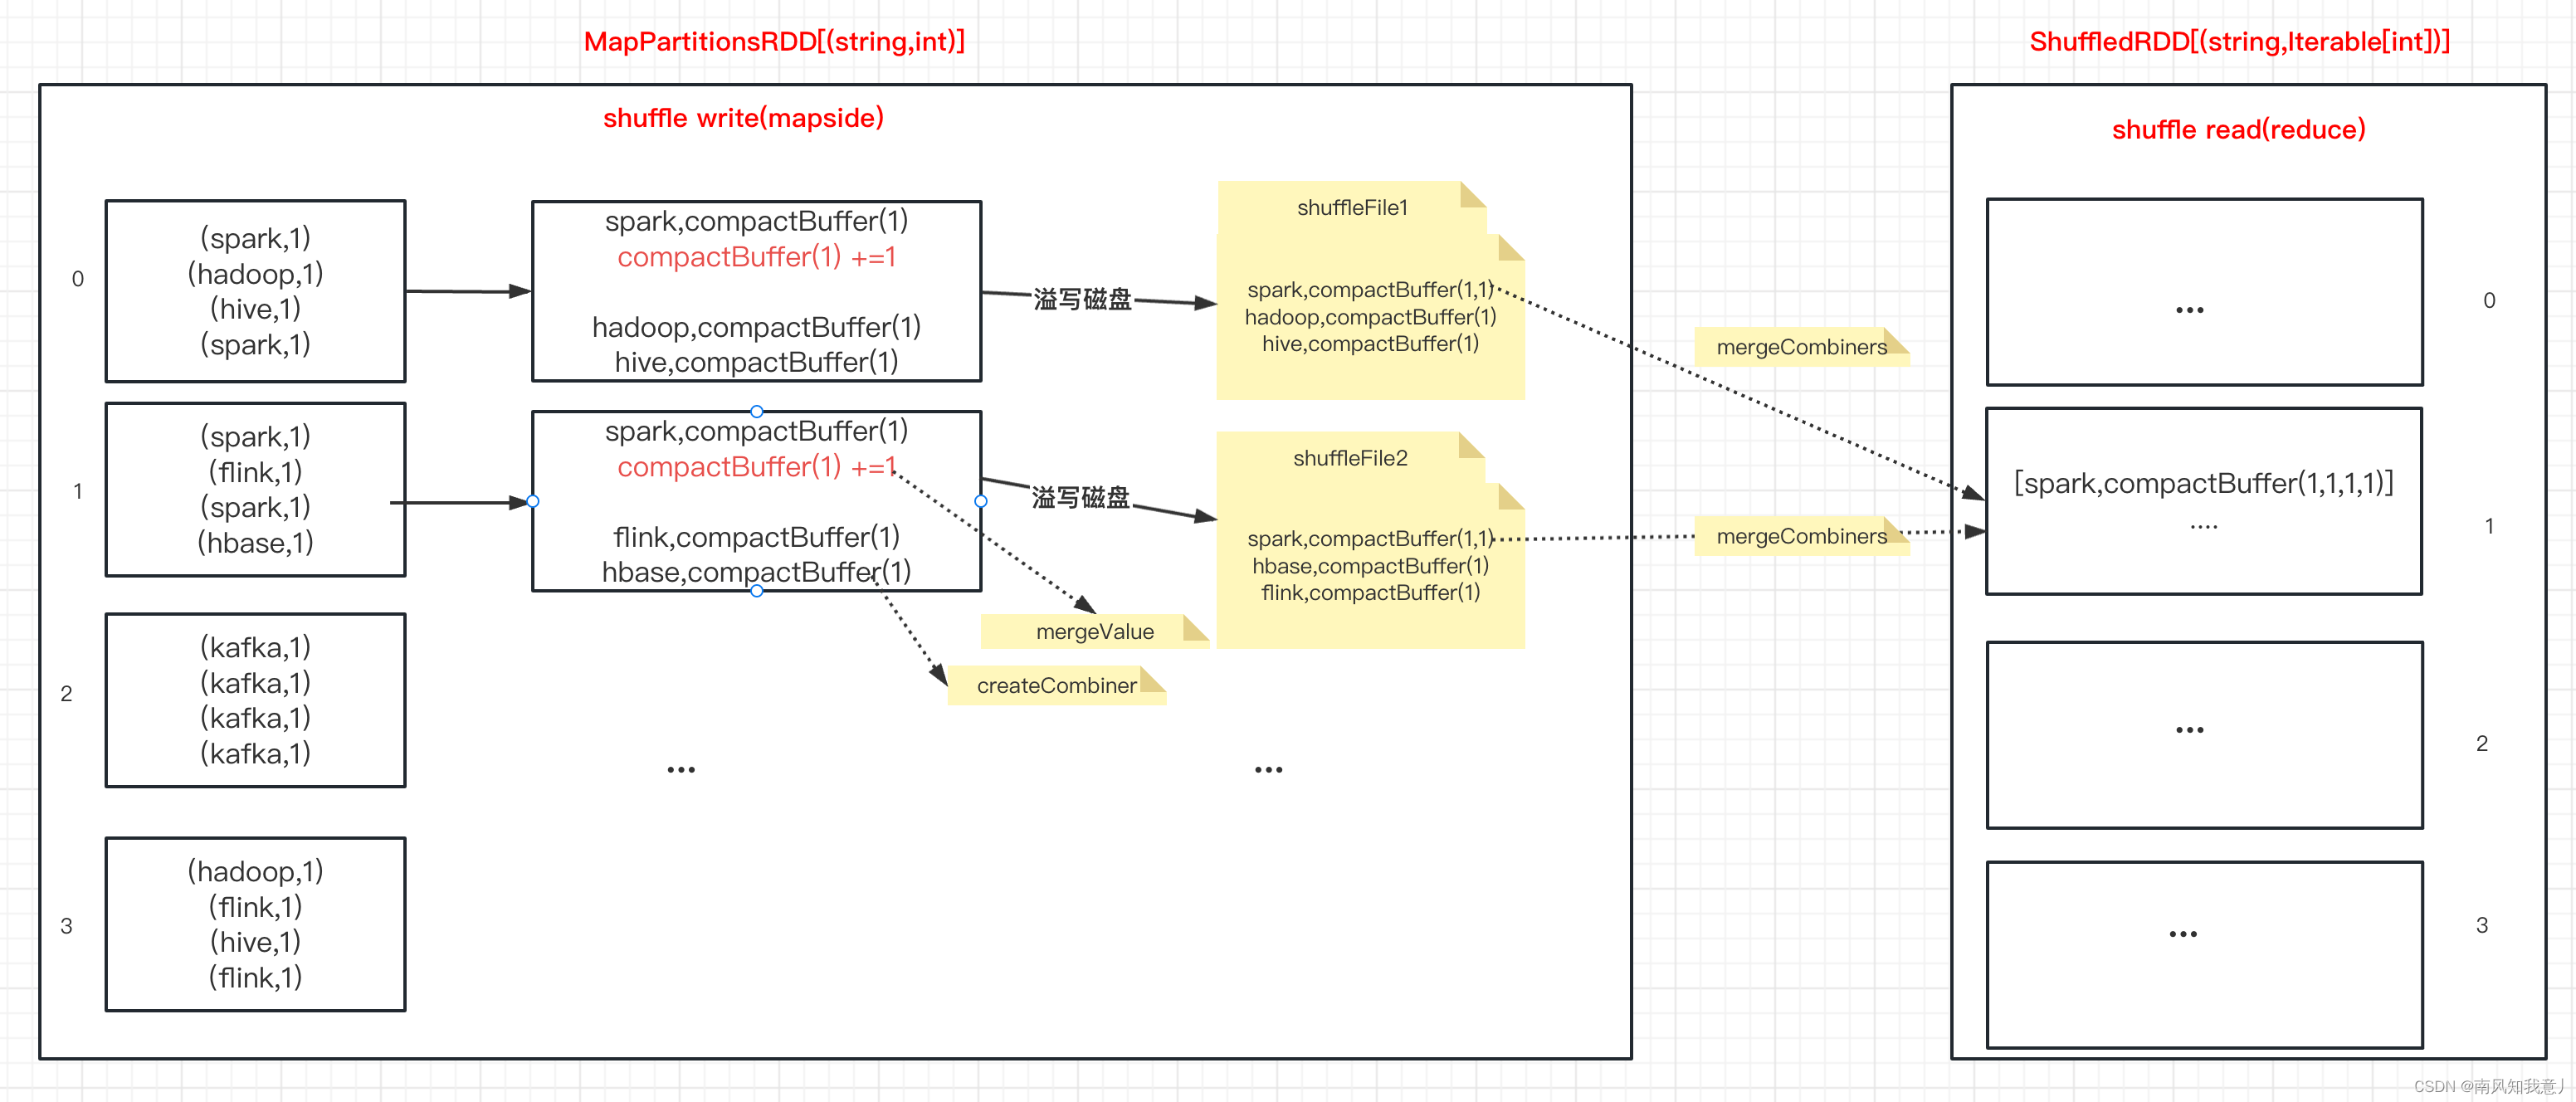
GroupByKey操作可能非常昂贵。如果您正在分组以便对每个键执行聚合(例如求和或平均),则使用 `aggregateByKey` 或` reduceByKey` 将提供更好的性能。>注意:按照目前的实现,groupByKey 必须能够保存内存中任何键的所有键值对。如果一个键的值太多,造成数据倾斜,可能会导致 `OutOfMemoryError`
然后我们直接右键运行,看下打印的日志看到提交成功了,然后我们打开yarn的监控页面看下有没有job。看到有一个spark程序在运行,然后我们点进去,看下具体的运行情况:选择一下job,看下executor打印的日志写到kafka的数据,没什么问题,停止的时候,只需要在idea里面点击停止程序就可以了,这样测试起来就会方便很多.这个是因为在本地提交的所以用户名是JasonLee,它没有访问hdfs的
在我的认识里,传统硬盘的写速度应该能够到120M/s的样子,网络传输速度也能够达到10M/s至少,在使用千兆交换机的前提下,甚至能够达到100M/s机器配置如下:机器数量:7DataNode:7内存:64G硬盘:12T 5400转 磁盘网络情况:公司内部局域网写测试:往HDFS上写100个128M的文件:使用命令 :TestDFSIO writeTest对应一个MapReduce job,每个文件
spark优雅关闭sparkConf.set("spark.streaming.stopGracefullyOnShutdown", "true")// 启动新的线程,希望在特殊的场合关闭SparkStreamingnew Thread(new Runnable {override def run(): Unit = {while ( true ) {try {Thread.sleep(5000)
jstat -gcutil < pid >GC日志jmap -heap < pid>jmap -histo < pid> | head -n 30