- @L277576271


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
如果你准备学习,最容易遇到的问题,其实往往不是“代码完全写不出来”,而是只照着某个平台的示例跑通了一次,却没有真正搞明白它背后的通用逻辑。结果一换平台,或者模型名稍微变一下,就不知道该从哪里改起了。所以这篇文章不会绑定某一家厂商,而是按照现在比较常见的来讲。我们会从最简单的一次 API 调用开始,一步步做出一个可以连续聊天的命令行助手。
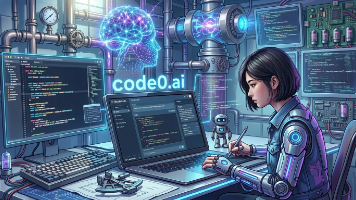
无效调用并不等于“调用次数多”。如果一次调用能稳定完成一个高价值任务,那它就是合理成本;反过来,哪怕单次请求很便宜,只要没有带来实际业务价值,本质上也是浪费。用户反复提交同一个问题,系统却每次都重新请求模型;空输入、乱码、刷接口请求没有提前拦住;长对话里每一轮都带上完整历史,输入 Token 越滚越大;简单分类、标签抽取、格式转换也直接调用高价大模型;Prompt 写得很长,背景、示例、规则一遍遍
大模型 API 的流式输出,简单说就是:模型在生成回答时,不会等整段答案全部写完再返回,而是先生成一部分,就先把这一部分发给客户端。用户看到的效果很像 AI 在“边打字边回答”,内容会逐字、逐词,或者一小段一小段地显示出来。在实际调用大模型 API 时,流式输出通常通过某个请求参数打开。比如很多兼容 OpenAI 格式的接口,会使用。开启之后,接口返回的就不再是一个完整答案,而是一连串增量数据片段
适合生成会议纪要、文章摘要、报告提炼。max_tokens要跟目标摘要长度匹配,比如一句话摘要可以设小一点,详细纪要就要多留一些空间。任务推荐设置事实问答结构化输出摘要改写内容生成代码生成创意脑暴管稳定性和多样性,max_tokens管输出上限、成本和延迟;生产环境一定要设置合理的输出上限;调参时一次只改一个变量。这样比盲目套默认参数靠谱得多,后面排查问题也会轻松很多。
排查AI API 报错,最怕的其实不是报错本身,而是把“错误码、参数、权限、限流、上下文、流式模式”全混在一起看。真正高效的API 调用失败排查,一般都是先按错误码分层,再缩小到请求体和调用场景,最后用request_id去确认根因。如果你愿意,把你的报错响应贴出来,我可以按“状态码 + 错误码 + message + 请求体”帮你快速拆开看。
大模型 API 稳定性设计的核心,并不是把失败藏起来,而是让失败有边界、可观测、可恢复。是否区分了可重试错误和不可重试错误;是否设置了业务总 deadline;是否使用了指数退避和 jitter;是否遵守 429 返回的;是否按 provider、model、region 做了熔断;是否准备了备用模型或备用供应商;是否设计了分层服务降级策略;是否处理了流式断流和续写;是否记录了重试次数、fallb
情况优先方案偶发 429指数退避 + jitter持续 429本地限速 + 队列请求不多但仍被限检查 TPM,减少 Token流式连接失败控制并发连接,清理闲置连接批量任务慢或失败多Batch API 或异步任务队列高峰期失败削峰、扩容、申请提额单模型限额低备用模型或模型路由多实例部署分布式限流或统一网关企业多业务共用租户限额、优先级队列、监控告警关键业务不能失败多供应商容灾 + 降级策略大模型
大模型 API 的接口响应慢排查和优化,不能简单照搬传统后端 API 那套方法。诊断思路应该从“推理时延、限流、冷启动、长上下文、第三方依赖”这五个角度入手,排查顺序则遵循“客户端日志 → 限流头信息 → 链路追踪 → 参数检查”这样的路径。优化方案没有银弹,需要根据实际场景来取舍:流式接口改善体验,指数退避重试应对瞬态故障,熔断器防止级联崩溃,模型降级换取可用性。合理的API超时优化策略,不是让
说实话,大模型 API 超时很少是单一原因造成的,它更像是一个客户端、网络、服务端三方联动的问题。现在很多文章只盯着某一个环节(比如客户端重试策略或者代理配置),缺少全局视角。本文提供的三层排查思路,能帮你一步步缩小问题范围,不至于在错误的方向上浪费时间。记住几个关键判断点:连接超时优先看网络和代理;读取超时里的 TTFB 时长是区分排队/网络延迟和推理延迟的分水岭;重试不是万能的,必要的时候得引
紧急止血:暂停所有请求 → 检查 Retry-After → 确认账户余额。诊断根因:看响应头判断是 RPM 还是 TPM 限制 → 登录监控面板核实。实施基础防御:加入指数退避 + 抖动重试 → 客户端本地限流 → 开启缓存。启用降级方案:配置主备模型轮换 → 非核心功能自动熔断 → 考虑消息队列削峰。长期战略:统计各模型成功率和成本 → 动态调整降级阈值 → 按需评估要不要引入更高级的架构,比