


- @David_house


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
假设特征和特征之间是相互独立的:通常,事件 A 在事件 B 发生的条件下与事件 B 在事件 A 发生的条件下,它们两者的概率并不相同,但是它们两者之间存在一定的相关性,并具有以下公式(称之为“贝叶斯公式”):朴素+贝叶斯公式应用场景:文本分类(单词作为特征)

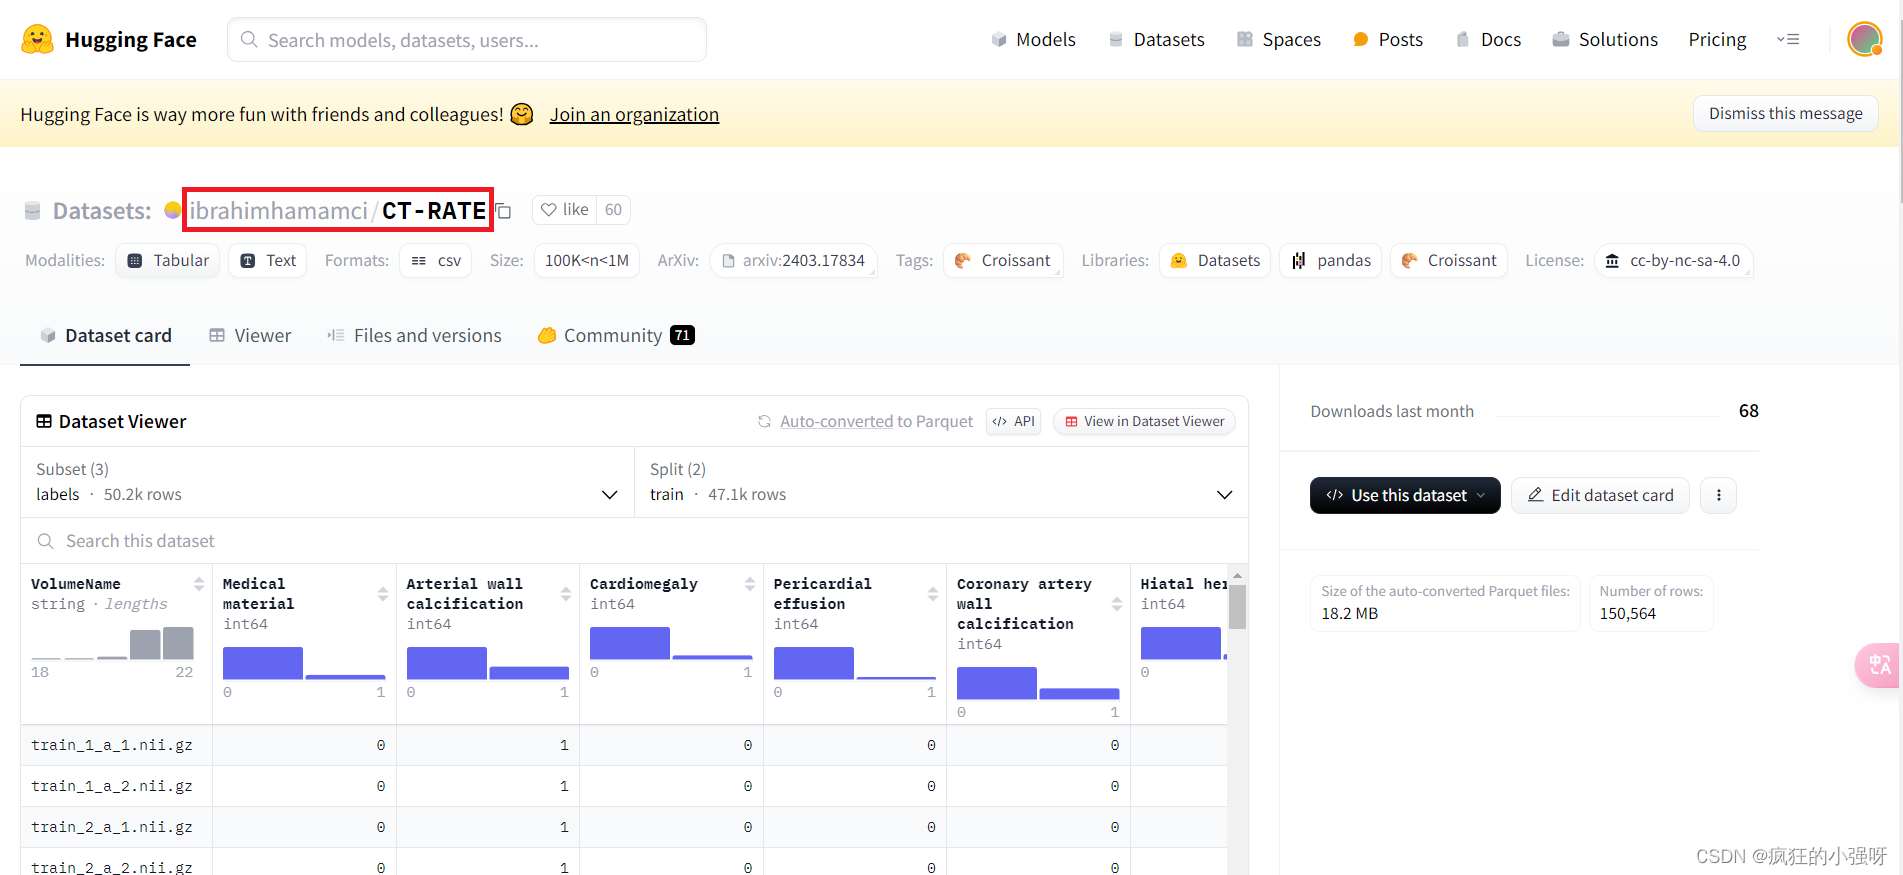
最近需要从huggingface上下载一个数据集,发现不能像模型那样能直接点击下载,需要通过代码来获取,很麻烦,谨以此博客作为记录
假设模型为y=w*x+b我们给出的训练数据是通过y=3*x+1,得到的,其中w=3,b=1通过训练y=w*x+b观察训练结果是否接近于w=3,b=1
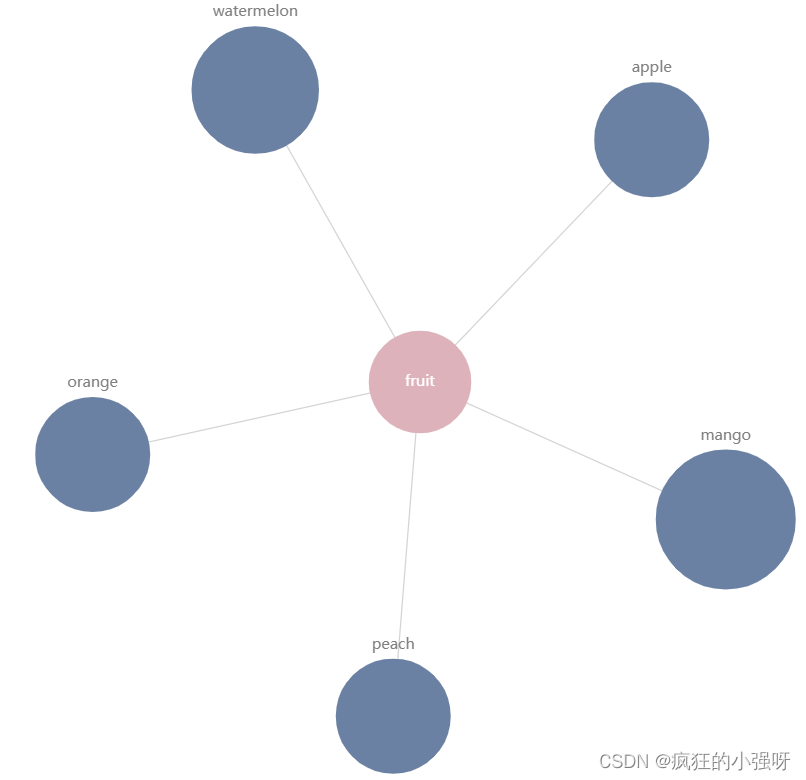
边缘节点可拖动,其大小可以根据传入的值而变化
自然语言处理入门自然语言处理入门自然语言的概念自然语言的理解自然语言处理的概念自然语言处理的相关技术自然语言处理难点相关学习链接自然语言处理入门自然语言的概念自然语言的理解自然语言处理(NLP)概念理解相关技术应用前景自然语言的概念自然语言是指人类日常使用的语言,如汉语、英语、法语、德语、等等。自然语言是人类交流和思维的主要工具。自然语言的理解人工智能早期研究的领域之...
本文介绍了命名实体识别(NER)的三种实现方案及数据标注方法。方案一使用深度学习模型(Bert-CRF),适合数据充足的特定领域;方案二通过大模型微调(Qwen),平衡效果与成本;方案三Prompt驱动大模型(GPT-4),适合零标注成本的快速迭代。在数据标注方面,详细说明了实体类型定义、BIO/BIOES标注体系以及JSON/XML格式的处理方法。建议根据具体场景选择方案,并采用兼容大模型和深度
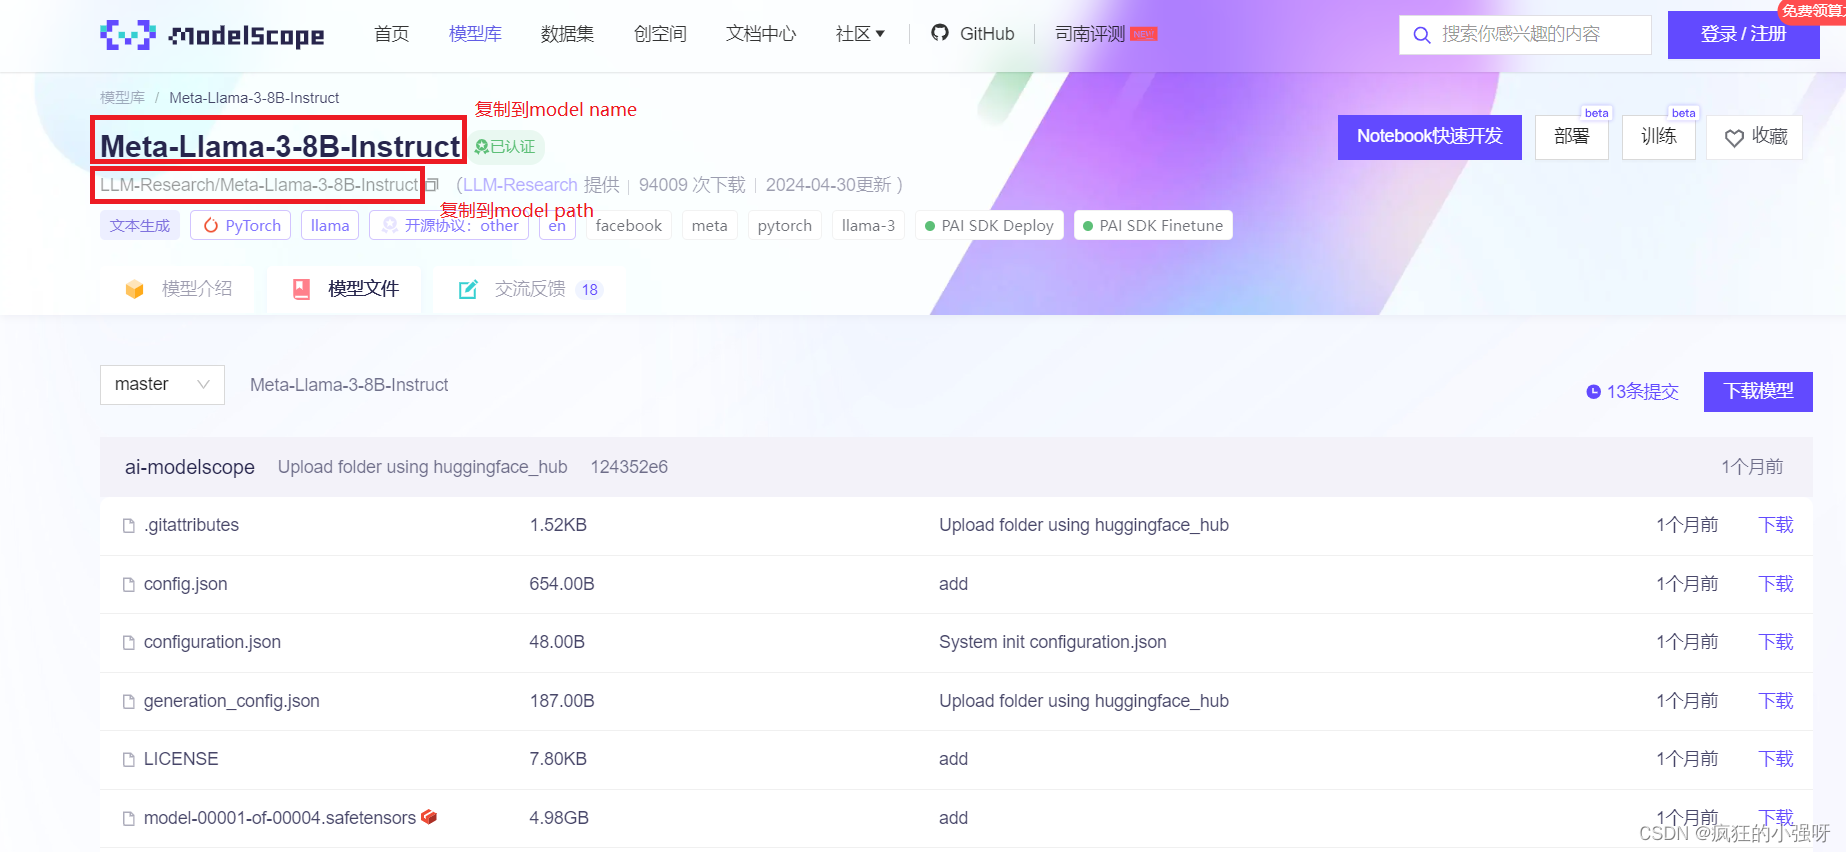
如果你尝试过微调大模型,你就会知道,大模型的环境配置是非常繁琐的,需要安装大量的第三方库和依赖,甚至需要接入一些框架。但是大模型微调的方法又是非常类似的,那有没有一种工具可以统一这些操作,让大模型微调变成一个简单易上手的事情,LLaMa-Factory就是为了解决这个问题应运而生
数据探索有利于我们发现数据的一些特性,数据之间的关联性,对于后续的特征构建是很有帮助的。对于数据的初步分析(直接查看数据,或.sum(), .mean(),.descirbe()等统计函数)可以从:样本数量,训练集数量,是否有时间特征,是否是时许问题,特征所表示的含义(非匿名特征),特征类型(字符类似,int,float,time),特征的缺失情况(注意缺失的在数据中的表现形式,有些是空的有些是”

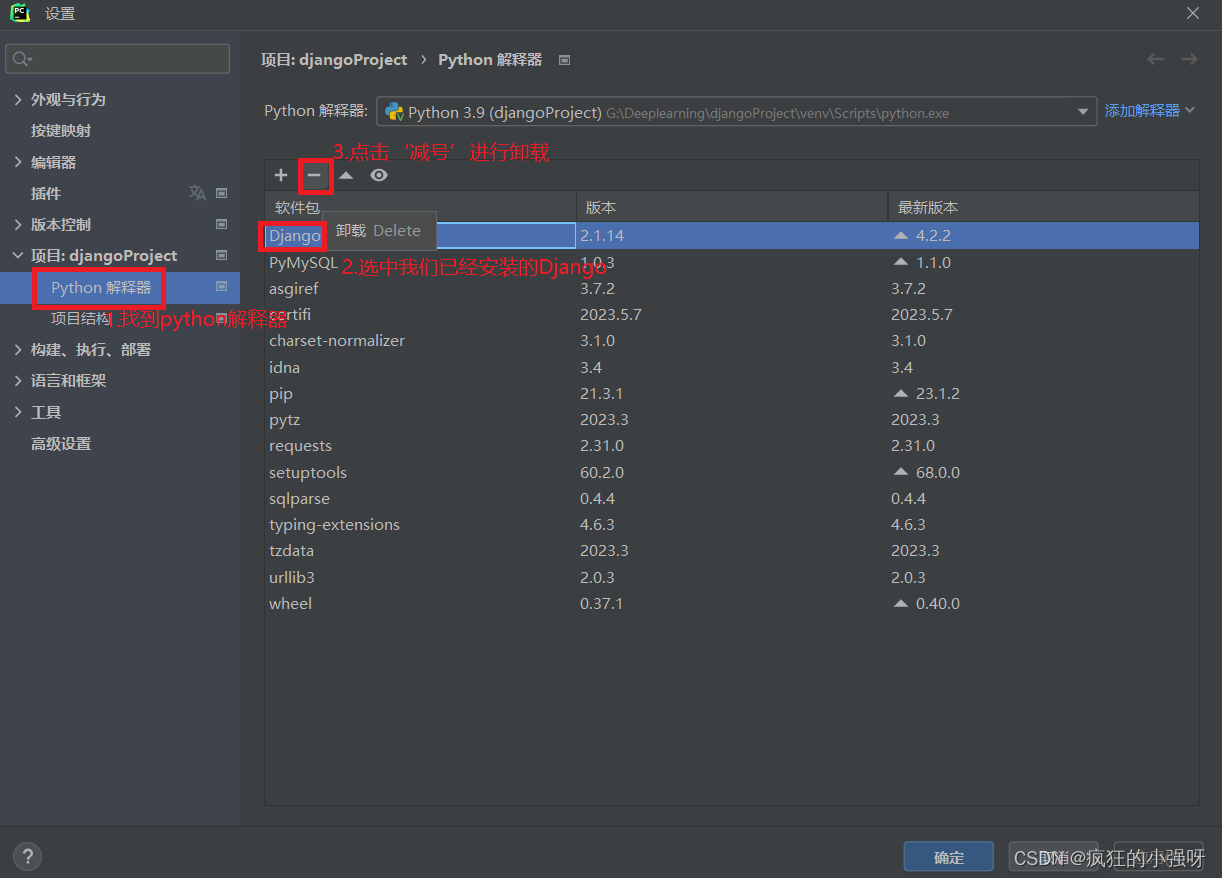
这个问题是说我们的Django框架版本比较新,已经不支持MySQL老版本5.7.2了,MySQL8或者更新的版本才是我们需要的或者说匹配的。
8080端口未出现wokers如果你已经启动hdfs和yarn,但是8080端口里面的wokers一个都没有出现或者是显示虚拟机拒绝了连接请求:一般情况下都是因为没有关闭防火墙,没有wokers出现还有一种情况就是你配置了zookeeper但是没有开zookeeper集群关闭防火墙命令:systemctl stop firewalld.service查看防火墙状态:systemctl ...