


- @A_Sinon


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
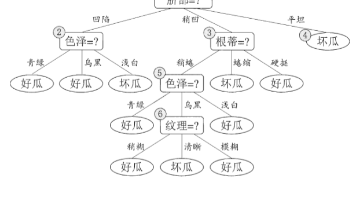
决策树是一种树状监督学习模型,通过递归划分属性将复杂决策拆解为简单步骤。核心优势在于可解释性强、对数据要求低,适用于分类和回归任务。关键步骤包括:1)属性划分选择(信息增益、增益率或基尼指数)以提升纯度;2)剪枝处理防止过拟合。信息增益易偏好多值属性,增益率通过固有值修正这一问题,基尼指数则计算更高效。决策树广泛应用于医疗、金融等领域,也是集成学习的基础组件。
本文系统介绍了神经网络的基础理论,重点解析了神经元模型和感知机的结构与工作原理。首先从生物神经元抽象出M-P模型,阐述其数学表达式和激活函数选择(阶跃函数与Sigmoid函数)。然后详细分析感知机的两层结构、功能边界(可处理线性可分问题但无法解决异或问题)及其学习策略,包括损失函数设计和权重更新规则。最后通过哑结点技巧统一权重与阈值参数,为神经网络训练奠定理论基础。全文严格遵循《机器学习》(西瓜书

若一个假设 h 满足:对训练集中的每一个样本(x,y),都有 h (x)=y(即能正确判断该样本是否为好瓜),则称 h 与训练集一致。
检验方法适用场景核心目标二项检验单个模型+单次留出法判断泛化错误率是否≤阈值t检验单个模型+多次评估(如k折交叉验证)判断平均泛化错误率是否等于阈值交叉验证t检验两个模型+k折交叉验证比较两个模型的泛化性能差异是否显著McNemar检验两个二分类模型+留出法基于分类结果差异(列联表)比较性能多个模型+多个数据集先判断整体差异,再定位具体优劣势模型一句话概括。
留出法直接将原始数据集 D 划分为两个互斥且穷尽训练集 S:用于训练模型;测试集 T:用于评估模型泛化性能;满足 D=S∪T 且 S∩T=∅(无交集)。模型训练完成后,用测试集 T 计算 “测试误差”,并将其作为对模型 “泛化误差” 的近似估计。例如:若 T 含 300 个样本,其中 90 个被模型分类错误,则测试错误率为 90/300=30%,可近似认为模型泛化错误率约为 30%。
本文系统介绍了线性回归模型的核心内容。首先阐述了线性回归的基本概念,即通过输入特征的线性组合预测连续值输出,并分析了其在回归任务、基准模型和可解释性方面的作用。然后详细推导了单变量和多变量线性回归的参数估计方法,包括最小二乘法的闭式解和矩阵形式的求解过程。针对过拟合问题,重点讲解了L0、L1、L2三种正则化方法的原理、特点及适用场景,其中L1正则化能产生稀疏解实现特征选择,L2正则化则更适合处理多
6.1节是支持向量机(SVM)的理论基础,其核心目标是找到能将两类样本正确划分的“最大间隔”超平面。直观来看,在样本空间中可以找到无数个能实现分类的线性超平面,但不同超平面的泛化能力存在显著差异。其中,位于两类样本正中间的超平面对样本扰动的容忍性最强——即便样本因噪声出现轻微偏移,该超平面仍能保持良好的分类效果,因此具备最优的泛化能力。本节的核心逻辑是:通过点到超平面的距离定义“间隔”,再基于间隔
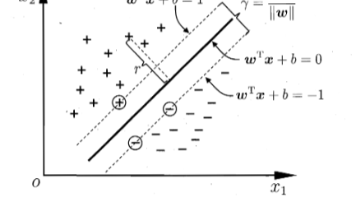
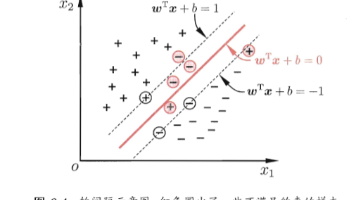
6.4节“软间隔与正则化”是支持向量机(SVM)从理论走向实际应用的核心改进,核心解决硬间隔SVM无法适配现实任务(数据非线性可分/含噪声) 的问题,同时通过正则化思想平衡“训练精度”与“模型泛化能力”,以下分模块详细讲解:硬间隔SVM的核心假设是“训练样本在样本空间/核映射后的特征空间中完全线性可分”,其优化目标是最大化间隔(最小化12∥w∥2\frac{1}{2}\|w\|^221∥w∥2)
本文介绍了贝叶斯分类器的理论基础——贝叶斯决策论。其核心目标是在已知概率和误判损失的情况下,通过最小化条件风险实现最优分类。重点分析了0/1损失函数下的简化形式,即选择后验概率最大的类别。文章指出实际应用中后验概率难以直接获取,提出了判别式模型和生成式模型两种估计策略,并详细阐述了生成式模型通过贝叶斯定理分解后验概率的方法,包括类先验概率、类条件概率和证据因子的估计方式。最后以西瓜分类为例,说明了
直接估计困境:因根蒂(隐变量ZZZ)未知,无法直接计算条件概率以估计模型参数;EM算法解决方案:通过E步“估计根蒂的概率分布”,再通过M步“基于该分布更新参数”,交替迭代后,即使隐变量未观测,也能得到合理的参数估计结果。简言之,EM算法是解决“隐变量导致参数估计困难”的通用工具,不仅适用于“缺失属性”场景,更是后续高斯混合聚类、因子分析等模型的核心求解器。