
机器学习笔记_西瓜书_06(支持向量机_下)
6.4 软间隔与正则化
6.4节“软间隔与正则化”是支持向量机(SVM)从理论走向实际应用的核心改进,核心解决硬间隔SVM无法适配现实任务(数据非线性可分/含噪声) 的问题,同时通过正则化思想平衡“训练精度”与“模型泛化能力”,以下分模块详细讲解:
6.4.1 软间隔:突破硬间隔SVM的现实局限性
6.4.1.1 软间隔的提出背景
硬间隔SVM的核心假设是“训练样本在样本空间/核映射后的特征空间中完全线性可分”,其优化目标是最大化间隔(最小化12∥w∥2\frac{1}{2}\|w\|^221∥w∥2),且约束所有样本满足yi(wTxi+b)≥1y_i(w^T x_i + b) \geq 1yi(wTxi+b)≥1(yiy_iyi为+1/−1+1/-1+1/−1类别标记)。但该假设在现实中存在两大致命问题:
- 线性可分假设难满足:很难找到合适的核函数,让训练样本在特征空间中完全线性可分;
- 易过拟合:即便通过复杂核函数强行实现线性可分,也会过度拟合训练集噪声/特殊样本,导致泛化性能下降。
为此,软间隔(Soft Margin) 思想提出:允许少量样本不满足硬间隔的严格约束,但通过“正则化”控制违规程度,在“最大化间隔”与“最小化分错样本数”间找平衡。
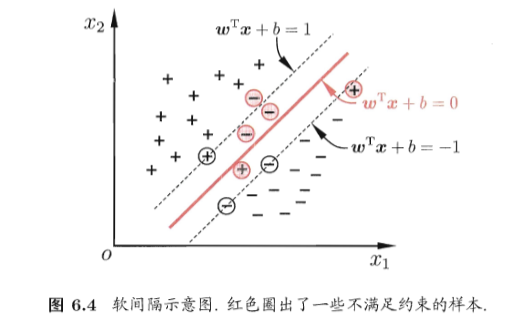
6.4.1.2 软间隔SVM的优化目标构建
软间隔的核心是“在最大化间隔的同时,对违规样本施加惩罚”,具体通过“损失项”和“松弛变量”实现:
6.4.1.2.1 引入损失项与替代损失函数
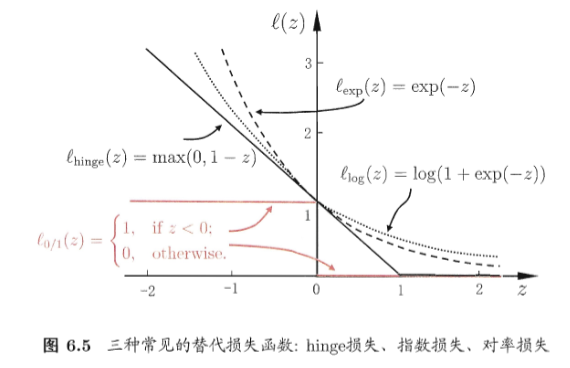
硬间隔中,样本违反约束(yi(wTxi+b)<1y_i(w^T x_i + b) < 1yi(wTxi+b)<1)对应0/1损失函数:
ℓ0/1(z)={1,z<0(样本违规)0,z≥0(样本合规)\ell_{0/1}(z) = \begin{cases} 1, & z < 0 \quad (\text{样本违规}) \\ 0, & z \geq 0 \quad (\text{样本合规}) \end{cases}ℓ0/1(z)={1,0,z<0(样本违规)z≥0(样本合规)
其中z=yi(wTxi+b)−1z = y_i(w^T x_i + b) - 1z=yi(wTxi+b)−1(z<0z < 0z<0表示违规)。
但0/1损失非凸、非连续,无法用于二次规划求解,因此需用“替代损失函数”(凸、连续,且是0/1损失的上界)替代,常用类型如下:
| 损失类型 | 表达式 | 核心特点 |
|---|---|---|
| Hinge损失 | ℓhinge(z)=max(0,1−z)\ell_{\text{hinge}}(z) = \max(0, 1-z)ℓhinge(z)=max(0,1−z) | 软间隔SVM默认选择,仅z<1z < 1z<1时产生损失,保持SVM“稀疏性”(仅支持向量影响模型) |
| 指数损失 | ℓexp(z)=exp(−z)\ell_{\text{exp}}(z) = \exp(-z)ℓexp(z)=exp(−z) | 对分错样本惩罚呈指数增长,鲁棒性差 |
| 对率损失 | ℓlog(z)=log(1+exp(−z))\ell_{\text{log}}(z) = \log(1+\exp(-z))ℓlog(z)=log(1+exp(−z)) | 输出有概率意义,无稀疏性 |
6.4.1.2.2 引入松弛变量,转化为带约束优化
为量化样本违规程度,引入松弛变量ξi≥0\xi_i \geq 0ξi≥0(每个样本对应一个ξi\xi_iξi):
- ξi=0\xi_i = 0ξi=0:样本完全满足硬间隔约束;
- 0<ξi<10 < \xi_i < 10<ξi<1:样本落在间隔内部(未分错,但违规);
- ξi≥1\xi_i \geq 1ξi≥1:样本被分错(yi(wTxi+b)≤0y_i(w^T x_i + b) \leq 0yi(wTxi+b)≤0)。
结合Hinge损失,软间隔SVM的优化目标为:
minw,b,ξi12∥w∥2+C∑i=1mξi\min_{w, b, \xi_i} \frac{1}{2}\|w\|^2 + C \sum_{i=1}^m \xi_iw,b,ξimin21∥w∥2+Ci=1∑mξi
s.t.yi(wTxi+b)≥1−ξi(i=1,2,...,m)\text{s.t.} \quad y_i(w^T x_i + b) \geq 1 - \xi_i \quad (i=1,2,...,m)s.t.yi(wTxi+b)≥1−ξi(i=1,2,...,m)
ξi≥0(i=1,2,...,m)\xi_i \geq 0 \quad (i=1,2,...,m)ξi≥0(i=1,2,...,m)
6.4.1.2.3 关键参数:正则化常数CCC
C>0C > 0C>0是“最大化间隔”与“最小化违规惩罚”的核心调节旋钮:
- CCC越大:对违规样本惩罚越重,模型越接近硬间隔SVM,易过拟合;
- CCC越小:对违规样本惩罚越轻,允许更多样本违规,模型更简单,泛化能力更强(但过轻会欠拟合)。
6.4.1.3 软间隔SVM的求解:拉格朗日乘子法与对偶问题
软间隔SVM是带约束的凸二次规划问题,需转化为对偶问题求解,步骤如下:
6.4.1.3.1 构造拉格朗日函数
对两类约束引入拉格朗日乘子:
- 对yi(wTxi+b)≥1−ξiy_i(w^T x_i + b) \geq 1 - \xi_iyi(wTxi+b)≥1−ξi引入αi≥0\alpha_i \geq 0αi≥0;
- 对ξi≥0\xi_i \geq 0ξi≥0引入μi≥0\mu_i \geq 0μi≥0。
拉格朗日函数为:
L(w,b,ξ,α,μ)=12∥w∥2+C∑i=1mξi+∑i=1mαi(1−ξi−yi(wTxi+b))−∑i=1mμiξi\mathcal{L}(w, b, \xi, \alpha, \mu) = \frac{1}{2}\|w\|^2 + C\sum_{i=1}^m \xi_i + \sum_{i=1}^m \alpha_i\left(1 - \xi_i - y_i(w^T x_i + b)\right) - \sum_{i=1}^m \mu_i \xi_iL(w,b,ξ,α,μ)=21∥w∥2+Ci=1∑mξi+i=1∑mαi(1−ξi−yi(wTxi+b))−i=1∑mμiξi
6.4.1.3.2 求偏导置零,消去原始变量
对www、bbb、ξi\xi_iξi求偏导并置零,得到关键等式:
- ∂L∂w=0 ⟹ w=∑i=1mαiyixi\frac{\partial \mathcal{L}}{\partial w} = 0 \implies w = \sum_{i=1}^m \alpha_i y_i x_i∂w∂L=0⟹w=∑i=1mαiyixi(www是支持向量的线性组合,与硬间隔一致);
- ∂L∂b=0 ⟹ ∑i=1mαiyi=0\frac{\partial \mathcal{L}}{\partial b} = 0 \implies \sum_{i=1}^m \alpha_i y_i = 0∂b∂L=0⟹∑i=1mαiyi=0(与硬间隔一致);
- ∂L∂ξi=0 ⟹ C=αi+μi\frac{\partial \mathcal{L}}{\partial \xi_i} = 0 \implies C = \alpha_i + \mu_i∂ξi∂L=0⟹C=αi+μi(软间隔新增,结合μi≥0\mu_i \geq 0μi≥0得0≤αi≤C0 \leq \alpha_i \leq C0≤αi≤C)。
6.4.1.3.3 对偶问题推导
代入上述等式消去原始变量,最终得到对偶问题:
maxα∑i=1mαi−12∑i=1m∑j=1mαiαjyiyjxiTxj\max_{\alpha} \sum_{i=1}^m \alpha_i - \frac{1}{2}\sum_{i=1}^m \sum_{j=1}^m \alpha_i \alpha_j y_i y_j x_i^T x_jαmaxi=1∑mαi−21i=1∑mj=1∑mαiαjyiyjxiTxj
s.t.∑i=1mαiyi=0\text{s.t.} \quad \sum_{i=1}^m \alpha_i y_i = 0s.t.i=1∑mαiyi=0
0≤αi≤C(i=1,2,...,m)0 \leq \alpha_i \leq C \quad (i=1,2,...,m)0≤αi≤C(i=1,2,...,m)
6.4.1.3.4 KKT条件:解释支持向量的性质
软间隔SVM需满足KKT条件,核心为:
{αi≥0,μi≥0,yi(wTxi+b)≥1−ξi,ξi≥0,αi(1−ξi−yi(wTxi+b))=0,μiξi=0,C=αi+μi.\begin{cases}
\alpha_i \geq 0, \mu_i \geq 0, \\
y_i(w^T x_i + b) \geq 1 - \xi_i, \xi_i \geq 0, \\
\alpha_i\left(1 - \xi_i - y_i(w^T x_i + b)\right) = 0, \\
\mu_i \xi_i = 0, \\
C = \alpha_i + \mu_i.
\end{cases}⎩⎨⎧αi≥0,μi≥0,yi(wTxi+b)≥1−ξi,ξi≥0,αi(1−ξi−yi(wTxi+b))=0,μiξi=0,C=αi+μi.
通过KKT条件可明确支持向量(仅αi>0\alpha_i > 0αi>0的样本)类型:
- 0<αi<C0 < \alpha_i < C0<αi<C:ξi=0\xi_i = 0ξi=0,样本落在间隔边界(与硬间隔支持向量一致);
- αi=C\alpha_i = Cαi=C:μi=0\mu_i = 0μi=0,ξi≥0\xi_i \geq 0ξi≥0:
- ξi<1\xi_i < 1ξi<1:样本落在间隔内部;
- ξi≥1\xi_i \geq 1ξi≥1:样本被分错。
软间隔SVM仍保持“稀疏性”——仅支持向量对模型有影响。
6.4.1.4 软间隔与硬间隔SVM的核心区别
| 对比维度 | 硬间隔SVM | 软间隔SVM |
|---|---|---|
| 核心假设 | 训练样本完全线性可分 | 允许少量样本违规/分错 |
| 约束条件 | yi(wTxi+b)≥1y_i(w^T x_i + b) \geq 1yi(wTxi+b)≥1 | yi(wTxi+b)≥1−ξiy_i(w^T x_i + b) \geq 1 - \xi_iyi(wTxi+b)≥1−ξi(ξi≥0\xi_i \geq 0ξi≥0) |
| 对偶变量约束 | αi≥0\alpha_i \geq 0αi≥0 | 0≤αi≤C0 \leq \alpha_i \leq C0≤αi≤C |
| 支持向量类型 | 仅间隔边界样本 | 间隔边界、间隔内部、分错样本 |
| 适用场景 | 数据线性可分、无噪声 | 现实任务(非线性可分、含噪声) |
6.4.2 正则化:平衡训练精度与泛化能力的核心逻辑
6.4.2.1 正则化要平衡的“两个核心目标”
正则化的本质是结构风险最小化(SRM),其优化目标通用形式为:
minfΩ(f)+C∑i=1mℓ(f(xi),yi)\min_f \Omega(f) + C \sum_{i=1}^m \ell(f(x_i), y_i)fminΩ(f)+Ci=1∑mℓ(f(xi),yi)
其中两个目标天然矛盾:
- 经验风险:∑i=1mℓ(f(xi),yi)\sum_{i=1}^m \ell(f(x_i), y_i)∑i=1mℓ(f(xi),yi)——衡量模型对训练数据的拟合程度,越小则训练误差越低,但易过拟合;
- 结构风险:Ω(f)\Omega(f)Ω(f)——衡量模型复杂度,越小则模型越简单,泛化能力越强,但易欠拟合。
6.4.2.2 正则化的平衡工具:正则化项与正则化常数
正则化通过两个核心组件实现“可控平衡”:
6.4.2.2.1 工具1:正则化项Ω(f)\Omega(f)Ω(f)——定义模型复杂度
Ω(f)\Omega(f)Ω(f)是模型复杂度的“衡量标准”,常用LpL_pLp范数实现,以线性模型f(x)=wTx+bf(x)=w^Tx+bf(x)=wTx+b为例:
- L2L_2L2范数正则化(软间隔SVM默认):
Ω(f)=12∥w∥22=12∑j=1dwj2\Omega(f)=\frac{1}{2}\|w\|_2^2=\frac{1}{2}\sum_{j=1}^d w_j^2Ω(f)=21∥w∥22=21∑j=1dwj2(ddd为特征维度)
作用:惩罚绝对值过大的参数,迫使参数取值均衡,避免模型过度依赖少数特征; - L1L_1L1范数正则化:
Ω(f)=∥w∥1=∑j=1d∣wj∣\Omega(f)=\|w\|_1=\sum_{j=1}^d |w_j|Ω(f)=∥w∥1=∑j=1d∣wj∣
作用:迫使参数稀疏(多数参数为0),自动实现特征选择,降低模型复杂度。
简言之:Ω(f)\Omega(f)Ω(f)给模型复杂度设“红线”,复杂度越高,Ω(f)\Omega(f)Ω(f)越大,优化函数值也越大,算法会“排斥”复杂模型。
6.4.2.2.2 工具2:正则化常数CCC——调节目标权重
CCC是经验风险的“放大系数”,核心作用是调节两个目标的权重:
- CCC越大:经验风险权重越高,模型优先拟合训练数据,易过拟合(极端情况C→∞C\to\inftyC→∞,退化为硬间隔SVM);
- CCC越小:经验风险权重越低,模型优先保持简单性,允许更多训练误差,泛化能力更强(极端情况C→0C\to0C→0,模型直接取最简单形式如w=0w=0w=0)。
6.4.2.3 正则化的平衡过程:算法如何自动找最优解
以软间隔SVM为例,其优化目标为:
minw,b,ξi12∥w∥22+C∑i=1mξi\min_{w,b,\xi_i} \frac{1}{2}\|w\|_2^2 + C\sum_{i=1}^m \xi_iw,b,ξimin21∥w∥22+Ci=1∑mξi
算法优化时会自动找“平衡点”:
- 若模型太复杂(∥w∥22\|w\|_2^2∥w∥22大):即使∑ξi\sum\xi_i∑ξi小,优化函数值仍大,算法会减小www范数(降低复杂度);
- 若训练误差太大(∑ξi\sum\xi_i∑ξi大):即使∥w∥22\|w\|_2^2∥w∥22小,优化函数值仍大,算法会减小ξi\xi_iξi(提升训练精度);
- 最终找到“复杂度+训练误差加权和最小”的模型——即泛化能力最强的模型。
6.4.2.4 正则化防止过拟合的底层逻辑
正则化项Ω(f)\Omega(f)Ω(f)的核心作用是削减假设空间:
- 假设空间:所有可能的模型集合(如所有参数向量www);
- 正则化的约束:给假设空间加限制(如∥w∥22≤M\|w\|_2^2 \leq M∥w∥22≤M),排除复杂度太高的模型;
- 结果:模型搜索范围缩小,“死记硬背”训练数据的概率降低,从而防止过拟合。
6.4.3 总结
- 软间隔通过松弛变量放松硬间隔约束,结合Hinge损失和正则化常数CCC,解决了硬间隔SVM无法适配现实数据的问题,且保持SVM的稀疏性;
- 正则化的核心是通过Ω(f)\Omega(f)Ω(f)定义模型复杂度、CCC调节权重,让算法自动平衡“训练精度”与“泛化能力”,是防止过拟合的核心手段;
- 软间隔SVM是正则化思想的典型应用,也是实际场景中最常用的SVM形式。
6.5节 支持向量回归(SVR)
支持向量回归(Support Vector Regression, SVR)是支持向量机(SVM)在回归任务中的扩展,其核心思想与分类任务的SVM一脉相承,但针对“预测连续值”的需求做了关键调整,解决了传统回归模型“过度追求完全拟合”的局限。本笔记从核心思想、数学建模、求解逻辑、线性与非线性实现、关键权衡点五个维度,系统梳理SVR的原理与应用。
6.5.1 核心思想:“可容忍偏差”的回归目标
传统回归模型(如线性回归)以完全拟合样本为目标,损失函数(如均方误差)会惩罚所有预测偏差,易导致模型过拟合。而现实场景中,微小偏差往往不影响任务效果(如西瓜含糖率预测误差0.01),过度追求“零偏差”会牺牲模型泛化能力。
SVR的核心突破是引入ε不敏感损失函数(ε-insensitive loss),允许模型输出与真实值存在“可接受的微小偏差ε”,并基于此构建ε隔离带:
- 当 ∣f(x)−y∣≤ε|f(x) - y| \leq \varepsilon∣f(x)−y∣≤ε 时,损失为0,样本落入隔离带内,视为预测正确;
- 当 ∣f(x)−y∣>ε|f(x) - y| > \varepsilon∣f(x)−y∣>ε 时,损失为 ∣f(x)−y∣−ε|f(x) - y| - \varepsilon∣f(x)−y∣−ε,仅惩罚超出隔离带的偏差部分。
ε隔离带是以回归函数 f(x)f(x)f(x) 为中心、宽度为 2ε2\varepsilon2ε 的区域。这种设计让模型聚焦于拟合数据整体趋势,而非贴合每个样本点,有效提升了抗噪声能力。
以西瓜含糖率预测为例:输入为西瓜密度 xxx,输出为含糖率 yyy(连续值)。设定 ε=0.02\varepsilon=0.02ε=0.02,若预测值为0.4、真实值为0.41,偏差0.01≤0.02,无损失;若真实值为0.45,偏差0.05>0.02,则损失为0.05-0.02=0.03。
6.5.2 数学建模:优化目标与约束条件
SVR的回归模型形式与线性回归一致,为 f(x)=wTx+bf(x) = w^T x + bf(x)=wTx+b(www 为权重向量,bbb 为偏移项),但通过“最大化间隔+控制误差”构建优化目标。
6.5.2.1 优化目标的定义
为平衡“模型泛化能力”与“拟合精度”,SVR的优化目标为:
minw,b,ξi,ξ^i12∥w∥2+C∑i=1m(ξi+ξ^i)
\min_{w,b,\xi_i,\hat{\xi}_i} \frac{1}{2}\|w\|^2 + C \sum_{i=1}^m (\xi_i + \hat{\xi}_i)
w,b,ξi,ξ^imin21∥w∥2+Ci=1∑m(ξi+ξ^i)
各符号含义如下:
- 12∥w∥2\frac{1}{2}\|w\|^221∥w∥2:模型复杂度正则项,最小化 ∥w∥\|w\|∥w∥ 等价于最大化隔离带宽度(隔离带宽度与 1/∥w∥1/\|w\|1/∥w∥ 成正比),保证模型泛化能力;
- C>0C > 0C>0:正则化常数,控制“间隔大小”与“误差惩罚”的权衡:
- CCC 越大:对带外误差惩罚越重,模型倾向于减少带外样本,可能导致隔离带变窄、过拟合;
- CCC 越小:对带外误差惩罚越轻,模型优先扩大隔离带,可能导致欠拟合;
- ξi,ξ^i≥0\xi_i, \hat{\xi}_i \geq 0ξi,ξ^i≥0:松弛变量,量化样本超出隔离带的程度:
- ξi\xi_iξi:样本低于隔离带下界的超出程度,满足 f(xi)−yi≤ε+ξif(x_i) - y_i \leq \varepsilon + \xi_if(xi)−yi≤ε+ξi;
- ξ^i\hat{\xi}_iξ^i:样本高于隔离带上界的超出程度,满足 yi−f(xi)≤ε+ξ^iy_i - f(x_i) \leq \varepsilon + \hat{\xi}_iyi−f(xi)≤ε+ξ^i。
6.5.2.2 约束条件
为规范松弛变量的物理意义,优化目标需满足以下约束:
{yi−f(xi)≤ε+ξ^if(xi)−yi≤ε+ξiξi≥0,ξ^i≥0
\begin{cases}
y_i - f(x_i) \leq \varepsilon + \hat{\xi}_i \\
f(x_i) - y_i \leq \varepsilon + \xi_i \\
\xi_i \geq 0, \hat{\xi}_i \geq 0
\end{cases}
⎩⎨⎧yi−f(xi)≤ε+ξ^if(xi)−yi≤ε+ξiξi≥0,ξ^i≥0
6.5.2.3 目标函数的完整形式
结合ε不敏感损失函数,SVR的优化目标可等价表示为:
minw,b12∥w∥2+C∑i=1mℓϵ(yi−f(xi))
\min_{w,b} \quad \frac{1}{2}\|w\|^2 + C \sum_{i=1}^m \ell_{\epsilon}(y_i - f(x_i))
w,bmin21∥w∥2+Ci=1∑mℓϵ(yi−f(xi))
其中ε不敏感损失函数的数学表达式为:
ℓϵ(z)={0,∣z∣≤ϵ;∣z∣−ϵ,otherwise.
\ell_{\epsilon}(z)= \begin{cases}0, & |z| \leq \epsilon ; \\ |z|-\epsilon, & otherwise. \end{cases}
ℓϵ(z)={0,∣z∣−ϵ,∣z∣≤ϵ;otherwise.
该式的本质是:最小化模型复杂度与带外误差损失的加权和,这是SVR区别于传统回归的核心。
6.5.3 求解逻辑:拉格朗日对偶与KKT条件
SVR的优化目标是带约束的凸二次规划问题,直接求解计算复杂度高,因此采用拉格朗日乘子法转化为对偶问题求解,同时为引入核函数处理非线性问题奠定基础。
6.5.3.1 拉格朗日函数构建
引入拉格朗日乘子 αi≥0,α^i≥0\alpha_i \geq 0, \hat{\alpha}_i \geq 0αi≥0,α^i≥0(对应误差约束)和 μi≥0,μ^i≥0\mu_i \geq 0, \hat{\mu}_i \geq 0μi≥0,μ^i≥0(对应松弛变量非负约束),构建拉格朗日函数:
L(w,b,α,α^,ξ,ξ^,μ,μ^)=12∥w∥2+C∑(ξi+ξ^i)−∑μiξi−∑μ^iξ^i+∑αi(f(xi)−yi−ε−ξi)+∑α^i(yi−f(xi)−ε−ξ^i)
L(w,b,\alpha,\hat{\alpha},\xi,\hat{\xi},\mu,\hat{\mu}) = \frac{1}{2}\|w\|^2 + C\sum(\xi_i+\hat{\xi}_i) - \sum\mu_i\xi_i - \sum\hat{\mu}_i\hat{\xi}_i + \sum\alpha_i(f(x_i)-y_i-\varepsilon-\xi_i) + \sum\hat{\alpha}_i(y_i-f(x_i)-\varepsilon-\hat{\xi}_i)
L(w,b,α,α^,ξ,ξ^,μ,μ^)=21∥w∥2+C∑(ξi+ξ^i)−∑μiξi−∑μ^iξ^i+∑αi(f(xi)−yi−ε−ξi)+∑α^i(yi−f(xi)−ε−ξ^i)
6.5.3.2 对偶问题转化
对 w,b,ξi,ξ^iw, b, \xi_i, \hat{\xi}_iw,b,ξi,ξ^i 求偏导并令其为0,消去这些变量后得到对偶问题:
maxα,α^[−12∑i,j(α^i−αi)(α^j−αj)xiTxj−ε∑(α^i+αi)+∑yi(α^i−αi)]
\max_{\alpha,\hat{\alpha}} \left[ -\frac{1}{2}\sum_{i,j}(\hat{\alpha}_i - \alpha_i)(\hat{\alpha}_j - \alpha_j)x_i^T x_j - \varepsilon\sum(\hat{\alpha}_i + \alpha_i) + \sum y_i(\hat{\alpha}_i - \alpha_i) \right]
α,α^max[−21i,j∑(α^i−αi)(α^j−αj)xiTxj−ε∑(α^i+αi)+∑yi(α^i−αi)]
约束条件为:
∑(α^i−αi)=0,0≤αi,α^i≤C
\sum(\hat{\alpha}_i - \alpha_i) = 0, \quad 0 \leq \alpha_i, \hat{\alpha}_i \leq C
∑(α^i−αi)=0,0≤αi,α^i≤C
6.5.3.3 关键参数求解
通过偏导置零,可得到权重向量 www 和偏移项 bbb 的表达式:
-
权重向量 www:
w=∑i=1m(α^i−αi)xi w = \sum_{i=1}^m (\hat{\alpha}_i - \alpha_i)x_i w=i=1∑m(α^i−αi)xi
可见 www 由训练样本线性组合而成,仅当 α^i≠αi\hat{\alpha}_i \neq \alpha_iα^i=αi 时,样本 xix_ixi 对模型有贡献,这类样本即为SVR的支持向量。 -
偏移项 bbb:
由KKT条件,当 0<αi<C0 < \alpha_i < C0<αi<C 时,ξi=0\xi_i = 0ξi=0,代入约束 f(xi)−yi=ε+ξif(x_i) - y_i = \varepsilon + \xi_if(xi)−yi=ε+ξi 可得:
b=yi+ε−∑j(α^j−αj)xjTxi b = y_i + \varepsilon - \sum_{j}(\hat{\alpha}_j - \alpha_j)x_j^T x_i b=yi+ε−j∑(α^j−αj)xjTxi
实际计算时,取所有满足 0<αi<C0 < \alpha_i < C0<αi<C 或 0<α^i<C0 < \hat{\alpha}_i < C0<α^i<C 的样本计算 bbb,再取平均值以保证鲁棒性。
6.5.3.4 KKT条件的意义
SVR的求解需满足KKT条件,这些条件揭示了支持向量的特性:
{αi(yi−f(xi)+ε+ξi)=0,α^i(f(xi)−yi+ε+ξ^i)=0αiα^i=0,ξiξ^i=0(C−αi)ξi=0,(C−α^i)ξ^i=0
\begin{cases}
\alpha_i(y_i - f(x_i) + \varepsilon + \xi_i) = 0, \quad \hat{\alpha}_i(f(x_i) - y_i + \varepsilon + \hat{\xi}_i) = 0 \\
\alpha_i \hat{\alpha}_i = 0, \quad \xi_i \hat{\xi}_i = 0 \\
(C - \alpha_i)\xi_i = 0, \quad (C - \hat{\alpha}_i)\hat{\xi}_i = 0
\end{cases}
⎩⎨⎧αi(yi−f(xi)+ε+ξi)=0,α^i(f(xi)−yi+ε+ξ^i)=0αiα^i=0,ξiξ^i=0(C−αi)ξi=0,(C−α^i)ξ^i=0
关键解读:
- 支持向量判定:仅 α^i≠αi\hat{\alpha}_i \neq \alpha_iα^i=αi 的样本为支持向量,这类样本要么落在隔离带外,要么落在隔离带边界上;
- 误差控制:αi<C\alpha_i < Cαi<C 时 ξi=0\xi_i = 0ξi=0,α^i<C\hat{\alpha}_i < Cα^i<C 时 ξ^i=0\hat{\xi}_i = 0ξ^i=0,即惩罚系数未饱和时,样本无超额偏差;
- 互斥性:αi\alpha_iαi 与 α^i\hat{\alpha}_iα^i 不能同时大于0,一个样本无法同时超出隔离带上下界。
6.5.4 线性与非线性SVR的实现
SVR的实现分为线性和非线性两种场景,核心区别在于是否需要通过核函数将样本映射到高维空间。
6.5.4.1 线性SVR:低维空间直接拟合
当样本在低维空间呈现线性趋势时(如西瓜密度与含糖率正相关),直接在原始空间求解超平面 f(x)=wTx+bf(x)=w^T x + bf(x)=wTx+b 即可。
以二维场景为例,回归函数为直线 f(x)=wx+bf(x)=wx+bf(x)=wx+b,优化目标是找到一条直线,使尽可能多的样本落入ε隔离带内,同时保证隔离带宽度最大化。求解后,输入新样本 xnewx_{new}xnew,直接代入直线方程即可得到连续预测值。
6.5.4.2 非线性SVR:核函数与高维映射
当样本在低维空间呈非线性分布时(如抛物线、正弦曲线分布),任何直线都无法有效拟合,此时需通过特征映射将样本映射到高维空间,使其在高维空间呈现线性趋势。
6.5.4.2.1 特征映射示例
假设二维样本服从抛物线分布 y=x2+0.1x+0.05y = x^2 + 0.1x + 0.05y=x2+0.1x+0.05:
- 二维空间:样本点分布在抛物线周围,直线无法贴合;
- 三维空间:定义特征映射 ϕ(x)=(x,x2)\phi(x) = (x, x^2)ϕ(x)=(x,x2),将二维样本转化为三维样本 (x,x2,1)(x, x^2, 1)(x,x2,1),此时三维空间中的超平面 f(ϕ(x))=w1x+w2x2+bf(\phi(x)) = w_1 x + w_2 x^2 + bf(ϕ(x))=w1x+w2x2+b 可完美拟合样本。
6.5.4.2.2 核函数:避免维度灾难
直接计算高维空间内积会面临维度灾难,因此SVR引入核函数 κ(xi,xj)=ϕ(xi)Tϕ(xj)\kappa(x_i,x_j) = \phi(x_i)^T \phi(x_j)κ(xi,xj)=ϕ(xi)Tϕ(xj),无需显式映射到高维,即可计算高维内积。
此时非线性SVR的回归模型为:
f(x)=∑i=1m(α^i−αi)κ(x,xi)+b
f(x) = \sum_{i=1}^m (\hat{\alpha}_i - \alpha_i)\kappa(x,x_i) + b
f(x)=i=1∑m(α^i−αi)κ(x,xi)+b
常用核函数包括:
- 线性核:κ(xi,xj)=xiTxj\kappa(x_i,x_j) = x_i^T x_jκ(xi,xj)=xiTxj(适用于线性分布样本);
- 多项式核:κ(xi,xj)=(xiTxj+1)d\kappa(x_i,x_j) = (x_i^T x_j + 1)^dκ(xi,xj)=(xiTxj+1)d(适用于多项式分布样本);
- 高斯核(RBF):κ(xi,xj)=exp(−∥xi−xj∥22σ2)\kappa(x_i,x_j) = \exp(-\frac{\|x_i-x_j\|^2}{2\sigma^2})κ(xi,xj)=exp(−2σ2∥xi−xj∥2)(适用于任意非线性分布样本,应用最广)。
6.5.5 关键权衡点:为什么不能让所有样本落入隔离带?
直观上看,隔离带越宽,样本越容易落入带内,损失项越小,但这会引发模型欠拟合问题,核心原因有两点:
6.5.5.1 ε是业务驱动的超参数,而非自由调节变量
ε的取值由业务需求的误差容忍度决定,而非“让所有样本进带”。例如西瓜含糖率预测中,ε=0.02是基于“误差0.02不影响甜度判断”的经验设定,若强行将ε调大至0.5,虽然所有样本都能落入带内,但模型输出会完全失去区分度(如密度0.6和0.8的西瓜预测含糖率相同)。
6.5.5.2 目标函数是“两项之和”的最小化,而非单一项最小化
SVR的优化目标是 模型复杂度项 + 误差损失项 的加权和最小,两项存在此消彼长的博弈关系:
| 项 | 含义 | 变化趋势 |
|---|---|---|
| 12∣w∣2\frac{1}{2}|w|^221∣w∣2 | 模型复杂度 | ∣w∣|w|∣w∣ 越小 → 隔离带越宽 → 模型越简单 → 拟合能力越弱 |
| C∑ℓϵ(⋅)C \sum\ell_{\epsilon}(\cdot)C∑ℓϵ(⋅) | 误差损失 | 隔离带越宽 → 损失越小 → 模型拟合精度越低 |
若强行让所有样本进带,模型会退化为无意义的水平线(w=0w=0w=0)。例如西瓜含糖率预测中,模型输出恒为0.4,完全忽略了密度与含糖率的正相关趋势,对新样本的预测完全失效。
因此,SVR的“取舍”本质是平衡泛化能力与拟合精度,通过调节正则化常数C,找到两者的最优平衡点。
6.5.6 SVR的核心优势与适用场景
6.5.6.1 核心优势
- 稀疏性:模型仅依赖支持向量,大部分样本不影响预测,存储和计算效率高;
- 鲁棒性:ε不敏感损失对噪声不敏感,避免模型被异常值带偏;
- 灵活性:核函数可处理任意非线性回归问题,适用范围广;
- 可解释性:参数C、ε的物理意义清晰,调参逻辑明确。
6.5.6.2 适用场景
SVR是小样本、高维、非线性回归任务的首选,例如文本情感强度预测、基因数据疾病风险预测等。在大样本回归任务中,由于训练效率低于树模型(XGBoost、LightGBM),使用频率较低。
6.6节 核方法
在机器学习中,核方法(Kernel Methods) 是一类基于核函数的通用学习框架,其核心思想是通过“核技巧(Kernel Trick)”隐式利用高维特征空间的线性模型,解决原始低维空间中非线性问题,同时避免直接处理高维数据带来的“维度灾难”。6.6节通过“表示定理”和“核线性判别分析(KLDA)”实例,系统阐述了核方法的理论基础与应用逻辑,以下从核心概念、理论支撑、实例应用三方面展开讲解:
6.6.1 核方法的引入背景:从SVM/SVR到通用框架
在6.2~6.5节中,我们发现:无论是用于分类的支持向量机(SVM),还是用于回归的支持向量回归(SVR),若不考虑偏移项bbb,其最终学得的模型均可表示为核函数的线性组合:
- SVM分类模型(式6.24):f(x)=∑i=1mαiyiκ(x,xi)f(x)=\sum_{i=1}^m \alpha_i y_i \kappa(x,x_i)f(x)=∑i=1mαiyiκ(x,xi)
- SVR回归模型(式6.56):f(x)=∑i=1m(α^i−αi)κ(x,xi)f(x)=\sum_{i=1}^m (\hat{\alpha}_i - \alpha_i) \kappa(x,x_i)f(x)=∑i=1m(α^i−αi)κ(x,xi)
这一现象并非偶然——表示定理(Representer Theorem) 揭示了:对一大类优化问题,其最优解均可表示为核函数的线性组合。这一理论为核方法从“SVM/SVR特例”推广为“通用学习框架”奠定了基础。
6.6.2 核方法的理论核心:表示定理
表示定理是核方法的“基石”,它从数学上证明了核函数线性组合的普适性,具体内容如下:
6.6.2.1 定理内容(文档定理6.2)
设H\mathbb{H}H为核函数κ\kappaκ对应的再生核希尔伯特空间(RKHS,一种具有“再生性”的函数空间,满足“函数值=内积”),∥h∥H\|h\|_{\mathbb{H}}∥h∥H为H\mathbb{H}H中函数hhh的范数。若优化问题满足:
- 目标函数形式:minh∈HF(h)=Ω(∥h∥H)+ℓ(h(x1),h(x2),...,h(xm))\min_{h \in \mathbb{H}} F(h) = \Omega(\|h\|_{\mathbb{H}}) + \ell(h(x_1),h(x_2),...,h(x_m))minh∈HF(h)=Ω(∥h∥H)+ℓ(h(x1),h(x2),...,h(xm))
- Ω:[0,∞]↦R\Omega: [0,\infty] \mapsto \mathbb{R}Ω:[0,∞]↦R:单调递增函数(如正则化项,控制模型复杂度);
- ℓ:Rm↦[0,∞]\ell: \mathbb{R}^m \mapsto [0,\infty]ℓ:Rm↦[0,∞]:非负损失函数(如分类任务的0/1损失、回归任务的均方损失)。
则该优化问题的最优解h∗(x)h^*(x)h∗(x)必可表示为核函数的线性组合:
h∗(x)=∑i=1mαiκ(x,xi)h^*(x) = \sum_{i=1}^m \alpha_i \kappa(x,x_i)h∗(x)=i=1∑mαiκ(x,xi)
其中αi\alpha_iαi为待求系数,xix_ixi是训练样本。
6.6.2.2 表示定理的关键意义
- 简化优化问题:无需直接在高维RKHS中求解函数h(x)h(x)h(x),只需优化系数αi\alpha_iαi(数量等于训练样本数mmm),避免了高维空间的计算困难;
- 通用适配性:只要模型的优化目标符合“正则化项+经验损失”的形式(大多数机器学习模型均满足,如线性回归、LDA、逻辑回归等),其解均可通过核函数线性组合表示,这为核方法的广泛应用提供了理论保障;
- 核技巧的合法性:证明了“用核函数隐式表示高维特征映射”的合理性——无需显式定义映射ϕ(x)\phi(x)ϕ(x),只需通过核函数κ(x,xi)=ϕ(x)Tϕ(xi)\kappa(x,x_i)=\phi(x)^T \phi(x_i)κ(x,xi)=ϕ(x)Tϕ(xi)即可利用高维空间的线性模型。
6.6.3 核方法的应用实例:核线性判别分析(KLDA)
为了具体说明核方法如何将“线性学习器拓展为非线性学习器”,文档以核线性判别分析(Kernelized Linear Discriminant Analysis, KLDA) 为例,展示了核化的完整过程。KLDA的目标是:通过核技巧,将原始空间中非线性可分的数据,映射到高维特征空间后用LDA做线性分类,从而实现原始空间的非线性分类。
6.6.3.1 线性判别分析(LDA)的回顾
线性判别分析(LDA,3.4节)的核心思想是:在原始空间中寻找一个投影方向www,使得投影后“同类样本尽可能近、异类样本尽可能远”,优化目标为:
J(w)=wTSbwwTSwwJ(w) = \frac{w^T S_b w}{w^T S_w w}J(w)=wTSwwwTSbw
其中SbS_bSb为类间散度矩阵(衡量异类中心距离),SwS_wSw为类内散度矩阵(衡量同类样本离散度)。
6.6.3.2 KLDA的核化过程(核心步骤)
由于原始空间可能非线性可分,KLDA通过“核化”将LDA推广到非线性场景,具体步骤如下:
6.6.3.2.1 步骤1:假设特征映射
设原始空间样本xxx通过映射ϕ:X↦F\phi: \mathcal{X} \mapsto \mathbb{F}ϕ:X↦F(F\mathbb{F}F为高维特征空间),则在F\mathbb{F}F中,LDA的优化目标变为:
J(w)=wTSbϕwwTSwϕwJ(w) = \frac{w^T S_b^\phi w}{w^T S_w^\phi w}J(w)=wTSwϕwwTSbϕw
其中SbϕS_b^\phiSbϕ、SwϕS_w^\phiSwϕ分别为特征空间中的类间、类内散度矩阵,定义为:
- Sbϕ=(μ1ϕ−μ0ϕ)(μ1ϕ−μ0ϕ)TS_b^\phi = (\mu_1^\phi - \mu_0^\phi)(\mu_1^\phi - \mu_0^\phi)^TSbϕ=(μ1ϕ−μ0ϕ)(μ1ϕ−μ0ϕ)T(μiϕ\mu_i^\phiμiϕ为第iii类样本在F\mathbb{F}F中的均值);
- Swϕ=∑i=01∑x∈Xi(ϕ(x)−μiϕ)(ϕ(x)−μiϕ)TS_w^\phi = \sum_{i=0}^1 \sum_{x \in X_i} (\phi(x) - \mu_i^\phi)(\phi(x) - \mu_i^\phi)^TSwϕ=∑i=01∑x∈Xi(ϕ(x)−μiϕ)(ϕ(x)−μiϕ)T。
6.6.3.2.2 步骤2:用核函数替换高维内积
由于F\mathbb{F}F维度可能极高(甚至无穷维),无法直接计算ϕ(x)\phi(x)ϕ(x)和SbϕS_b^\phiSbϕ、SwϕS_w^\phiSwϕ。根据核技巧,用核函数κ(x,xi)=ϕ(x)Tϕ(xi)\kappa(x,x_i)=\phi(x)^T \phi(x_i)κ(x,xi)=ϕ(x)Tϕ(xi)隐式表示高维内积,同时引入核矩阵KKK(Kij=κ(xi,xj)K_{ij}=\kappa(x_i,x_j)Kij=κ(xi,xj))。
通过推导(文档式6.64~6.70),可将特征空间的优化目标J(w)J(w)J(w)转化为用核矩阵表示的形式:
J(α)=αTMααTNαJ(\alpha) = \frac{\alpha^T M \alpha}{\alpha^T N \alpha}J(α)=αTNααTMα
其中:
- M=(μ^0−μ^1)(μ^0−μ^1)TM = (\hat{\mu}_0 - \hat{\mu}_1)(\hat{\mu}_0 - \hat{\mu}_1)^TM=(μ^0−μ^1)(μ^0−μ^1)T(μ^i=1miK1i\hat{\mu}_i = \frac{1}{m_i} K 1_iμ^i=mi1K1i,1i1_i1i为第iii类样本的指示向量);
- N=KKT−∑i=01miμ^iμ^iTN = K K^T - \sum_{i=0}^1 m_i \hat{\mu}_i \hat{\mu}_i^TN=KKT−∑i=01miμ^iμ^iT。
6.6.3.2.3 步骤3:求解与预测
KLDA的优化目标J(α)J(\alpha)J(α)与线性LDA的形式完全一致,因此可直接复用LDA的求解方法(如求解广义特征值问题)得到α\alphaα。最终的投影函数为:
h(x)=∑i=1mαiκ(x,xi)h(x) = \sum_{i=1}^m \alpha_i \kappa(x,x_i)h(x)=i=1∑mαiκ(x,xi)
即通过核函数线性组合实现非线性投影,完成分类任务。
6.6.4 核方法的核心思想与优势
6.6.4.1 核心思想
核方法的本质是“隐式利用高维线性模型解决低维非线性问题”:
- 不显式定义高维特征映射ϕ(x)\phi(x)ϕ(x),而是通过核函数κ(x,x′)\kappa(x,x')κ(x,x′)间接计算高维空间的内积;
- 基于表示定理,将优化问题的解转化为核函数的线性组合,既保留了线性模型的简洁性和成熟算法,又能处理原始空间的非线性问题。
6.6.4.2 关键优势
- 避免维度灾难:无需处理高维数据,核函数的计算始终在原始低维空间进行;
- 灵活性强:可通过选择不同的核函数(如高斯核、多项式核,表6.1)适配不同的数据分布,无需修改模型框架;
- 通用性广:可将线性回归、逻辑回归、LDA、主成分分析(PCA)等多种线性模型“核化”,拓展为非线性模型(如核PCA、核对率回归)。
6.6.5 核方法的应用场景
核方法适用于原始空间非线性可分/非线性相关的任务,典型应用包括:
- 非线性分类:如KLDA、核SVM,用于图像识别、文本分类(如用线性核处理文本,高斯核处理图像非线性特征);
- 非线性回归:如核SVR,用于时间序列预测、金融数据回归;
- 非线性降维:如核PCA(文档未提及,属核方法延伸),用于高维数据可视化、特征压缩。
6.6.6 总结
6.6节通过“表示定理”将核技巧从SVM/SVR的特例推广为通用框架,证明了核方法的理论合法性;通过KLDA实例展示了核方法的具体应用流程。核方法的核心价值在于:以线性模型的复杂度,实现非线性问题的求解,是连接线性学习与非线性学习的重要桥梁,至今仍是机器学习中处理非线性问题的经典工具之一。
更多推荐

 14
 0
- 0


 已为社区贡献9条内容

所有评论(0)