
机器学习笔记_西瓜书_06(支持向量机_上)
第六章 SVM
6.1 间隔与支持向量
6.1.1 核心思想
6.1节是支持向量机(SVM)的理论基础,其核心目标是找到能将两类样本正确划分的“最大间隔”超平面。
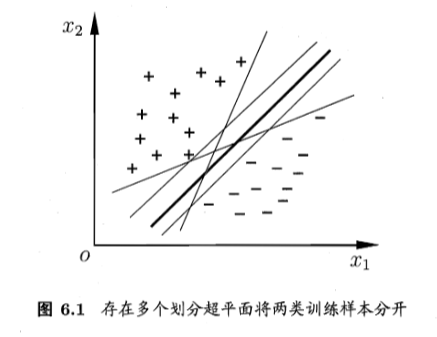
直观来看,在样本空间中可以找到无数个能实现分类的线性超平面,但不同超平面的泛化能力存在显著差异。其中,位于两类样本正中间的超平面对样本扰动的容忍性最强——即便样本因噪声出现轻微偏移,该超平面仍能保持良好的分类效果,因此具备最优的泛化能力。
本节的核心逻辑是:通过点到超平面的距离定义“间隔”,再基于间隔最大化推导SVM的基本优化目标,为后续对偶问题、核函数等内容的学习奠定基础。
6.1.2 核心概念铺垫
在进行公式推导前,需明确两个关键概念,这是理解SVM间隔思想的前提。
(1)线性超平面的数学表示
在ddd维样本空间中,任意一个线性超平面的方程可描述为:
wTx+b=0(6.1)w^T x + b = 0 \tag{6.1}wTx+b=0(6.1)
其中各符号的含义如下:
- w=(w1;w2;...;wd)w = (w_1; w_2; ...; w_d)w=(w1;w2;...;wd):超平面的法向量,垂直于超平面,其方向直接决定超平面的朝向;
- bbb:位移项,决定超平面与坐标原点的距离,bbb的绝对值越大,超平面离原点越远;
- x=(x1;x2;...;xd)x = (x_1; x_2; ...; x_d)x=(x1;x2;...;xd):样本空间中的任意点,对应样本的特征向量。
为了表述简洁,我们将该超平面简记为(w,b)(w, b)(w,b)。
(2)支持向量的定义
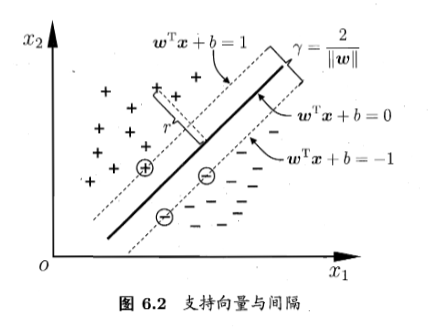
支持向量是距离超平面最近的样本点,这些点是决定超平面位置的核心——移除非支持向量,超平面的位置不会发生改变。
我们定义,根据分类标签的不同,支持向量满足如下等式:
wTxi+b=±1w^T x_i + b = \pm 1wTxi+b=±1
- 正类支持向量(对应标签yi=+1y_i=+1yi=+1):满足wTxi+b=1w^T x_i + b = 1wTxi+b=1;
- 负类支持向量(对应标签yi=−1y_i=-1yi=−1):满足wTxi+b=−1w^T x_i + b = -1wTxi+b=−1。
6.1.3 公式6.2 点到超平面的距离 详细推导
公式6.2描述了样本空间中任意点xxx到超平面(w,b)(w, b)(w,b)的距离,其推导核心是向量投影的几何意义,具体步骤如下。
步骤1:明确点到超平面距离的几何本质
点到超平面的距离,是该点到超平面的最短距离。由于超平面是“平坦”的线性结构,最短路径必然是从该点向超平面作垂线,这条垂线的长度即为距离。
而超平面的法向量www本身就垂直于超平面,因此,点到超平面的距离等价于该点与超平面上任意一点的连线向量,在法向量www方向上的投影长度。
步骤2:构建向量与投影公式
- 取超平面上任意一点x0x_0x0,根据超平面的定义,x0x_0x0满足wTx0+b=0w^T x_0 + b = 0wTx0+b=0;
- 构建从点xxx指向点x0x_0x0的向量xx0⃗=x−x0\vec{xx_0} = x - x_0xx0=x−x0;
- 引用向量投影长度的通用公式:若向量a⃗\vec{a}a在向量b⃗\vec{b}b上的投影长度为rrr,则
r=∣a⃗⋅b⃗∣∥b⃗∥r=\frac{|\vec{a} \cdot \vec{b}|}{\|\vec{b}\|}r=∥b∥∣a⋅b∣
其中,分子为向量点积的绝对值(保证距离非负),分母为向量b⃗\vec{b}b的L2范数(即向量的模长)。
步骤3:代入向量与超平面条件化简
将a⃗=x−x0\vec{a}=x-x_0a=x−x0、b⃗=w\vec{b}=wb=w代入投影公式,得到点xxx到超平面的距离表达式:
r=∣wT(x−x0)∣∥w∥r = \frac{|w^T (x - x_0)|}{\|w\|}r=∥w∥∣wT(x−x0)∣
展开分子中的点积运算:
wT(x−x0)=wTx−wTx0w^T (x - x_0) = w^T x - w^T x_0wT(x−x0)=wTx−wTx0
由于x0x_0x0在超平面上,满足wTx0=−bw^T x_0 = -bwTx0=−b,将其代入上式可得:
wTx−wTx0=wTx+bw^T x - w^T x_0 = w^T x + bwTx−wTx0=wTx+b
步骤4:得到最终距离公式
将化简后的分子代入投影长度表达式,即可得到公式6.2:
r=∣wTx+b∣∥w∥(6.2)r = \frac{|w^T x + b|}{\|w\|} \tag{6.2}r=∥w∥∣wTx+b∣(6.2)
关键细节补充
- 分子取绝对值:wTx+bw^T x + bwTx+b的符号由点xxx在超平面的哪一侧决定(正侧为正,负侧为负),但距离是长度,必须非负,因此需要取绝对值;
- 分母∥w∥\|w\|∥w∥的作用:∥w∥=w12+w22+...+wd2\|w\|=\sqrt{w_1^2+w_2^2+...+w_d^2}∥w∥=w12+w22+...+wd2是法向量的模长,其作用是“归一化”——法向量的长度不影响超平面的位置,但会影响距离计算结果,除以∥w∥\|w\|∥w∥才能得到真实的长度单位距离。
6.1.4 间隔的定义与SVM基本优化目标
推导点到超平面的距离公式后,我们可以进一步定义SVM的“间隔”,并推导其基本优化目标。
(1)支持向量到超平面的距离
支持向量是距离超平面最近的样本点,将支持向量满足的wTxi+b=±1w^T x_i + b = \pm 1wTxi+b=±1代入公式6.2,可得单个支持向量到超平面的距离:
r支持向量=∣wTxi+b∣∥w∥=1∥w∥r_{\text{支持向量}} = \frac{|w^T x_i + b|}{\|w\|} = \frac{1}{\|w\|}r支持向量=∥w∥∣wTxi+b∣=∥w∥1
(2)间隔(Margin)的定义
SVM中的间隔,是两类异类支持向量到超平面的距离之和,即:
γ=1∥w∥+1∥w∥=2∥w∥\gamma = \frac{1}{\|w\|} + \frac{1}{\|w\|} = \frac{2}{\|w\|}γ=∥w∥1+∥w∥1=∥w∥2
(3)间隔分子为2的根源及k=1k=1k=1的标准化选择
上述间隔公式中分子为222,其根源是支持向量满足wTxi+b=±1w^T x_i + b=\pm1wTxi+b=±1的约定,且该约定可推广到任意正数kkk,最终选择k=1k=1k=1是为了标准化约束、简化计算。
① 间隔分子与支持向量约定的关联
- 约定为±1\pm1±1时的间隔
当支持向量满足wTxi+b=±1w^T x_i + b=\pm1wTxi+b=±1时,正、负类支持向量到超平面的距离分别为1∥w∥\frac{1}{\|w\|}∥w∥1,二者之和即间隔γ=2∥w∥\gamma=\frac{2}{\|w\|}γ=∥w∥2,分子222是两个支持向量距离的分子1+11+11+1相加的结果。 - 约定为±k\pm k±k时的间隔
若将约定改为支持向量满足wTxi+b=±kw^T x_i + b=\pm kwTxi+b=±k(k>0k>0k>0为任意正数),重复推导可得:
正类支持向量距离r+=∣k∣∥w∥=k∥w∥r_+=\frac{|k|}{\|w\|}=\frac{k}{\|w\|}r+=∥w∥∣k∣=∥w∥k,负类支持向量距离r−=∣−k∣∥w∥=k∥w∥r_-=\frac{|-k|}{\|w\|}=\frac{k}{\|w\|}r−=∥w∥∣−k∣=∥w∥k,间隔变为:
γ′=k∥w∥+k∥w∥=2k∥w∥\gamma' = \frac{k}{\|w\|}+\frac{k}{\|w\|}=\frac{2k}{\|w\|}γ′=∥w∥k+∥w∥k=∥w∥2k
显然,间隔分子会从222变成2k2k2k。
② 选择k=1k=1k=1而非任意实数的原因
核心依据是超平面参数(w,b)(w,b)(w,b)具有缩放不变性,选择k=1k=1k=1是标准化操作,既不改变超平面本质,又能简化后续优化计算。
- 缩放不变性的本质
超平面方程wTx+b=0w^T x + b=0wTx+b=0中,若对参数www和bbb同时乘以正数1k\frac{1}{k}k1,得到新参数w′=wkw'=\frac{w}{k}w′=kw、b′=bkb'=\frac{b}{k}b′=kb,则新超平面方程为:
w′Tx+b′=1k(wTx+b)=0w'^T x + b'=\frac{1}{k}(w^T x + b)=0w′Tx+b′=k1(wTx+b)=0 - 任意kkk均可转化为k=1k=1k=1的情况
假设初始约定为wTxi+b=±kw^T x_i + b=\pm kwTxi+b=±k,利用上述缩放变换,令w′=wkw'=\frac{w}{k}w′=kw、b′=bkb'=\frac{b}{k}b′=kb,则约束条件可转化为:
w′Txi+b′=wTxi+bk=±kk=±1w'^T x_i + b'=\frac{w^T x_i + b}{k}=\frac{\pm k}{k}=\pm1w′Txi+b′=kwTxi+b=k±k=±1
此时间隔计算结果保持一致:
γ′=2k∥w∥=2k∥k⋅w′∥=2kk⋅∥w′∥=2∥w′∥\gamma'=\frac{2k}{\|w\|}=\frac{2k}{\|k\cdot w'\|}=\frac{2k}{k\cdot\|w'\|}=\frac{2}{\|w'\|}γ′=∥w∥2k=∥k⋅w′∥2k=k⋅∥w′∥2k=∥w′∥2 - 选择k=1k=1k=1的好处
若保留任意常数kkk,后续优化目标(最小化∥w∥2\|w\|^2∥w∥2)中会引入k2k^2k2系数,增加计算复杂度。选择k=1k=1k=1能让约束条件和目标函数达到最简洁的形式,同时不影响最优超平面的求解。
(4)SVM的基本优化目标
SVM的目标是找到最大间隔的划分超平面,也就是最大化间隔γ=2∥w∥\gamma=\frac{2}{\|w\|}γ=∥w∥2。
从数学角度分析,最大化2∥w∥\frac{2}{\|w\|}∥w∥2等价于最小化∥w∥\|w\|∥w∥;为了后续求导计算方便,我们通常将目标函数转化为最小化12∥w∥2\frac{1}{2}\|w\|^221∥w∥2(乘以12\frac{1}{2}21不改变优化的极值点)。
同时,为了保证超平面能正确分类所有样本,需要满足约束条件:所有样本都在支持向量的外侧,即
yi(wTxi+b)≥1(i=1,2,...,m)y_i (w^T x_i + b) \geq 1 \quad (i=1,2,...,m)yi(wTxi+b)≥1(i=1,2,...,m)
综上,SVM的基本优化问题可表示为:
minw,b12∥w∥2s.t.yi(wTxi+b)≥1(i=1,2,...,m)\min_{w, b} \frac{1}{2}\|w\|^2 \quad \text{s.t.} \quad y_i (w^T x_i + b) \geq 1 \quad (i=1,2,...,m)w,bmin21∥w∥2s.t.yi(wTxi+b)≥1(i=1,2,...,m)
6.1.5 关键问题答疑
(1)为什么正例样本代入超平面公式结果大于0?
超平面方程wTx+b=0w^T x + b = 0wTx+b=0的核心作用是将ddd维样本空间划分为两个半空间,划分依据是代入样本点后wTx+bw^T x + bwTx+b的符号,这是人为约定的分类规则:
- 法向量www指向的一侧为正类区域,正例样本(yi=+1y_i=+1yi=+1)落在该侧,因此wTxi+b>0w^T x_i + b > 0wTxi+b>0;
- 法向量www的相反方向为负类区域,负例样本(yi=−1y_i=-1yi=−1)落在该侧,因此wTxi+b<0w^T x_i + b < 0wTxi+b<0。
正例样本不在超平面上,因此代入结果必然不等于0,其符号由所在的半空间决定。
(2)为什么要将约束从wTxi+b>0w^T x_i + b > 0wTxi+b>0加强到wTxi+b≥1w^T x_i + b \geq 1wTxi+b≥1?
将约束条件强化是为了标准化间隔计算,避免因www和bbb的缩放导致距离不唯一:
- 若仅要求wTxi+b>0w^T x_i + b > 0wTxi+b>0,我们可以将www和bbb同时乘以一个正数kkk,得到新的超平面(kw,kb)(kw, kb)(kw,kb)——超平面的位置没有改变,但wTxi+bw^T x_i + bwTxi+b的取值会放大kkk倍,导致样本到超平面的距离计算结果不唯一;
- 将正例约束强化为wTxi+b≥1w^T x_i + b \geq 1wTxi+b≥1、负例约束强化为wTxi+b≤−1w^T x_i + b \leq -1wTxi+b≤−1,相当于固定了支持向量的位置(支持向量满足等号条件),此时间隔的计算有了统一标准,不会因www和bbb的缩放而改变。
(3)6.1节核心逻辑链总结
SVM 6.1节的核心逻辑可概括为:
基本分类目标(超平面划分样本空间)→ 引入间隔提升泛化能力 → 标准化约束固定间隔计算标准 → 转化为数学优化问题
6.1.6 核心符号与公式总结
| 符号/公式 | 含义 |
|---|---|
| www | 超平面的法向量,决定超平面方向 |
| bbb | 超平面的位移项,决定超平面与原点的距离 |
| wTx+b=0w^T x + b = 0wTx+b=0 | ddd维样本空间中线性超平面的方程 |
| ∣w∣|w|∣w∣ | 法向量www的L2范数,计算公式为w12+w22+...+wd2\sqrt{w_1^2+w_2^2+...+w_d^2}w12+w22+...+wd2 |
| $r=\frac{ | w^T x + b |
| γ=2∣w∣\gamma=\frac{2}{|w|}γ=∣w∣2 | SVM的间隔,即两类支持向量到超平面的距离之和 |
| minw,b12∣w∣2s.t.yi(wTxi+b)≥1\min_{w,b}\frac{1}{2}|w|^2 \quad \text{s.t.} \quad y_i(w^T x_i + b)\geq1minw,b21∣w∣2s.t.yi(wTxi+b)≥1 | SVM的基本优化问题 |
6.2 对偶问题与拉格朗日乘子法
6.2.1 核心思想
6.2节的核心是通过拉格朗日乘子法将6.1节的“最大化间隔”原问题,转化为更易求解的对偶问题,并利用拉格朗日对偶性实现约束优化的“无约束化”。这一过程不仅为SVM的高效求解(如SMO算法)奠定基础,也为后续引入核技巧处理非线性问题提供了数学依据。
6.2.2 回顾:原问题——最大化间隔的数学表达(式6.6)
在6.1节中,我们已将“最大化间隔”转化为带约束的凸二次规划问题(式6.6),这是后续推导的起点:
{minw,b12∥w∥2s.t.yi(wTxi+b)≥1(i=1,2,...,m) \begin{cases} \min\limits_{w,b} \quad \frac{1}{2}\|w\|^2 \\ s.t. \quad y_i(w^T x_i + b) \geq 1 \quad (i=1,2,...,m) \end{cases} ⎩⎨⎧w,bmin21∥w∥2s.t.yi(wTxi+b)≥1(i=1,2,...,m)
- 目标函数:12∥w∥2\frac{1}{2}\|w\|^221∥w∥2 是凸函数(二次正定),保证最优解为全局最优;
- 约束条件:yi(wTxi+b)≥1y_i(w^T x_i + b) \geq 1yi(wTxi+b)≥1 要求所有样本在间隔边界外侧或边界上,避免超平面参数缩放导致的歧义。
6.2.3 为什么用拉格朗日乘子法?
原问题是“带不等式约束的极小化问题”,直接求解需同时满足约束和最小化目标,计算复杂。拉格朗日乘子法的核心作用是:
- 将带约束的优化问题转化为无约束的拉格朗日函数嵌套极值问题;
- 利用凸优化的强对偶性(原问题最优值=对偶问题最优值),进一步简化求解;
- 最终得到的对偶问题仅含样本内积,天然适配核技巧。
6.2.4 拉格朗日函数的构建
(1)约束的标准化处理
拉格朗日乘子法要求不等式约束为 gi(w,b)≤0g_i(w,b) \leq 0gi(w,b)≤0 的形式,因此将原约束 yi(wTxi+b)≥1y_i(w^T x_i + b) \geq 1yi(wTxi+b)≥1 变形为:
gi(w,b)=1−yi(wTxi+b)≤0(i=1,2,...,m)
g_i(w,b) = 1 - y_i(w^T x_i + b) \leq 0 \quad (i=1,2,...,m)
gi(w,b)=1−yi(wTxi+b)≤0(i=1,2,...,m)
(2)拉格朗日函数的定义
对于“minf(w,b)\min f(w,b)minf(w,b) s.t. gi(w,b)≤0g_i(w,b) \leq 0gi(w,b)≤0”的问题,拉格朗日函数定义为:
L(w,b,α)=f(w,b)+∑i=1mαi⋅gi(w,b)
L(w,b,\alpha) = f(w,b) + \sum_{i=1}^m \alpha_i \cdot g_i(w,b)
L(w,b,α)=f(w,b)+i=1∑mαi⋅gi(w,b)
其中:
- α=(α1,α2,...,αm)T\alpha = (\alpha_1, \alpha_2, ..., \alpha_m)^Tα=(α1,α2,...,αm)T 是拉格朗日乘子,要求 αi≥0\alpha_i \geq 0αi≥0(不等式约束的乘子非负性条件);
- 第二项通过乘子 αi\alpha_iαi 将约束融入目标函数,实现“无约束化”。
(3)代入SVM原问题,得到拉格朗日函数
将 f(w,b)=12∥w∥2f(w,b) = \frac{1}{2}\|w\|^2f(w,b)=21∥w∥2 和 gi(w,b)=1−yi(wTxi+b)g_i(w,b) = 1 - y_i(w^T x_i + b)gi(w,b)=1−yi(wTxi+b) 代入,展开得两种等价写法:
L(w,b,α)=12∥w∥2+∑i=1mαi[1−yi(wTxi+b)]=12∥w∥2−∑i=1mαi[yi(wTxi+b)−1]
\begin{aligned}
L(w,b,\alpha) &= \frac{1}{2}\|w\|^2 + \sum_{i=1}^m \alpha_i \left[ 1 - y_i(w^T x_i + b) \right] \\
&= \frac{1}{2}\|w\|^2 - \sum_{i=1}^m \alpha_i \left[ y_i(w^T x_i + b) - 1 \right]
\end{aligned}
L(w,b,α)=21∥w∥2+i=1∑mαi[1−yi(wTxi+b)]=21∥w∥2−i=1∑mαi[yi(wTxi+b)−1]
注:两种写法本质一致,后者是将约束项符号整理后的形式,更贴合教材表述。
进一步展开为四项形式,方便后续代入化简:
L(w,b,α)=12wTw+∑i=1mαi−∑i=1mαiyiwTxi−b∑i=1mαiyi
L(w,b,\alpha) = \frac{1}{2}w^T w + \sum_{i=1}^m \alpha_i - \sum_{i=1}^m \alpha_i y_i w^T x_i - b \sum_{i=1}^m \alpha_i y_i
L(w,b,α)=21wTw+i=1∑mαi−i=1∑mαiyiwTxi−bi=1∑mαiyi
6.2.5 核心:拉格朗日函数与原问题的等价性
拉格朗日函数通过min-max嵌套优化实现与原问题的等价,其数学表达式为:
minw,bmaxα≥0L(w,b,α)=原问题的最优值 p∗
\min_{w,b} \max_{\alpha \geq 0} L(w,b,\alpha) = \text{原问题的最优值 } p^*
w,bminα≥0maxL(w,b,α)=原问题的最优值 p∗
我们从内层最大化的数学本质和嵌套优化的层级关系两方面推导等价性。
(1)内层 maxα≥0L(w,b,α)\max_{\alpha \geq 0} L(w,b,\alpha)maxα≥0L(w,b,α):对固定 w,bw,bw,b 求解关于 α\alphaα 的极值
对于任意固定的 w,bw,bw,b,拉格朗日函数 L(w,b,α)L(w,b,\alpha)L(w,b,α) 是关于 α=(α1,...,αm)T\alpha = (\alpha_1,...,\alpha_m)^Tα=(α1,...,αm)T 的线性函数(所有 αi\alpha_iαi 均为一次项)。线性函数的极值由其系数的符号决定,因此分两种情况讨论:
情况1:w,bw,bw,b 违反原约束(存在 iii 使得 gi(w,b)>0g_i(w,b) > 0gi(w,b)>0,即 yi(wTxi+b)<1y_i(w^T x_i + b) < 1yi(wTxi+b)<1)
此时,拉格朗日函数中对应 αi\alpha_iαi 的系数为 gi(w,b)>0g_i(w,b) > 0gi(w,b)>0。
由于 αi≥0\alpha_i \geq 0αi≥0,我们可以令该 αi→+∞\alpha_i \to +\inftyαi→+∞,同时保持其他 αj=0\alpha_j = 0αj=0(j≠ij \neq ij=i)。
代入拉格朗日函数得:
L(w,b,α)=12∥w∥2+αigi(w,b)+∑j≠i0⋅gj(w,b)
L(w,b,\alpha) = \frac{1}{2}\|w\|^2 + \alpha_i g_i(w,b) + \sum_{j \neq i} 0 \cdot g_j(w,b)
L(w,b,α)=21∥w∥2+αigi(w,b)+j=i∑0⋅gj(w,b)
因 gi(w,b)>0g_i(w,b) > 0gi(w,b)>0 且 αi→+∞\alpha_i \to +\inftyαi→+∞,故 αigi(w,b)→+∞\alpha_i g_i(w,b) \to +\inftyαigi(w,b)→+∞,最终:
maxα≥0L(w,b,α)=+∞
\max_{\alpha \geq 0} L(w,b,\alpha) = +\infty
α≥0maxL(w,b,α)=+∞
这一结果的数学意义是:违反约束的 w,bw,bw,b 会被赋予无穷大的“惩罚值”,从而被排除在后续优化的可行域之外。
情况2:w,bw,bw,b 满足所有原约束(对所有 iii 有 gi(w,b)≤0g_i(w,b) \leq 0gi(w,b)≤0,即 yi(wTxi+b)≥1y_i(w^T x_i + b) \geq 1yi(wTxi+b)≥1)
此时,拉格朗日函数中所有 αi\alpha_iαi 的系数 gi(w,b)≤0g_i(w,b) \leq 0gi(w,b)≤0。
由于 αi≥0\alpha_i \geq 0αi≥0,对任意 iii 有 αigi(w,b)≤0\alpha_i g_i(w,b) \leq 0αigi(w,b)≤0,因此:
∑i=1mαigi(w,b)≤0
\sum_{i=1}^m \alpha_i g_i(w,b) \leq 0
i=1∑mαigi(w,b)≤0
代入拉格朗日函数得:
L(w,b,α)=12∥w∥2+∑i=1mαigi(w,b)≤12∥w∥2
L(w,b,\alpha) = \frac{1}{2}\|w\|^2 + \sum_{i=1}^m \alpha_i g_i(w,b) \leq \frac{1}{2}\|w\|^2
L(w,b,α)=21∥w∥2+i=1∑mαigi(w,b)≤21∥w∥2
当且仅当**所有 αi=0\alpha_i = 0αi=0**时,求和项为0,此时 L(w,b,α)=12∥w∥2=f(w,b)L(w,b,\alpha) = \frac{1}{2}\|w\|^2 = f(w,b)L(w,b,α)=21∥w∥2=f(w,b),即:
maxα≥0L(w,b,α)=12∥w∥2=f(w,b)
\max_{\alpha \geq 0} L(w,b,\alpha) = \frac{1}{2}\|w\|^2 = f(w,b)
α≥0maxL(w,b,α)=21∥w∥2=f(w,b)
这一结果的数学意义是:满足约束的 w,bw,bw,b 会保留其原目标函数值,成为后续优化的可行解。
综上,内层最大化的结果可以表示为关于 w,bw,bw,b 的函数:
L(w,b)=maxα≥0L(w,b,α)={+∞,w,b 违反约束12∥w∥2,w,b 满足约束
\mathcal{L}(w,b) = \max_{\alpha \geq 0} L(w,b,\alpha) =
\begin{cases}
+\infty, & w,b \text{ 违反约束} \\
\frac{1}{2}\|w\|^2, & w,b \text{ 满足约束}
\end{cases}
L(w,b)=α≥0maxL(w,b,α)={+∞,21∥w∥2,w,b 违反约束w,b 满足约束
(2)关键问题:对每一组固定的w,bw,bw,b,通过调整α\alphaα实现内层最大化,而w,bw,bw,b 是待定参数,哪来的固定的w,bw,bw,b?
这是嵌套优化的核心逻辑,并非循环:
- 理论上:我们假设所有可能的 w,bw,bw,b 组合都存在(比如二维空间中所有直线),对每一组 w,bw,bw,b 调整 α\alphaα 打分,再通过外层 min\minmin 筛选出分数最低的 w,bw,bw,b。其实是要遍历其定义域内所有w,bw,bw,b。
- 实际中:我们利用强对偶性反转嵌套顺序,避开遍历所有 w,bw,bw,b 的无穷计算,转而求解更简单的对偶问题。
(3)外层 minw,bL(w,b)\min_{w,b} \mathcal{L}(w,b)minw,bL(w,b):与原问题的等价性
外层优化的目标是找到使 L(w,b)\mathcal{L}(w,b)L(w,b) 最小的 w,bw,bw,b。
- 若 w,bw,bw,b 违反约束,L(w,b)=+∞\mathcal{L}(w,b) = +\inftyL(w,b)=+∞,显然不是最小值;
- 若 w,bw,bw,b 满足约束,L(w,b)=12∥w∥2\mathcal{L}(w,b) = \frac{1}{2}\|w\|^2L(w,b)=21∥w∥2,因此外层优化等价于:
minw,b12∥w∥2s.t.yi(wTxi+b)≥1(i=1,...,m) \min_{w,b} \frac{1}{2}\|w\|^2 \quad \text{s.t.} \quad y_i(w^T x_i + b) \geq 1 \quad (i=1,...,m) w,bmin21∥w∥2s.t.yi(wTxi+b)≥1(i=1,...,m)
这正是原问题(式6.6),因此嵌套优化与原问题完全等价。
6.2.6 对偶问题转化:从“min-max”到“max-min”
利用强对偶性(凸优化问题成立),将嵌套顺序反转,得到对偶问题:
maxα≥0minw,bL(w,b,α)=对偶问题的最优值 d∗=p∗
\max_{\alpha \geq 0} \min_{w,b} L(w,b,\alpha) = \text{对偶问题的最优值 } d^* = p^*
α≥0maxw,bminL(w,b,α)=对偶问题的最优值 d∗=p∗
(1)内层 minw,bL(w,b,α)\min_{w,b} L(w,b,\alpha)minw,bL(w,b,α):消去 w,bw,bw,b
对固定的 α\alphaα,对 w,bw,bw,b 求偏导并令导数为0(极值条件):
- 对 bbb 求偏导:∂L∂b=−∑i=1mαiyi=0\frac{\partial L}{\partial b} = -\sum_{i=1}^m \alpha_i y_i = 0∂b∂L=−∑i=1mαiyi=0,得约束:
∑i=1mαiyi=0(6.10) \sum_{i=1}^m \alpha_i y_i = 0 \tag{6.10} i=1∑mαiyi=0(6.10) - 对 www 求偏导:∂L∂w=w−∑i=1mαiyixi=0\frac{\partial L}{\partial w} = w - \sum_{i=1}^m \alpha_i y_i x_i = 0∂w∂L=w−∑i=1mαiyixi=0,得 www 与 α\alphaα 的关系:
w=∑i=1mαiyixi(6.9) w = \sum_{i=1}^m \alpha_i y_i x_i \tag{6.9} w=i=1∑mαiyixi(6.9)
(2)代入消去 w,bw,bw,b,得到对偶目标函数(式6.11)
将式(6.9)、(6.10)代入拉格朗日函数,逐步化简:
步骤1:展开拉格朗日函数
L(w,b,α)=12wTw+∑i=1mαi−∑i=1mαiyiwTxi−b∑i=1mαiyi L(w,b,\alpha) = \frac{1}{2}w^T w + \sum_{i=1}^m \alpha_i - \sum_{i=1}^m \alpha_i y_i w^T x_i - b \sum_{i=1}^m \alpha_i y_i L(w,b,α)=21wTw+i=1∑mαi−i=1∑mαiyiwTxi−bi=1∑mαiyi
步骤2:代入式(6.10)消去 bbb 项
因 ∑i=1mαiyi=0\sum_{i=1}^m \alpha_i y_i = 0∑i=1mαiyi=0,第四项直接为0,函数简化为:
L(w,b,α)=12wTw+∑i=1mαi−∑i=1mαiyiwTxi
L(w,b,\alpha) = \frac{1}{2}w^T w + \sum_{i=1}^m \alpha_i - \sum_{i=1}^m \alpha_i y_i w^T x_i
L(w,b,α)=21wTw+i=1∑mαi−i=1∑mαiyiwTxi
步骤3:代入式(6.9)消去 www 项
-
处理 12wTw\frac{1}{2}w^T w21wTw:代入 w=∑j=1mαjyjxjw = \sum_{j=1}^m \alpha_j y_j x_jw=∑j=1mαjyjxj,得
wTw=(∑j=1mαjyjxj)T(∑k=1mαkykxk)=∑i=1m∑j=1mαiαjyiyjxiTxj w^T w = \left( \sum_{j=1}^m \alpha_j y_j x_j \right)^T \left( \sum_{k=1}^m \alpha_k y_k x_k \right) = \sum_{i=1}^m \sum_{j=1}^m \alpha_i \alpha_j y_i y_j x_i^T x_j wTw=(j=1∑mαjyjxj)T(k=1∑mαkykxk)=i=1∑mj=1∑mαiαjyiyjxiTxj
因此 12wTw=12∑i=1m∑j=1mαiαjyiyjxiTxj\frac{1}{2}w^T w = \frac{1}{2}\sum_{i=1}^m \sum_{j=1}^m \alpha_i \alpha_j y_i y_j x_i^T x_j21wTw=21∑i=1m∑j=1mαiαjyiyjxiTxj。 -
处理 ∑i=1mαiyiwTxi\sum_{i=1}^m \alpha_i y_i w^T x_i∑i=1mαiyiwTxi:代入 wT=∑j=1mαjyjxjTw^T = \sum_{j=1}^m \alpha_j y_j x_j^TwT=∑j=1mαjyjxjT,得
∑i=1mαiyiwTxi=∑i=1m∑j=1mαiαjyiyjxiTxj \sum_{i=1}^m \alpha_i y_i w^T x_i = \sum_{i=1}^m \sum_{j=1}^m \alpha_i \alpha_j y_i y_j x_i^T x_j i=1∑mαiyiwTxi=i=1∑mj=1∑mαiαjyiyjxiTxj
步骤4:合并同类项,得到对偶目标函数
minw,bL(w,b,α)=12∑i,jαiαjyiyjxiTxj+∑iαi−∑i,jαiαjyiyjxiTxj=∑i=1mαi−12∑i=1m∑j=1mαiαjyiyjxiTxj \begin{aligned} \min_{w,b} L(w,b,\alpha) &= \frac{1}{2}\sum_{i,j}\alpha_i\alpha_j y_i y_j x_i^T x_j + \sum_i \alpha_i - \sum_{i,j}\alpha_i\alpha_j y_i y_j x_i^T x_j \\ &= \sum_{i=1}^m \alpha_i - \frac{1}{2}\sum_{i=1}^m\sum_{j=1}^m \alpha_i\alpha_j y_i y_j x_i^T x_j \end{aligned} w,bminL(w,b,α)=21i,j∑αiαjyiyjxiTxj+i∑αi−i,j∑αiαjyiyjxiTxj=i=1∑mαi−21i=1∑mj=1∑mαiαjyiyjxiTxj
(3)对偶问题的完整形式(式6.11)
{maxα∑i=1mαi−12∑i=1m∑j=1mαiαjyiyjxiTxjs.t.∑i=1mαiyi=0 αi≥0, i=1,2,...,m \begin{cases} \max_{\alpha} \quad \sum_{i=1}^m \alpha_i - \frac{1}{2}\sum_{i=1}^m\sum_{j=1}^m \alpha_i\alpha_j y_i y_j x_i^T x_j \\ s.t. \quad \sum_{i=1}^m \alpha_i y_i = 0 \\ \quad\quad\ \ \alpha_i \ge 0,\ i=1,2,...,m \end{cases} ⎩⎨⎧maxα∑i=1mαi−21∑i=1m∑j=1mαiαjyiyjxiTxjs.t.∑i=1mαiyi=0 αi≥0, i=1,2,...,m
(4)对偶问题的优势
- 变量维度降低:对偶变量是 αi\alpha_iαi(共 mmm 个,mmm 为样本数),原问题变量是 www(ddd 维,ddd 为属性数),当 ddd 很大时更易求解;
- 稀疏性:最优解 α∗\alpha^*α∗ 中大部分 αi∗=0\alpha_i^* = 0αi∗=0,仅支持向量对应的 αi∗>0\alpha_i^* > 0αi∗>0,减少计算量;
- 核技巧适配:对偶函数仅含样本内积 xiTxjx_i^T x_jxiTxj,可替换为核函数 κ(xi,xj)\kappa(x_i,x_j)κ(xi,xj),处理非线性问题;
- 后续求解铺垫:求解对偶问题得到 α∗\alpha^*α∗ 后,可通过式(6.9)直接得到 w∗w^*w∗,再利用支持向量的KKT条件求得 b∗b^*b∗。
6.2.7 KKT条件:最优解的必要条件
在强对偶性成立时,原问题与对偶问题的最优解 (w∗,b∗,α∗)(w^*,b^*,\alpha^*)(w∗,b∗,α∗) 满足KKT条件,核心是互补松弛条件:
αi∗⋅gi(w∗,b∗)=0(i=1,2,...,m)
\alpha_i^* \cdot g_i(w^*,b^*) = 0 \quad (i=1,2,...,m)
αi∗⋅gi(w∗,b∗)=0(i=1,2,...,m)
直观意义
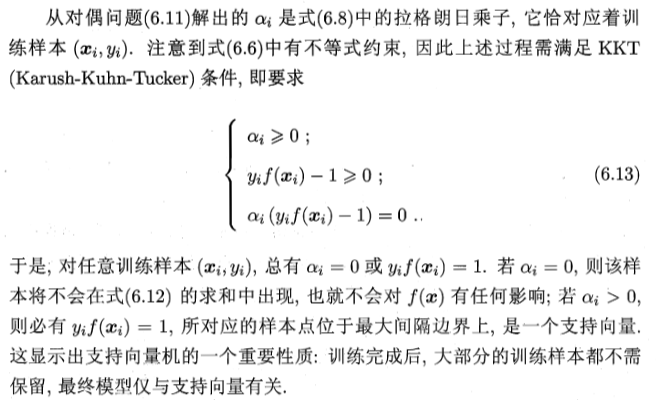
- 若 αi∗>0\alpha_i^* > 0αi∗>0(样本是支持向量),则 gi(w∗,b∗)=0g_i(w^*,b^*) = 0gi(w∗,b∗)=0,即 yi(w∗Txi+b∗)=1y_i(w^{*T} x_i + b^*) = 1yi(w∗Txi+b∗)=1(样本在间隔边界上);
- 若 αi∗=0\alpha_i^* = 0αi∗=0(样本非支持向量),则 gi(w∗,b∗)≤0g_i(w^*,b^*) \leq 0gi(w∗,b∗)≤0,即 yi(w∗Txi+b∗)≥1y_i(w^{*T} x_i + b^*) \geq 1yi(w∗Txi+b∗)≥1(样本在间隔边界外侧,而非内部)。
补充:线性可分SVM的间隔区域(−1<w∗Tx+b∗<+1-1 < w^*{}^T x + b^* < +1−1<w∗Tx+b∗<+1)内没有任何样本,否则会违反约束;只有软间隔SVM(6.4节)允许样本落入该区域。
6.2.9 SMO算法(序列最小优化)
6.2.9.1 提出背景
SMO(Sequential Minimal Optimization,序列最小优化)算法是为解决支持向量机(SVM)对偶问题的高效求解而提出的。
在支持向量机中,对偶问题(式6.11)本质是一个二次规划问题,若使用通用二次规划算法求解,其计算规模会直接正比于训练样本数(设为mmm)。当训练样本量较大时(如万级、十万级),通用算法会因计算开销过高而难以实用。
为避开这一障碍,SMO算法利用对偶问题的自身特性(约束条件、变量关联性),将“同时优化所有变量”转化为“每次仅优化两个变量”,大幅降低计算复杂度,成为求解SVM对偶问题的经典高效算法[Platt, 1998]。
6.2.9.2 核心思路
SMO的核心逻辑围绕“变量分解与局部优化”展开,关键依据是对偶问题的约束条件:
支持向量机对偶问题(式6.11)存在约束 ∑i=1mαiyi=0\sum_{i=1}^m \alpha_i y_i = 0∑i=1mαiyi=0(αi≥0\alpha_i \geq 0αi≥0 是拉格朗日乘子,对应每个训练样本)。若固定除 αi\alpha_iαi 外的所有变量,αi\alpha_iαi 可由其他变量唯一导出(因约束条件需满足总和为0)。
因此,SMO算法不试图一次性优化所有α\alphaα,而是每次仅选择两个变量αi\alpha_iαi和αj\alpha_jαj进行优化,固定其他所有变量。通过这种“小规模局部优化”的迭代,逐步逼近对偶问题的最优解。
6.2.9.3 关键步骤(迭代流程)
SMO算法通过不断重复以下两个步骤,直至收敛(目标函数不再显著下降或满足停止条件):
6.2.9.3.1 步骤1:选取待更新的变量对αi\alpha_iαi和αj\alpha_jαj
变量选择的核心依据是KKT条件 ——若变量不满足KKT条件,说明当前解仍有优化空间,迭代后目标函数会减小[Osuna et al., 1997]。具体选择逻辑为:
- 优先选择违背KKT条件程度最大的变量作为αi\alpha_iαi:KKT条件违背越严重,该变量的优化对目标函数下降的贡献越大。
- 选择与αi\alpha_iαi对应样本“间隔最大”的变量作为αj\alpha_jαj:文档提出启发式规则——两个变量对应的样本差别越大(间隔越大),对它们进行更新时,目标函数的变化幅度越大,收敛速度越快。
6.2.9.3.2 步骤2:固定其他变量,优化αi\alpha_iαi和αj\alpha_jαj
由于存在约束 ∑k=1mαkyk=0\sum_{k=1}^m \alpha_k y_k = 0∑k=1mαkyk=0,当固定除αi\alpha_iαi和αj\alpha_jαj外的所有αk\alpha_kαk时,这两个变量满足线性约束:
αiyi+αjyj=c
\alpha_i y_i + \alpha_j y_j = c
αiyi+αjyj=c
其中c=−∑k≠i,jαkykc = -\sum_{k \neq i,j} \alpha_k y_kc=−∑k=i,jαkyk是常数(由其他变量决定)。
基于此约束,可消去一个变量(如消去αj\alpha_jαj),将双变量优化问题转化为单变量二次规划问题。由于单变量二次规划存在闭式解(无需调用数值优化算法),仅需通过代数推导即可直接计算出更新后的αi\alpha_iαi和αj\alpha_jαj,这也是SMO算法高效的核心原因。
6.2.9.4 核心优势
- 低计算复杂度:每次仅优化两个变量,避免了对所有变量的全局优化,计算开销远低于通用二次规划算法,尤其适合大规模训练数据。
- 依赖闭式解:双变量优化可转化为单变量二次规划,存在闭式解,无需迭代逼近,进一步降低计算成本。
- 收敛性保障:只要选取的变量对中存在不满足KKT条件的变量,每次迭代后目标函数值必减小,确保算法能逐步逼近最优解。
6.2.9.5 与支持向量机的关联
SMO算法的优化结果直接服务于支持向量机的模型构建:
求解出所有αi\alpha_iαi后,可通过式(6.9)计算SVM的核心参数w=∑i=1mαiyixiw = \sum_{i=1}^m \alpha_i y_i x_iw=∑i=1mαiyixi,再通过支持向量(满足αi>0\alpha_i > 0αi>0的样本)计算偏移项bbb(式6.17-6.18)。最终的SVM模型仅与支持向量相关,而SMO算法在求解过程中自然会筛选出支持向量(非支持向量的αi=0\alpha_i = 0αi=0,优化过程中无需关注)。
综上,SMO算法通过“分解变量、局部优化、闭式求解”的策略,高效解决了SVM对偶问题的大规模计算难题,是支持向量机能够落地应用的关键技术之一。
6.3 核函数
核函数是解决原始空间线性不可分,映射高维后可分,但高维计算复杂这一矛盾的核心工具,其核心思想是通过核技巧(Kernel Trick) 避开显式高维映射,直接在原始空间完成高维特征的内积计算。本节从提出背景、核心原理、关键性质、常用类型、实践疑问解答及选型逻辑展开详细讲解。
6.3.1 核函数的提出背景:高维映射的“计算困境”
在机器学习任务中,存在大量原始空间线性不可分的样本(如异或问题),这类样本通常可以通过一个映射函数ϕ\phiϕ映射到高维特征空间F\mathbb{F}F后实现线性可分。
但直接进行高维映射会面临维度灾难:若原始空间是ddd维,映射到高维空间(如d2d^2d2维、甚至无穷维)后,计算样本间的内积ϕ(xi)Tϕ(xj)\phi(x_i)^T\phi(x_j)ϕ(xi)Tϕ(xj)(这是支持向量机对偶问题的核心计算步骤,对应式6.21)的复杂度会急剧升高,高维向量的存储和内积运算甚至无法实现。
核函数的出现正是为了破解这一困境:它无需显式定义特征映射ϕ(x)\phi(x)ϕ(x),而是通过一个原始空间的函数κ(⋅,⋅)\kappa(\cdot,\cdot)κ(⋅,⋅),直接计算出ϕ(xi)\phi(x_i)ϕ(xi)与ϕ(xj)\phi(x_j)ϕ(xj)在高维特征空间的内积,这一策略称为核技巧(Kernel Trick)。
6.3.2 核函数的核心定义与本质
1. 核心定义
设X\mathcal{X}X为原始输入空间,ϕ:X↦F\phi: \mathcal{X} \mapsto \mathbb{F}ϕ:X↦F是从原始空间到高维特征空间F\mathbb{F}F的映射,若存在函数κ(⋅,⋅):X×X↦R\kappa(\cdot,\cdot): \mathcal{X} \times \mathcal{X} \mapsto \mathbb{R}κ(⋅,⋅):X×X↦R,满足:
κ(xi,xj)=ϕ(xi)Tϕ(xj)(6.3.1)
\kappa(x_i, x_j) = \phi(x_i)^T \phi(x_j) \tag{6.3.1}
κ(xi,xj)=ϕ(xi)Tϕ(xj)(6.3.1)
则称κ(⋅,⋅)\kappa(\cdot,\cdot)κ(⋅,⋅)为核函数,F\mathbb{F}F称为核函数对应的再生核希尔伯特空间(RKHS)。
2. 本质:隐式高维映射(非简单符号代换)
核函数的关键价值在于:无需知道ϕ(x)\phi(x)ϕ(x)的具体形式,就能通过原始空间的xi、xjx_i、x_jxi、xj计算高维内积。这里需要明确一个核心认知:核函数不是“高维内积的符号代换”,而是“高维内积的低维等价计算式”,我们可以通过一个具体例子理解:
假设原始空间是二维,样本x=(a,b)x=(a,b)x=(a,b),定义映射ϕ(x)=(a2,2ab,b2)\phi(x)=(a^2, \sqrt{2}ab, b^2)ϕ(x)=(a2,2ab,b2)(将二维映射到三维)。
计算两个样本x1=(a1,b1)x_1=(a_1,b_1)x1=(a1,b1)和x2=(a2,b2)x_2=(a_2,b_2)x2=(a2,b2)的高维内积:
ϕ(x1)Tϕ(x2)=a12a22+(2a1b1)(2a2b2)+b12b22(6.3.2)
\phi(x_1)^T\phi(x_2) = a_1^2a_2^2 + (\sqrt{2}a_1b_1)(\sqrt{2}a_2b_2) + b_1^2b_2^2 \tag{6.3.2}
ϕ(x1)Tϕ(x2)=a12a22+(2a1b1)(2a2b2)+b12b22(6.3.2)
对该式化简可得:
ϕ(x1)Tϕ(x2)=(a1a2+b1b2)2(6.3.3)
\phi(x_1)^T\phi(x_2)=(a_1a_2 + b_1b_2)^2 \tag{6.3.3}
ϕ(x1)Tϕ(x2)=(a1a2+b1b2)2(6.3.3)
其中a1a2+b1b2a_1a_2 + b_1b_2a1a2+b1b2正是原始空间中x1x_1x1和x2x_2x2的内积(记为x1Tx2x_1^T x_2x1Tx2),因此高维内积可等价表示为:
ϕ(x1)Tϕ(x2)=(x1Tx2)2(6.3.4)
\phi(x_1)^T\phi(x_2)=(x_1^T x_2)^2 \tag{6.3.4}
ϕ(x1)Tϕ(x2)=(x1Tx2)2(6.3.4)
此时定义核函数κ(x1,x2)=(x1Tx2)2\kappa(x_1,x_2)=(x_1^T x_2)^2κ(x1,x2)=(x1Tx2)2,该函数完全在原始空间计算(只需计算原始样本内积再平方),但结果与“先映射到三维、再计算高维内积”完全一致。
这一特性在无穷维映射场景下更具价值,比如高斯核对应的映射空间是无穷维,我们无法显式写出无穷维向量,但高斯核的表达式:
κ(xi,xj)=exp(−∥xi−xj∥22σ2)(6.3.5)
\kappa(x_i,x_j)=\exp\left(-\frac{\|x_i - x_j\|^2}{2\sigma^2}\right) \tag{6.3.5}
κ(xi,xj)=exp(−2σ2∥xi−xj∥2)(6.3.5)
仅需计算原始空间中样本的欧氏距离,就能等价得到无穷维空间的内积结果。
6.3.3 核函数的关键性质:合法性判定准则
判断一个函数是否为合法核函数,无需依赖映射ϕ(x)\phi(x)ϕ(x)的具体形式,西瓜书定理6.1给出了充要条件:
一个定义在X×X\mathcal{X} \times \mathcal{X}X×X上的对称函数κ(⋅,⋅)\kappa(\cdot,\cdot)κ(⋅,⋅)是核函数,当且仅当:对任意有限样本集D={x1,x2,...,xm}D=\{x_1,x_2,...,x_m\}D={x1,x2,...,xm},其对应的核矩阵KKK(元素Kij=κ(xi,xj)K_{ij}=\kappa(x_i,x_j)Kij=κ(xi,xj))是半正定矩阵。
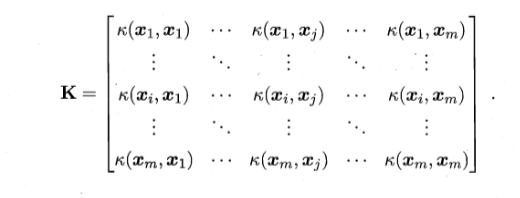
这一性质确保了:只要核函数满足“对称+核矩阵半正定”,就一定存在某个高维特征空间F\mathbb{F}F,使得κ(xi,xj)=ϕ(xi)Tϕ(xj)\kappa(x_i,x_j)=\phi(x_i)^T\phi(x_j)κ(xi,xj)=ϕ(xi)Tϕ(xj)——即核函数隐式定义了一个合法的高维特征空间。
6.3.4 常用核函数:类型、特点及适用场景
实践中已有一批经过验证的常用核函数,可直接根据数据特性选择,下表从表达式、核心参数、映射空间特性、适用场景、调参注意事项、优缺点六个维度进行详细说明:
| 核函数名称 | 表达式 | 核心参数 | 映射空间特性 | 适用场景 | 调参注意事项 | 优缺点 |
|---|---|---|---|---|---|---|
| 线性核 | κ(xi,xj)=xiTxj\kappa(x_i,x_j)=x_i^T x_jκ(xi,xj)=xiTxj | 无参数 | 等价于原始空间的线性分类,无高维映射 | 1. 样本在原始空间近似线性可分(两类样本分布无明显交叉); 2. 样本维度极高(如文本分类的TF-IDF特征,维度可达上万)——高维空间本身易线性可分; 3. 数据量较大的场景 | 无需调参,直接使用 | 优点:计算速度最快,可解释性最强,不易过拟合; 缺点:无法处理强非线性数据 |
| 多项式核 | κ(xi,xj)=(xiTxj+c)d\kappa(x_i,x_j)=(x_i^T x_j + c)^dκ(xi,xj)=(xiTxj+c)d (简化形式c=0c=0c=0时为(xiTxj)d(x_i^T x_j)^d(xiTxj)d) | 1. d≥1d \geq 1d≥1:多项式次数; 2. c≥0c \geq 0c≥0:常数项 | 对应有限维高维空间的线性分类,ddd决定空间维度 | 样本存在中等非线性关系(如样本分布呈二次/三次曲线分隔),且样本量适中 | 1. d=1d=1d=1时退化为线性核; 2. 避免ddd过大(如d>5d>5d>5),否则模型复杂度陡增,易过拟合; 3. 建议从d=2,3d=2,3d=2,3开始尝试 | 优点:可通过参数灵活控制非线性程度; 缺点:ddd过大时泛化能力下降,计算复杂度随ddd升高而增加 |
| 高斯核(RBF核) | κ(xi,xj)=exp(−∣xi−xj∣22σ2)\kappa(x_i,x_j)=\exp\left(-\frac{|x_i - x_j|^2}{2\sigma^2}\right)κ(xi,xj)=exp(−2σ2∣xi−xj∣2) | σ>0\sigma>0σ>0:带宽参数 | 对应无穷维高维空间的线性分类,是最灵活的核函数之一 | 1. 样本存在强非线性关系(如环形分布、螺旋分布); 2. 不知道数据非线性程度时,作为通用核函数兜底; 3. 样本维度较低但非线性明显(如图像分类的低维特征) | 1. σ\sigmaσ控制局部性: - σ\sigmaσ越小:模型关注局部样本,非线性越强,易过拟合; - σ\sigmaσ越大:模型关注全局样本,非线性越弱,趋近线性核; 2. 建议用交叉验证选择最优σ\sigmaσ | 优点:适配绝大多数非线性场景,灵活性最高; 缺点:计算复杂度高于线性核,σ\sigmaσ调参不当易过拟合 |
| 拉普拉斯核 | κ(xi,xj)=exp(−∣xi−xj∣σ)\kappa(x_i,x_j)=\exp\left(-\frac{|x_i - x_j|}{\sigma}\right)κ(xi,xj)=exp(−σ∣xi−xj∣) | σ>0\sigma>0σ>0:带宽参数 | 与高斯核类似,但使用曼哈顿距离而非欧氏距离 | 样本中存在较多噪声或异常值,且非线性程度较强(如传感器采集的含噪数据) | σ\sigmaσ调参逻辑与高斯核一致,但对异常值的鲁棒性更强 | 优点:抗噪声能力优于高斯核; 缺点:计算复杂度与高斯核相当 |
| Sigmoid核 | κ(xi,xj)=tanh(βxiTxj+θ)\kappa(x_i,x_j)=\tanh(\beta x_i^T x_j + \theta)κ(xi,xj)=tanh(βxiTxj+θ) | 1. β>0\beta>0β>0:斜率参数; 2. θ<0\theta<0θ<0:截距参数 | 形式与神经网络的tanh\tanhtanh激活函数一致,等价于浅层神经网络 | 1. 需将SVM与神经网络结合的场景; 2. 处理具有分层非线性的数据 | 必须满足β>0\beta>0β>0且θ<0\theta<0θ<0,否则核矩阵无法保证半正定,导致模型失效 | 优点:可衔接SVM与神经网络的理论体系; 缺点:参数约束严格,实践中泛化能力不如高斯核,使用频率低 |
核函数的组合拓展方式
除了上述常用核函数,还可通过以下方式组合生成新的核函数,以适配更复杂的任务,且组合后的函数仍满足核函数的合法性条件:
- 线性组合:若κ1、κ2\kappa_1、\kappa_2κ1、κ2是核函数,对任意正数γ1、γ2\gamma_1、\gamma_2γ1、γ2,γ1κ1+γ2κ2\gamma_1 \kappa_1 + \gamma_2 \kappa_2γ1κ1+γ2κ2也是核函数;
- 直积组合:κ(xi,xj)=κ1(xi,xj)⋅κ2(xi,xj)\kappa(x_i,x_j)=\kappa_1(x_i,x_j) \cdot \kappa_2(x_i,x_j)κ(xi,xj)=κ1(xi,xj)⋅κ2(xi,xj)(两个核函数的乘积);
- 函数嵌入组合:若κ1\kappa_1κ1是核函数,对任意函数g(x)g(x)g(x),κ(xi,xj)=κ1(g(xi),g(xj))\kappa(x_i,x_j)=\kappa_1(g(x_i),g(x_j))κ(xi,xj)=κ1(g(xi),g(xj))也是核函数。
6.3.5 疑问解答
在核函数的实际应用中,我们通常会面临三个递进式的核心疑问,这三个疑问的解答也正是核技巧的精髓所在。
疑问1:核函数是不是“高维内积的简单符号代换”?
核函数绝不是简单的符号代换,而是通过数学等价性绕开高维空间计算的核心策略。
- 若先构造高维向量ϕ(xi)\phi(x_i)ϕ(xi)再计算内积,是“正向路径”,但该路径在高维/无穷维场景下完全走不通(无法存储或写出无穷维向量);
- 核函数提供了“旁路路径”:直接在原始空间计算κ(xi,xj)\kappa(x_i,x_j)κ(xi,xj),其结果与正向路径的高维内积完全等价,但全程不涉及高维向量的构造或运算。
简言之,核函数是“用原始空间的简单计算,替代高维空间的复杂计算”,而核函数是需要我们自己设计的。
疑问2:不知道映射ϕ\phiϕ的具体形式,如何找到与映射后向量的内积相等的核函数?
教学示例中“先定义映射ϕ\phiϕ,再推导核函数κ\kappaκ”的逻辑,只是为了直观证明高维内积与低维计算的等价性;实际应用中,我们完全不需要知道ϕ\phiϕ的具体形式。
核心问题在于:一个函数能作为核函数使用,是不是一定可以将低维样本映射到某一高维空间,且映射后线性可分,且映射后的向量内积一定等于这个核函数的运算?
关键结论:核函数对应的高维映射与线性可分性
关于核函数与高维空间线性可分性的关系,可拆解为三个结论,其中前两点是必然成立的,第三点是不一定成立的,具体分析如下:
1. 必然成立:核函数一定对应一个高维映射,且映射后向量内积等于核函数运算
选中内容明确指出:只要一个函数是合法核函数(对称+核矩阵半正定),就一定存在对应的映射ϕ\phiϕ,且满足κ(xi,xj)=ϕ(xi)Tϕ(xj)\kappa(x_i,x_j)=\phi(x_i)^T\phi(x_j)κ(xi,xj)=ϕ(xi)Tϕ(xj)。
从理论上讲,这个映射ϕ\phiϕ会将原始低维样本映射到一个称为再生核希尔伯特空间(RKHS)的高维特征空间,而核函数的运算结果,就等价于样本在这个高维空间中的向量内积。这是核函数的固有属性,由定理6.1和RKHS理论严格保证,不需要额外条件。
2. 不一定成立:映射到高维空间后,样本不一定线性可分
核函数只能保证“存在对应的高维空间”,但无法保证样本在这个空间中一定线性可分。
原因如下:
样本的线性可分性,本质取决于数据本身的分布和核函数的适配程度。例如:如果原始数据存在严重的噪声重叠(比如两类样本完全混在一起),即使通过高斯核映射到无穷维空间,样本依然可能不可分;再比如,用线性核(对应原始空间)处理强非线性数据,显然也无法线性可分。这种情况下,需要使用软间隔SVM(允许部分样本违背分类间隔)来解决,而非单纯依赖核函数的高维映射。
补充结论:线性可分性的核心前提
一个合法核函数,必然能将低维样本映射到某一高维RKHS空间,且映射后内积等于核函数运算;但不保证样本在该高维空间中一定线性可分——线性可分性是“数据分布+核函数选型”共同决定的结果,而非核函数的必然推论。
需补充一个关键前提:选择合适的核函数是让样本在高维空间“尽可能近似线性可分”的核心手段,但并非唯一手段;当数据本身存在严重噪声或重叠时,还需要结合软间隔机制来解决。
深层逻辑:核函数选型与极端情况处理
1. 选核函数 = 选高维特征空间
定理6.1明确,合法核函数必然对应一个再生核希尔伯特空间(RKHS)。不同的核函数,本质对应不同的高维特征空间——比如多项式核对应有限维空间,高斯核对应无穷维空间。选择核函数的目标,就是找到那个能让样本在其对应RKHS空间中“最接近线性可分”的核。比如原始空间是环形分布的数据,线性核对应的空间(原始空间)完全不可分,但高斯核对应的无穷维空间就能让样本呈现近似线性可分的分布。
2. 核函数无法解决“完全不可分”的极端情况
若数据本身存在严重的噪声、样本重叠(比如两类样本的特征完全混在一起),即使遍历所有常用核函数,样本在对应的高维空间中也无法实现严格的线性可分。这种情况下,不能只依赖核函数,而是要引入软间隔SVM——它允许部分样本“违背”分类间隔,通过惩罚系数CCC来平衡“分类间隔最大化”和“分类错误最小化”,从而在“近似可分”的前提下构建分类超平面。
结论
核心任务并非“必须通过选核函数实现严格的高维线性可分”,而是通过“核函数选型 + 软间隔机制”的组合,让模型在高维空间中对样本实现最优的近似线性分类:
- 若数据非线性程度低,选线性核+硬间隔即可;
- 若数据非线性程度高,选高斯核/多项式核,尽量让样本在对应高维空间近似可分;
- 若数据存在噪声重叠,再搭配软间隔机制,容忍少量分类错误以获得更鲁棒的模型。
疑问3:样本原始空间线性不可分时,如何确定映射空间?常用核函数如何选择?
(1)关于映射空间的确定
完全不需要显式确定映射到哪个高维空间。
- 理论层面:只要选择的核函数合法(对称+核矩阵半正定),根据再生核希尔伯特空间理论,必然存在至少一个高维特征空间,使得样本在该空间线性可分;
- 实践层面:样本在高维空间是否可分,本质取决于核函数对数据的刻画能力,而非空间的具体形式。比如二次多项式核对应三维映射空间,高斯核对应无穷维映射空间,选对核函数就等于选对了能让样本线性可分的高维空间。
(2)常用核函数的选择依据
核函数的选择需结合数据的非线性程度和数据特性,通用选型流程如下:
- 优先试线性核:计算速度最快、可解释性最强,若效果满足需求,直接使用;
- 线性核效果差,试高斯核:作为通用核函数,适配绝大多数非线性场景,重点调参σ\sigmaσ;
- 特殊场景针对性选择:
- 中等非线性+无噪声→多项式核;
- 强非线性+多噪声→拉普拉斯核;
- 需结合神经网络特性→Sigmoid核。
6.3.6 核函数的核心价值
核函数的本质是**“用原始空间的计算成本,实现高维空间的线性可分”**,它通过核技巧避开了高维映射的显式构造和复杂计算,让“非线性问题线性化”的思路从理论可行落地为实践可用。
在实际应用中,我们无需深究核函数对应的映射ϕ\phiϕ具体形式,只需根据数据特性选择合适的核函数并完成调参,即可高效解决非线性分类任务。
更多推荐

 19
 0
- 0


 已为社区贡献9条内容

所有评论(0)