


- @AI_SHELL


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
最后将 Transfusion 方法扩展到 70 亿参数和 2 万亿多模态 token,能够生成与相似规模的扩散模型和语言模型相媲美的图像和文本,从而获得两个领域的优势。研究者一直试图将语言模型与扩散模型结合,一种方法是直接扩展语言模型,使其能够利用扩散模型作为一个工具,或者将一个预训练的扩散模型嫁接到语言模型上。另一种替代方案是对连续模态进行量化处理,然后在离散的 token 上训练一个标准的语

近期,昆山杜克大学在语音旗舰期刊 IEEE/ACM Transactions on Audio, Speech and Language Processing (TASLP)上发表了一篇题为“Leveraging ASR Pretrained Conformers for Speaker Verification Through Transfer Learning and Knowledge Di

点云编码器将点云信息编码为紧凑的特征表示,随后由大语言模型(LLM)生成描述场景的场景代码(scene codes),这些场景代码可以被进一步转换为三维结构布局。SpatialLM 是一款专门为三维空间理解设计的大语言模型,通过三维点云数据,生成结构化的三维场景理解输出,包括墙壁、门、窗等建筑元素,以及带有语义类别的定向物体边界框。点云数据(Point Cloud)是一种由大量空间点组成的数据集合

Qwen2-Audio 是一个大型的音频语言模型系列,它能够接受音频信号输入,进行音频分析或直接文本响应,支持语音聊天和音频分析两种交互模式,并且提供了预训练模型Qwen2-Audio-7B和聊天模型Qwen2-Audio-7B-Instruct的版本。具体来说,通义千问团队使用 Qwen 语言模型和音频编码器这两个基础模型,接着依次进行多任务预训练以实现音频与语言的对齐,以及 SFT 和 DPO

耿雪龙,徐天翼,魏坤,穆秉甡,薛鸿飞,王贺,李泱泽,郭鹏程,戴宇航,李龙豪,邵明辰,谢磊大语言模型(LLM)在人工智能领域扮演着重要角色,特别是在理解和生成人类语言的能力方面表现突出。研究人员利用LLM的优势,探索将其与语音识别(ASR)等技术相结合的可能性,并已在多个应用场景中取得显著成效。ASR是同时依赖于声学和语言建模的任务,常用的语言模型包括n-gram和神经网络语言模型(NNLM)[1]

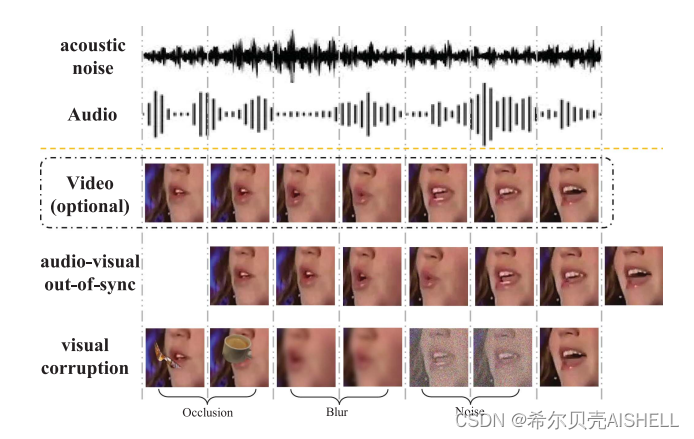
本论文中,我们提出了基于统一跨模态注意力机制的音视频多模态语音识别系统,借助视觉模态中的唇部动作信息提升嘈杂环境下的语音识别性能。在文中,我们还提出了音视频同步性感知训练的策略,既显著缓解了音画不同步对系统性能的负面影响,也能直接用作音视频偏移量的预测任务。此外,我们设计的启发式的模态间注意力对齐方案能够显著降低多模态交互的计算复杂度,并带来进一步的性能增幅。
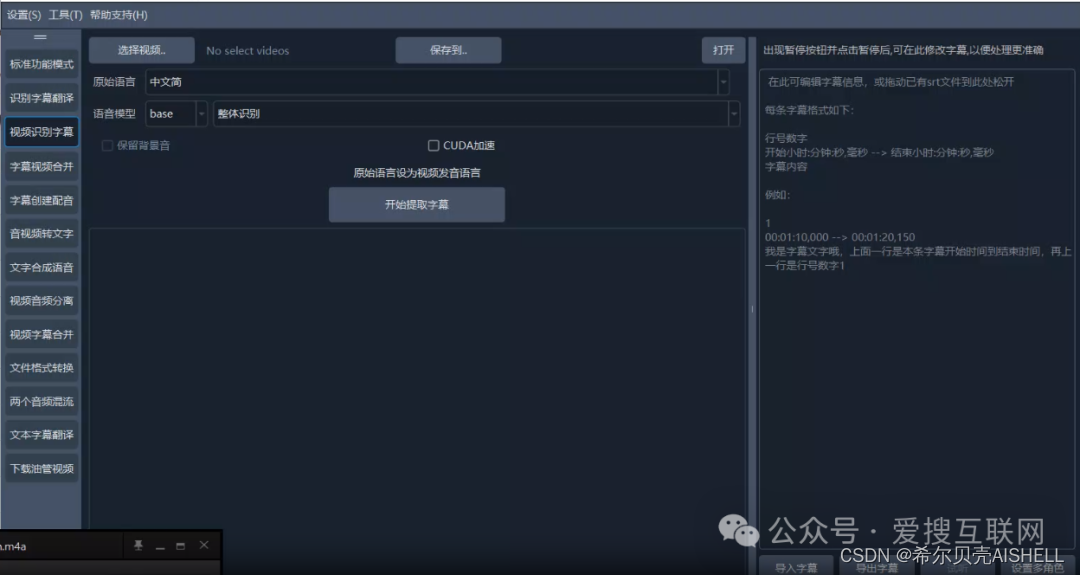
开发者的本地化语音识别、视频翻译和配音工具是一套功能强大的解决方案,非常适合各种音频和视频内容处理需求。无论您是需要转录会议、为视频添加字幕、翻译和配音内容,还是探索其他音频和视频相关任务,开发者的工具都可以帮助您提高效率并获得令人惊叹的结果。我们支持 Microsoft、Google、DeepL、百度和其他领先的翻译引擎,以及 EdgeTTS、OpenAI-tts 和 Elevenlabs 等流
由希尔贝壳、理想汽车、西工大音频语音与语言处理研究组、新加坡南洋理工大学、天津大学、WeNet开源社区、微软、中国信通院等单位发起的“车载多通道语音识别挑战赛”(ICMC-ASR)将作为IEEE声学、语音与信号处理国际会议(ICASSP2024)的旗舰赛事,正式启动。
ISCSLP 2022 将于今年 12月11 - 14日在新加坡举办,会议采用线下和线上相融合的方式,会议上将举办本次竞赛的 Session 和颁奖环节。
本论文中,我们提出了基于统一跨模态注意力机制的音视频多模态语音识别系统,借助视觉模态中的唇部动作信息提升嘈杂环境下的语音识别性能。在文中,我们还提出了音视频同步性感知训练的策略,既显著缓解了音画不同步对系统性能的负面影响,也能直接用作音视频偏移量的预测任务。此外,我们设计的启发式的模态间注意力对齐方案能够显著降低多模态交互的计算复杂度,并带来进一步的性能增幅。