- @ADICDFHL


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
64位光刻ROM编码每个DS18B20的片内ROM都存有一个独一无二的64位编码。在该ROM编码的低8位保存有DS18B20的分类编码:28h;中间的48位是独一无二的序列号;最高8位是前面56位的CRC循环冗余校验码(CRC=X8+X5+X4+1)。因为每个DS18B20的序列号都不一样,所以一条总线上可以控制多个DS18B20。
图像分割将具有不同语义的像素进行分组,例如类别或实例成员关系。每种语义选择都定义了一个任务。尽管每个任务的语义不同,但当前的研究集中于为每个任务设计专门的架构。我们提出了一种新的架构,称为Masked-Attention Mask Transformer(Mask2Former),它能够处理任何图像分割任务(全景、实例或语义)。其关键组件包括掩码注意力,通过将交叉注意力限制在预测的掩码区域内,提取
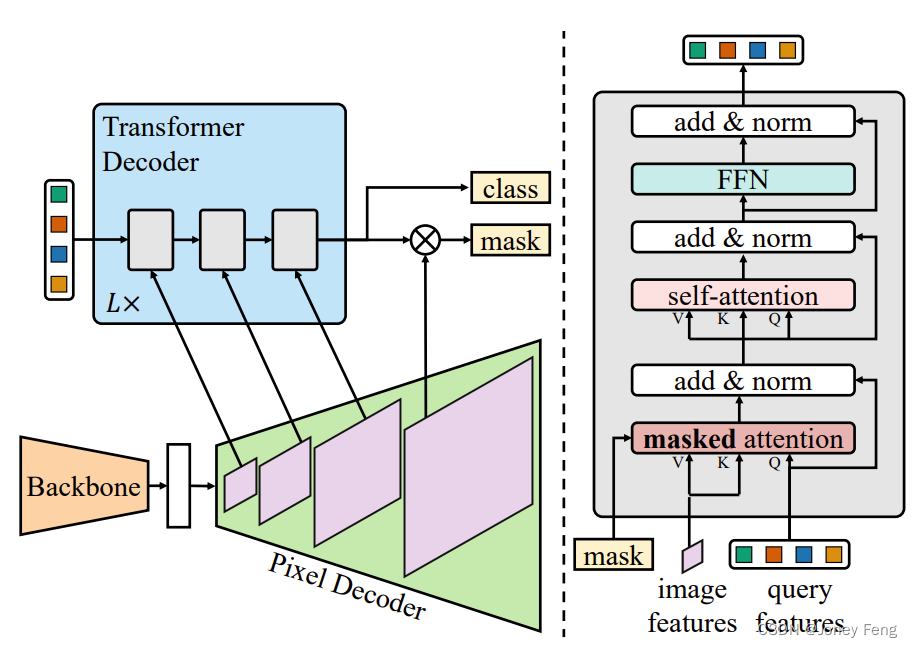
图像分割将具有不同语义的像素进行分组,例如类别或实例成员关系。每种语义选择都定义了一个任务。尽管每个任务的语义不同,但当前的研究集中于为每个任务设计专门的架构。我们提出了一种新的架构,称为Masked-Attention Mask Transformer(Mask2Former),它能够处理任何图像分割任务(全景、实例或语义)。其关键组件包括掩码注意力,通过将交叉注意力限制在预测的掩码区域内,提取
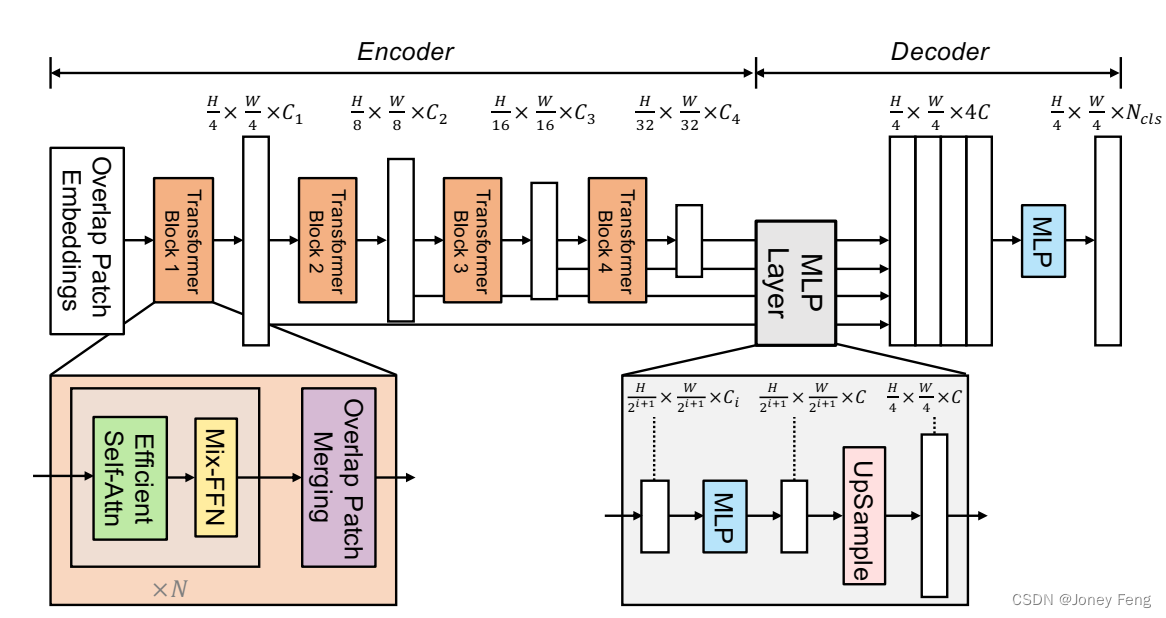
我们提出了SegFormer,这是一个简单、高效且强大的语义分割框架,它将Transformer与轻量级多层感知机(MLP)解码器结合在一起。SegFormer具有两个吸引人的特点:1)SegFormer包含一个新颖的层次结构的Transformer编码器,它输出多尺度特征。它不需要位置编码,从而避免了位置编码的插值问题,当测试分辨率与训练不同时,导致性能下降。2)SegFormer避免了复杂的解
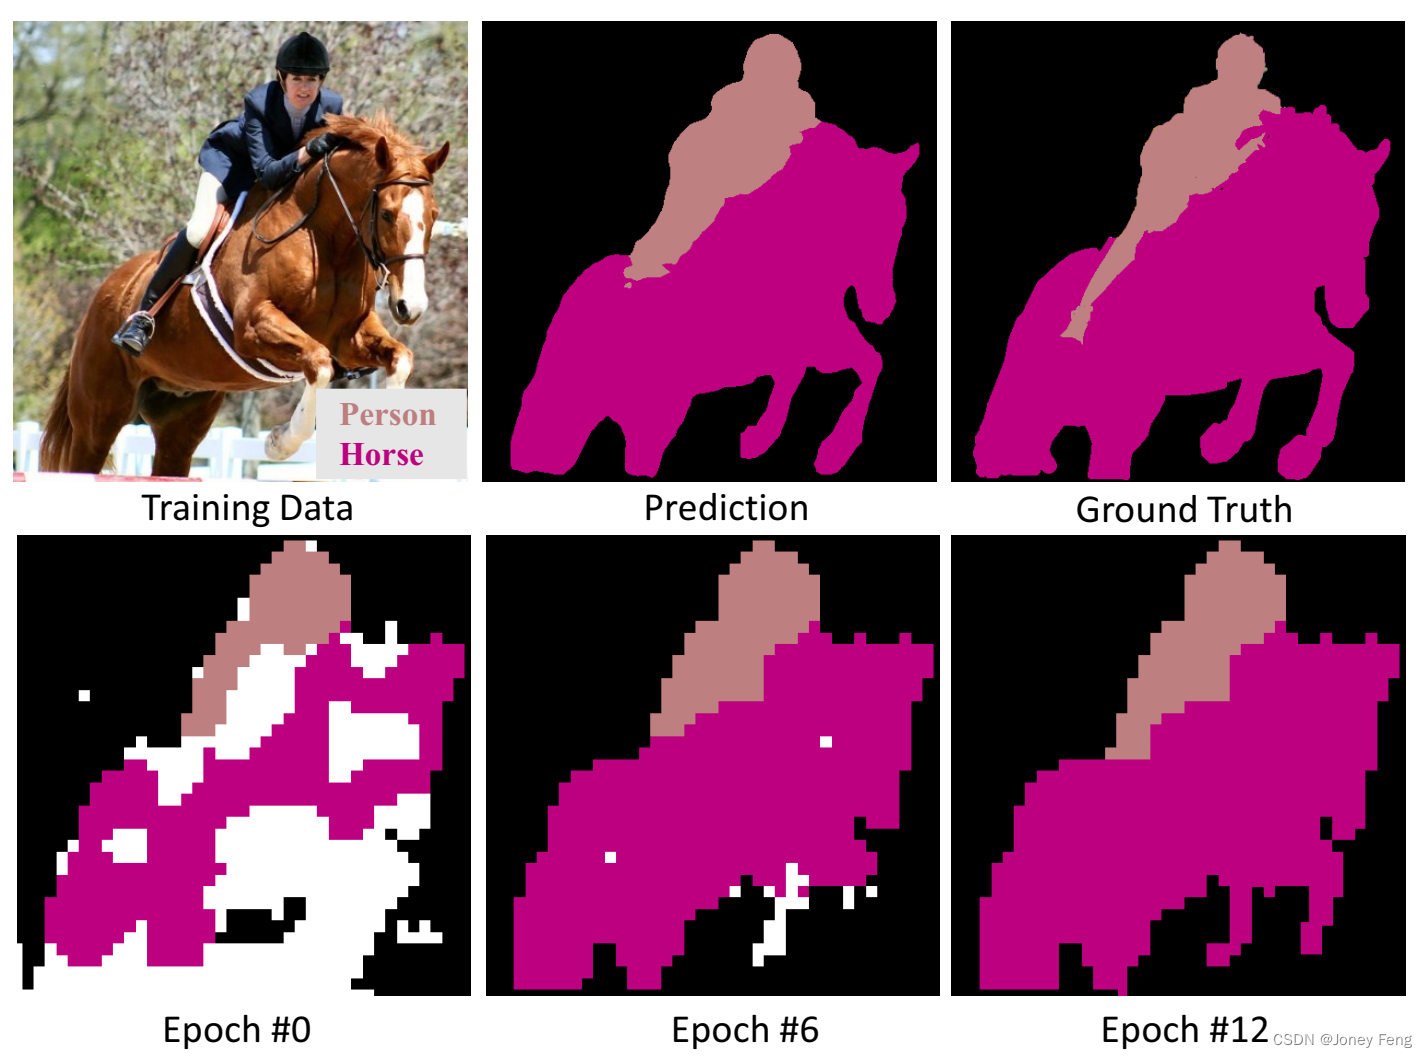
本文研究了只使用图像级别标签作为监督来学习图像语义分割网络的问题,这是重要的,因为它可以显著减少人工标注的工作量。最近在这个问题上的最新方法首先使用深度分类网络推断出每个对象类的稀疏和有区别的区域,然后使用有区别的区域作为监督来训练语义分割网络。受传统图像分割方法中种子区域生长的启发,我们提出了一种从有区别的区域开始训练语义分割网络,并逐渐增加像素级别监督的方法,通过种子区域生长引入。种子区域生长
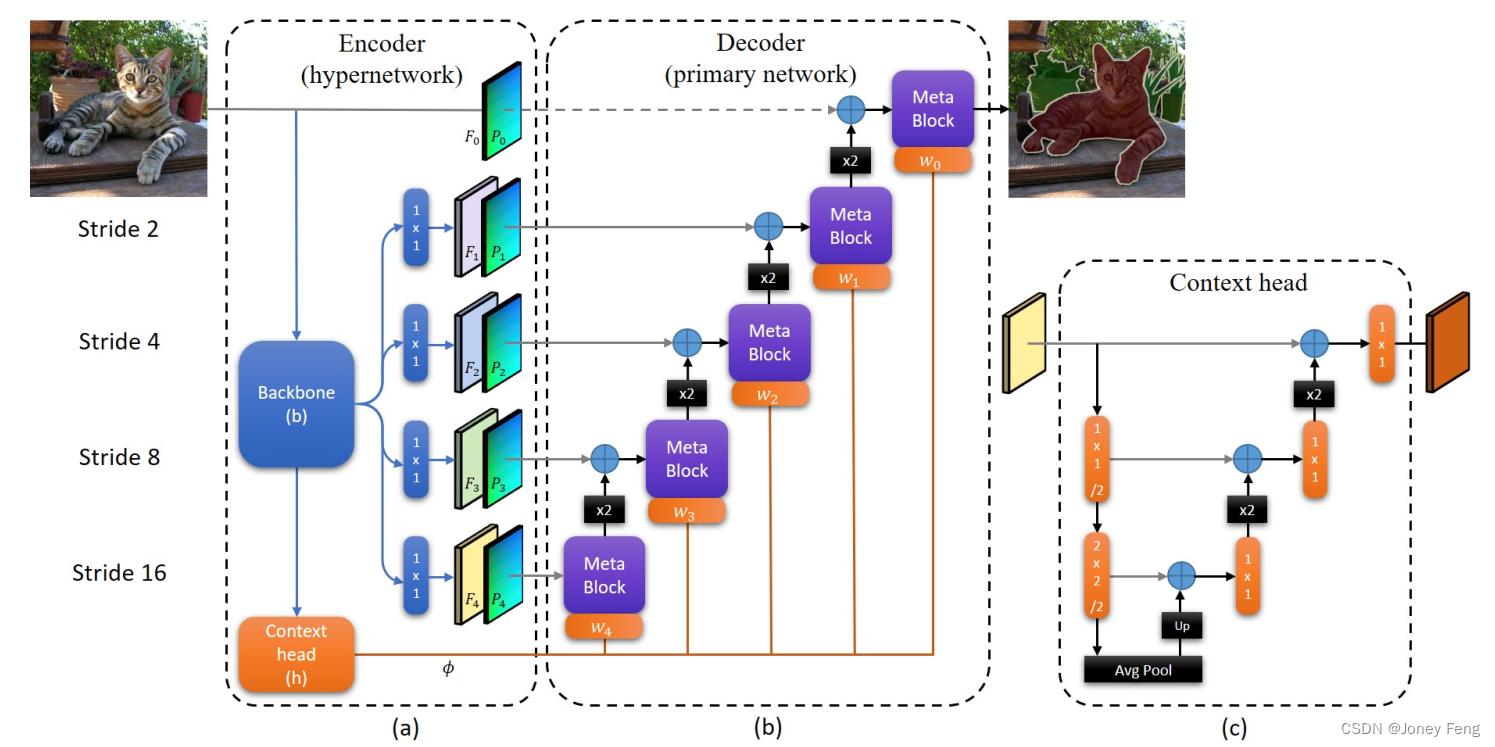
我们提出将自编码器与超网络结合起来,用于语义分割任务。在我们的方案中,超网络由三个网络组成:语义分割编码器的骨干网络b,一个内部U-Net形式的上下文头h和多个权重映射头wi。解码器是一个多块解码器,其中每个块di实现局部连接层。结果是一种新型的U-Net,能够动态地、局部地适应输入,因此有潜力更好地定制分割过程以适应输入图像。正如我们的实验所显示的,我们的方法在这个非常具有竞争力的领域中,通过多
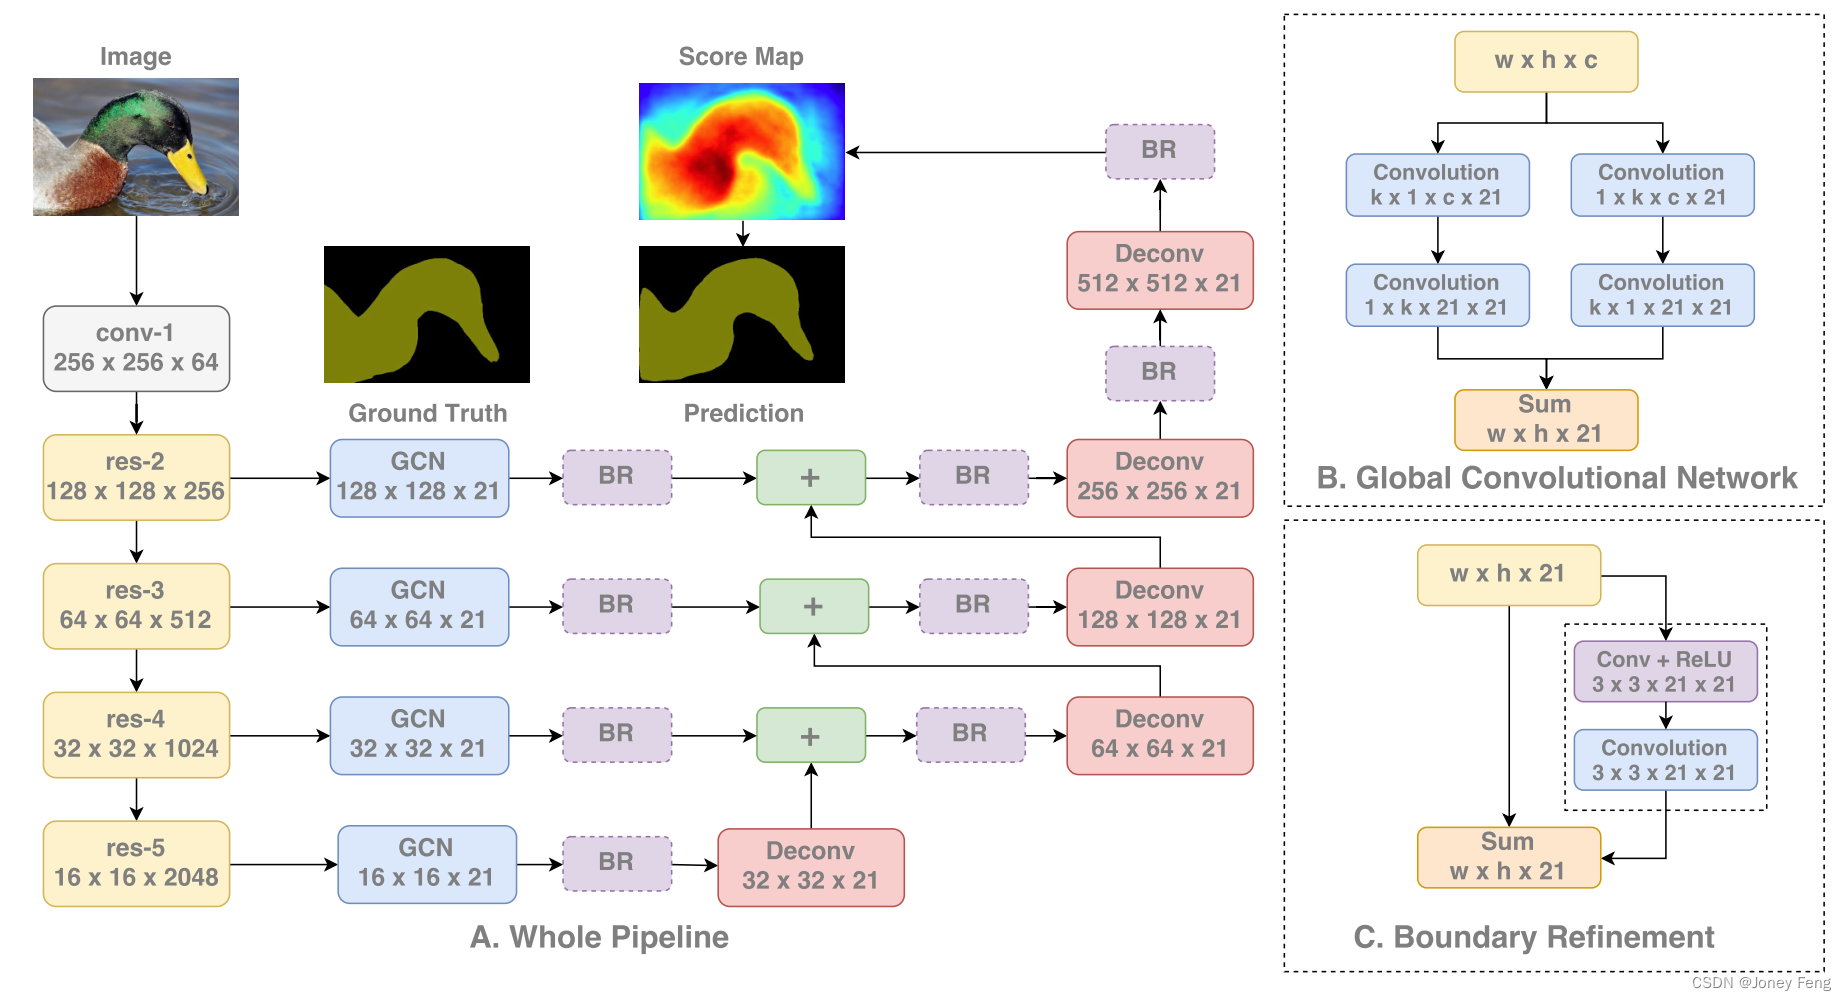
根据我们对分类和分割的分析,我们发现大尺寸的卷积核对于缓解分类和定位之间的矛盾非常重要。遵循大尺寸卷积核的原则,我们提出了全局卷积网络。消融实验表明,我们提出的结构在有效感受野和参数数量之间取得了良好的平衡,并取得了良好的性能。为了进一步精细化物体边界,我们提出了一种新颖的边界细化模块。从定性上看,我们的全局卷积网络主要改善了内部区域,而边界细化则提高了边界附近的性能。我们的最佳模型在两个公共基准
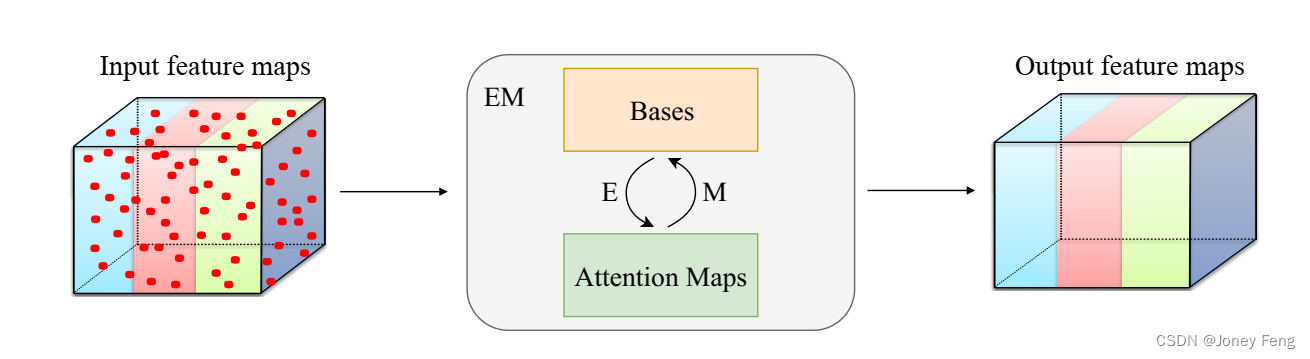
在本文中,我们提出了一种新型的注意力机制,即期望最大化注意力(EMA),它通过迭代执行EM算法计算出更紧凑的基础集。EMA的重建输出是低秩的,并且对输入的变化具有鲁棒性。我们将所提出的方法形式化为轻量级模块,可以轻松插入到现有的CNN中,代价很小。在许多基准数据集上的广泛实验表明了所提出的EMAU的有效性和效率。
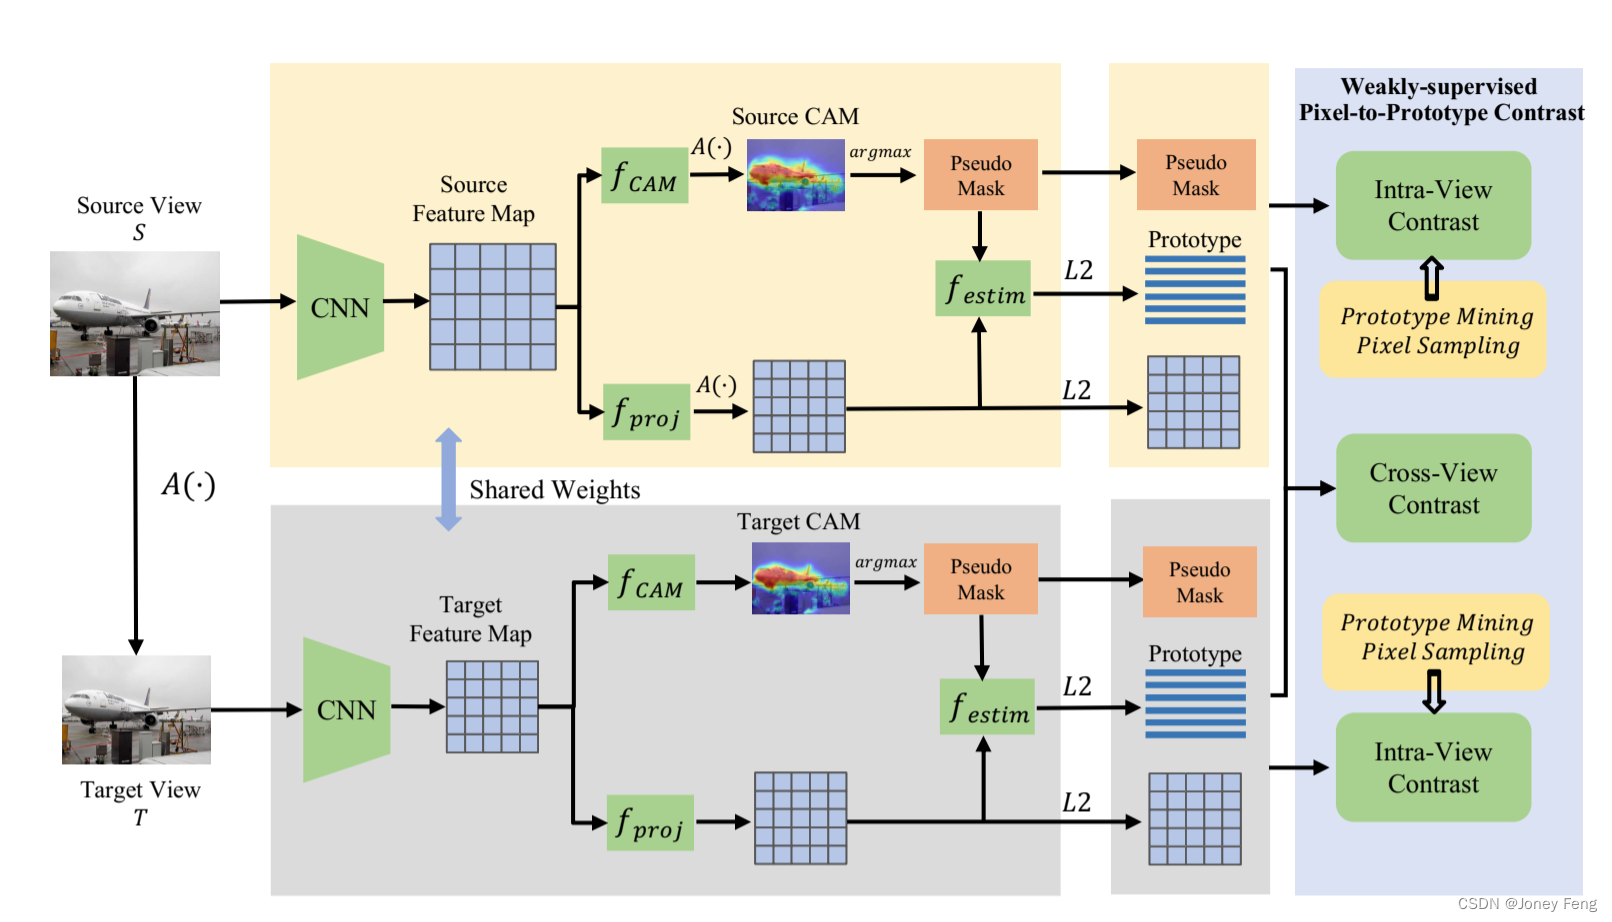
在本文中,我们提出了弱监督像素到原型对比的方法,该方法提供像素级的监督信号,以缩小监督差距并改进图像级弱监督语义分割。像素到原型对比在图像的交叉视图和内部视图上进行,通过施加交叉视图特征语义一致性正则化和促进特征空间内(类间)紧密性(离散性),来改善图像级弱监督语义分割。大量实验证实了我们方法的优越性。在未来,我们将探索更多的原型估计方式和我们方法的更多应用场景,例如全监督和半监督分割。
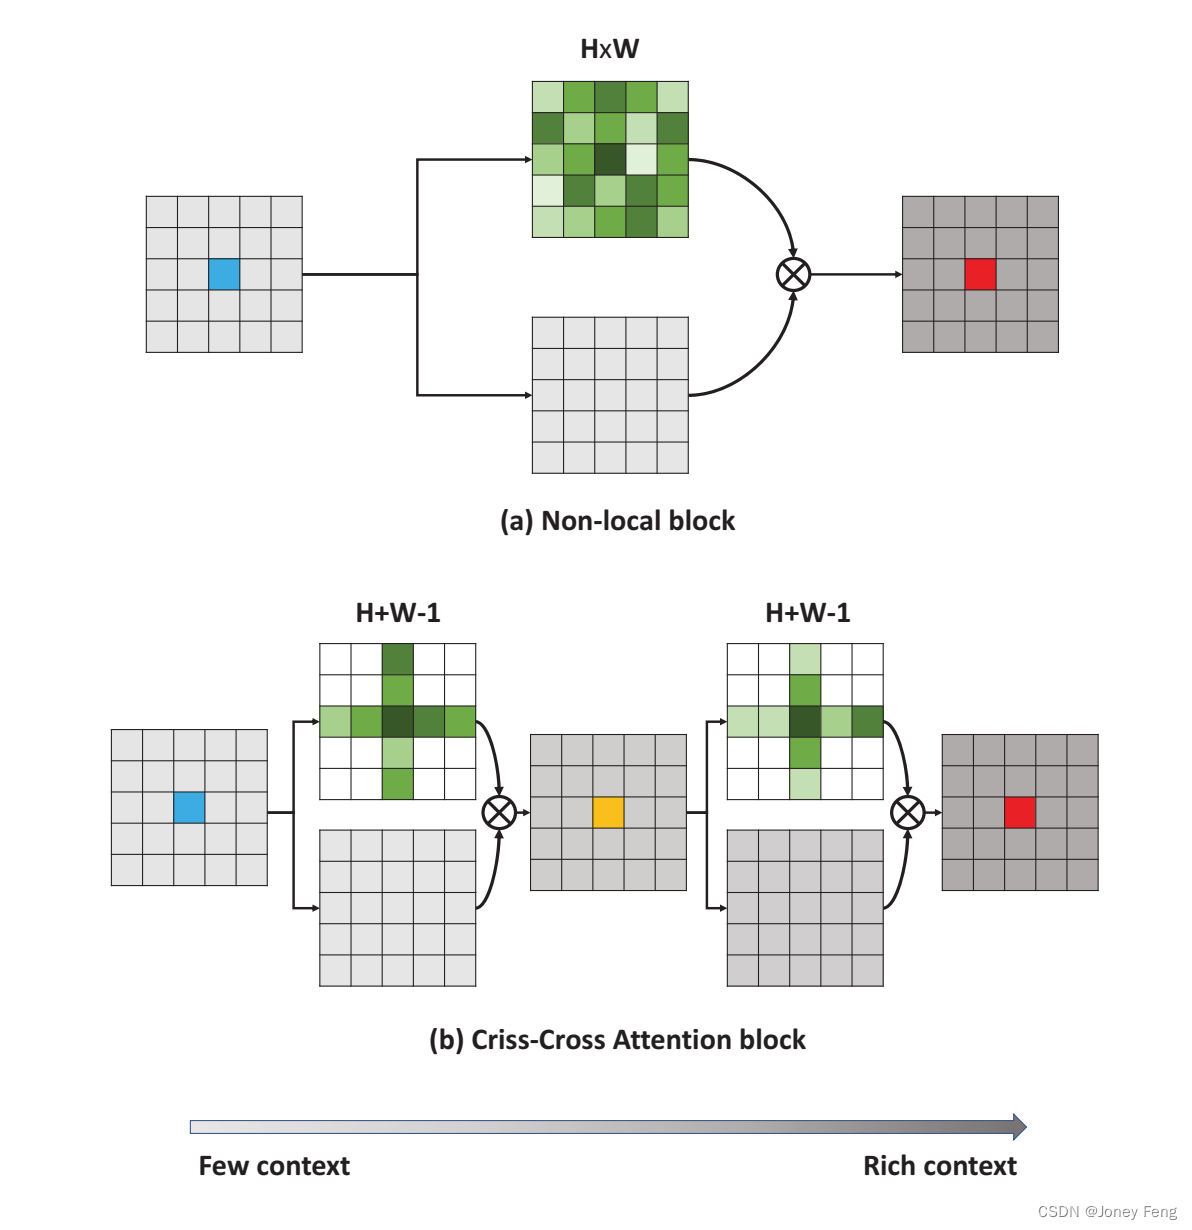
全图像依赖关系为视觉理解问题提供了有用的上下文信息。在这项工作中,我们提出了一种称为Criss-Cross Network(CCNet)的方法,以更有效和高效的方式获取这种上下文信息。具体而言,对于每个像素,CCNet中的一种新颖的交叉注意力模块收集其交叉路径上所有像素的上下文信息。通过进一步的循环操作,每个像素最终可以捕捉到来自所有像素的全图像依赖关系。总体而言,CCNet具有以下优点:1)占用