
国内外知名大模型及应用——模型/应用维度
- **Deepmind:**国外闭源组新增图像模型 **Gemini 3.1 Flash-Lite Image(Nano Banana 2 Lite),**视频模型 Gemini Omni Lite;
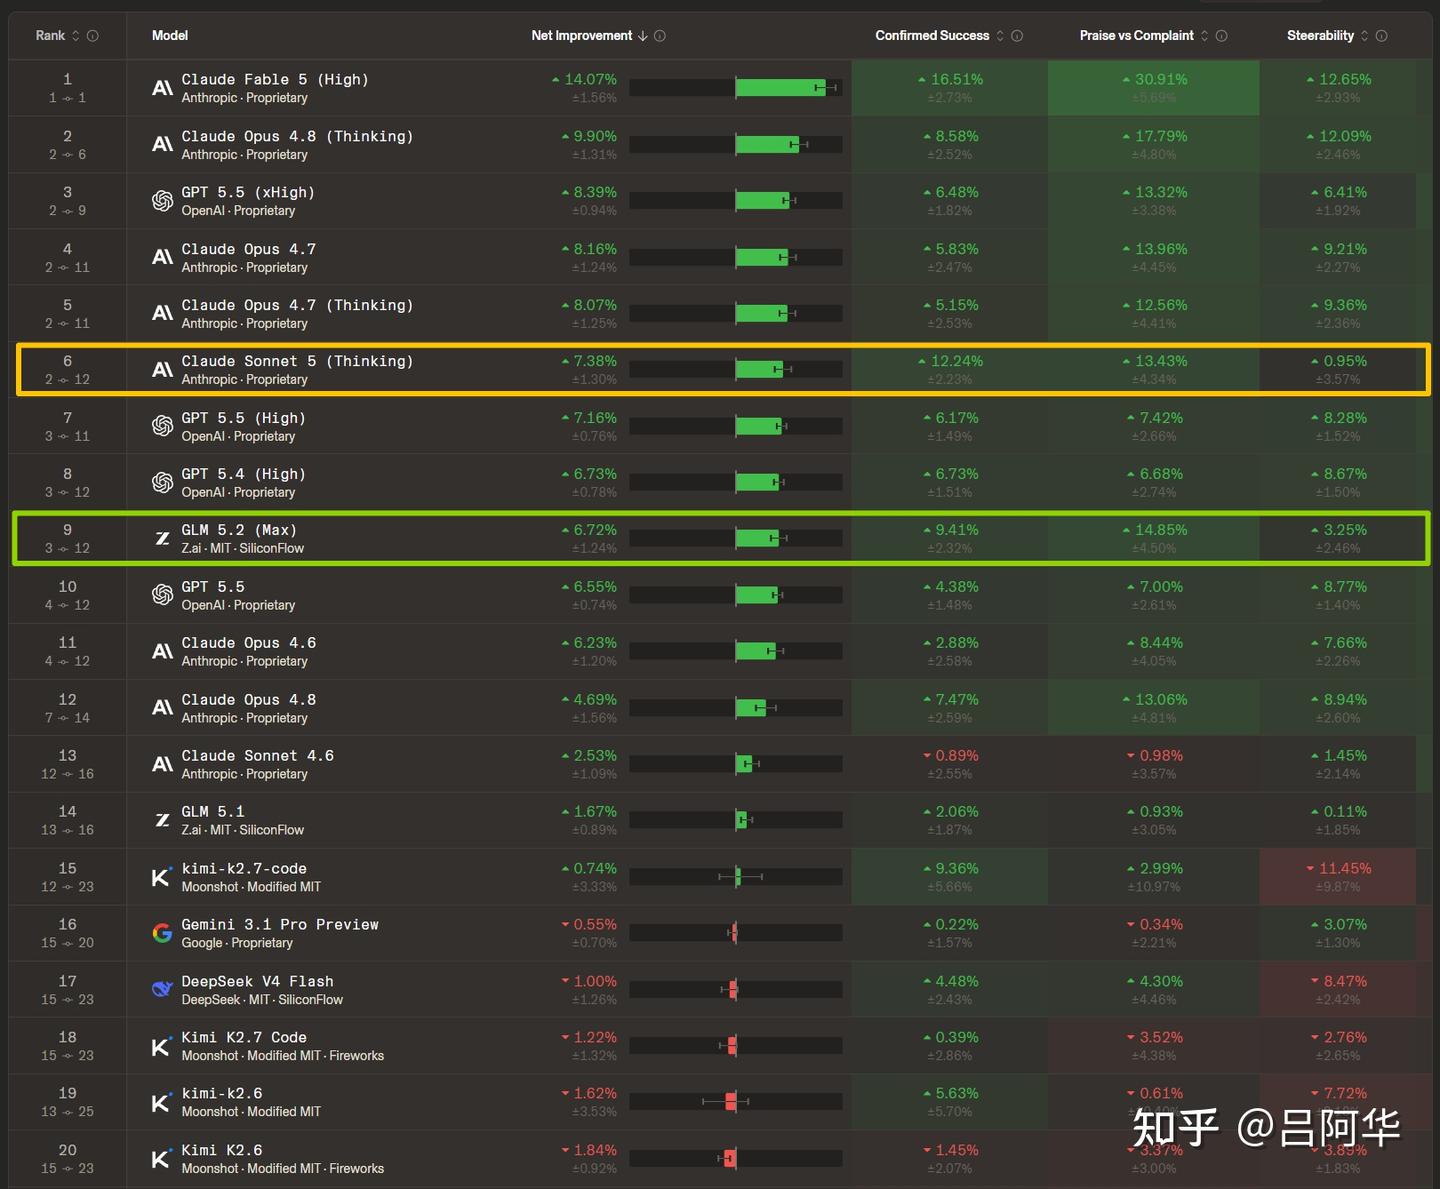
LMSYS Arena竞技场Agent榜(2026/07/06 快照)。Sonnet 5进入战场,A社前十占半壁。国产GDK三剑客围剿Gemini。
**注:*
- *目前Agent模型已占大半壁江山,但大类名暂时还叫通用类;*
- *推理模型这个单独的类别已经没有存在的理由,进入2026下半年不再更新,计划等2027年删除该类别。*
- *OCR模型、3D模型还不足以成类,先不加入本文。*
----- 国外部分 -----
经过了两年的发展,国内外AI大模型的差距在不断缩小,但整体国外仍有一个身位的领先优势,尤其是通用模型。Google,OpenAI,Anthropic这三家公司除了性能交替领先,更重要的是行业趋势目前仍然一直由这几家公司把握。
国外的大模型大多数都需要架梯翻墙才能访问,而且由于生成的内容相对自由,国内企业使用起来可能会要注意合规风险。
闭源组
通用类
OpenAI 于 2026 年 6 月推出的 Agent 模型,包括旗舰模型 Sol、平衡型 Terra 和快速经济型 Luna 三个版本。其中Terra在性能接近 GPT-5.5 的同时成本降低一半。
GPT-5.6 Sol是OpenAI迄今最强的模型,在编码、生物学和网络安全领域展现出显著提升的自主智能体能力。编码方面,它在测试命令行工作流的Terminal-Bench 2.1上创下新纪录;生物学方面,在GeneBench v1的长程基因组学分析中表现优于GPT-5.5且消耗token更少;网络安全方面,它在ExploitBench上以仅约三分之一于Mythos Preview的输出token达到同等竞争力,并在ExploitGym上随推理增强呈现阶梯式提升,同时未跨越网络安全关键阈值,未能自主生成完整漏洞利用链
GPT-5.6系统在推理机制上引入了超越此前高推理档的max深度推理模式,以及通过子智能体协同加速复杂任务的ultra模式;在安全层面上配备了 OpenAI 迄今最 robust 的分层防护体系,包括模型级拒绝训练、实时生成监控与暂停审查、账户级行为分析,以及差异化访问控制。
- Gemini 3.5 Flash: https://deepmind.google/models/gemini/
Google Deepmind 在 2026年5月份发布的 Agent 模型,该模型是 Google DeepMind 面向 Agent 与编码场景推出的高性能模型,支持 128k 平均上下文及 1M token 的长文本处理。其核心能力集中在快速迭代式编码、高级多模态理解、长时程复杂工作流执行与多步工具调用推理,可在 60 秒内并行生成多种 UI 方案或创意变体。在 MCP Atlas 多步工作流、Toolathlon 通用工具使用、金融 Agent 分析、CharXiv 图表推理 与 MMMU-Pro 多模态理解等多个基准上取得领先或持平成绩,体现出在保持高速响应的同时逼近甚至部分超越旗舰级模型前沿性能的独特优势。
- Claude: https://claude.ai/
Claude Fable 5/Mythos 5
2026年6月发布的 Agent 模型,模型在软件工程、知识工作、多模态视觉、科学研究等绝大多数测试中都达到了SOTA水平。
Fable 5 仅用 1 天时间就完成了全团队需要耗时两个多月的 5000 万行代码迁移工作;模型可以保持长程专注,具备自我记录与修正能力,自主通关了《Pokémon FireRed》和《Slay the Spire》等复杂游戏;它将药物设计过程加速了约 10 倍,能自主提出新型分子生物学假设和训练ML模型;不过安全策略比较保守,能自主拦截问题或分流至Opus 4.8。
Mythos 5 和 Fable 5的差别主要在于安全策略上,由于该版本只对特定用户开放,安全策略也更宽松。
Claude Sonnet 5
2026年6月发布,维持了 1M Token 的上下文窗口,最大输出 Token 从 Sonnet 4.6 的 64k 提升至 128k。 相相比4.6,Sonnet 5的 Agent 能力的跨越式提升,它的持久化记忆利用率更高,能够自主制定计划、调用浏览器和终端等工具,并在无监督的情况下执行多步骤复杂任务,其性能已接近旗舰级的 Opus 4.8;安全性方面,幻觉率、谄媚行为等不良输出率较 Sonnet 4.6 有所降低,对提示注入攻击的抵抗力也有所增强;具备自适应思考模式。
Claude Opus 4.8
2026年5月,在Opus 4.6 和 4.7 连续在LMSYS霸榜三个多月后发布,进一步巩固领先优势。Opus 4.8 在 4.7 的基础上进行了全方位基准测试提升,价格与 Opus 4.7 保持不变。模型性能在编码、智能体、多模态推理等长周期、高风险的企业级工作流中表现出更强的判断力和可靠性,诚实性大幅提升。Opus 4.8 推出了全新的“快速模式(Fast mode)”,速度提升 2.5 倍的同时,运行成本比前代模型的快速模式便宜了 3 倍。
Opus 4.8还推出三个新特性。其中**动态工作流(Dynamic Workflows)**允许在 Claude Code 中单次会话并行调度数百个子智能体,具备执行数十万行代码库级迁移与合并的超大规模自动化能力;思考力度控制(Effort Control)让用户可在全方案中自主调节模型的思考深度(低、高、额外、最大),平衡响应速度、token消耗与输出质量。另外,Messages API 支持在中途插入系统信息,无需刷新提示词缓存即可动态调整智能体运行环境。
Claude Haiku 4.5
2025年10月发布,在保持与Claude Sonnet 4相近性能的同时,实现了超过2倍的响应速度和仅为1/3的运营成本;
封号最猛也是唯一家公开反华的模型厂,倡议大家在有平替的前提下尽量不要为它家充值。
- Grok 4.3: https://grok.x.ai/
xAI 2026年5月发布的混合推理模型。
法国Mistral AI发布的闭源大模型。2025年5月发布Mistral 3 Medium。除了便宜,没有更多量化的公开指标。2024年7月发布了Mistral Large 2,拥有128K 上下文,参数**123B,**详见《Large Enough》——Mistral Large 2简介。尽管作为欧洲独苗,MistralAI最近不太参与通用模型的竞争,专注于小模型和一些细分领域的小创新,但业内人士应该还记得Mixtral 8x7B发布时对行业的贡献。
推理类
- GPT
2026年4月发布推理模型 GPT-5.5 thinking。它是为需要快速逻辑拆解和深度思考的过程而设计的,其核心特征在于它不仅仅给出答案,而是优化了内部的“思考链路”。与以往模型可能存在的冗余解释不同,Thinking 版本更倾向于直接切中要害,提供经过逻辑提炼后的简洁回答,减少了用户的阅读负担。它能够迅速识别复杂问题中的核心变量,并在后台完成 CoT 的构建。它最适合用于头脑风暴、策略规划、代码架构的初步设计,以及那些需要严谨逻辑但追求即时反馈的决策辅助场景。
4月发布专业推理模型GPT-5.5 Pro。模型旗舰版本,代表了目前大模型所能达到的最高智能水平。它是为了应对那些“不容有失”且对人类而言极具挑战性的任务而打造的。Pro 版本专门针对 FrontierMath(前沿数学)和 Expert-SWE(专家级软件工程)等基准测试进行了极限调优。在处理需要数小时甚至数十小时才能解决的复杂工程问题时,它拥有比 Thinking 版本更高的成功率和更低的幻觉率。Pro 版本在推理时会投入更多的计算资源,响应延迟相对较高,这种延迟被视为确保高质量输出的必要权衡。在面对多步骤、长程的自主代理任务时,Pro 版本的“自我纠错”机制更为顽健,能够更有效地识别并修复在跨工具协作中产生的微小偏差。
- Gemini
Google Deepmind发布的推理模型,2026年2月份发布了 Gemin 3.1 Pro,在基于代码的动画、复杂系统综合能力、交互式设计、创意编程等各维度能力提升。
2025年11月发布 Gemin 3 Deep Think*。*在推理、多模态理解和智能体能力上实现了质的飞跃。Gemini 3 Pro在几乎所有主要的 AI 基准测试中都显著优于 2.5 Pro;Gemini 3 Deep Think 作为全新的增强推理模式,在高难度测试中表现卓越,并在 ARC-AGI-2 上取得了 45.1% 的突破性成绩。详见《如何评价谷歌在2025年11月18日凌晨发布的gemini3.0pro模型?》
- Claude
Anthropic发布的推理模型,2026年5月发布Claude Opus 4.8 **Thinking。推出了思考力度控制(Effort Control)**功能,用户可在全方案中自主调节模型的思考深度(低、高、额外、最大),平衡响应速度、token消耗与输出质量(默认设置为“高”)。
- Grok
xAI发布的推理模型,2025年11月发布Grok 4.1 Thinking。
- Magistral
Mistral发布的推理模型,2025年9月发布了的Magistral Medium v1.2,增加了多模态支持,提升了模型本身和工具使用时的智能。整体性能在第二梯队,主要优点是快。
图像类
- Google Deepmind
Gemini 3.1 Flash-Lite Image(Nano Banana 2 Lite):Gemini 3.1 Flash-Lite Image – Nano Banana 2 Lite
2026年7月 Google DeepMind 推出的轻量级图像生成与编辑模型,其核心定位是在保持高质量输出的同时实现极致的速度与成本优化。该模型具备闪电般的低延迟响应能力,能够以远低于重型生产模型的成本批量生成数千张图像,同时不牺牲质量,延续了 Nano Banana 系列在角色一致性、视觉精确编辑和真实世界知识调用方面的优势。
Gemini 3.1 Flash Image(Nano Banana 2):Nano Banana 2 - Gemini AI 圖像生成器和相片編輯器
2026年2月Google Deepmind更新的Gemini原生的图像生成能力。模型依托 Gemini 的广泛世界知识和实时网络搜索能力,能够更准确地还原特定主题,并支持将笔记转化为图表、生成数据可视化信息图等复杂任务。在文本渲染方面,Nano Banana 2 实现了显著升级,可在图像中生成清晰可读的文字,并支持多语言翻译和本地化,满足营销物料和全球化内容创作需求。创作控制层面,模型可在单个工作流中保持最多五个角色的形象一致性和最多14个物体的保真度,同时严格遵循复杂的多层指令,支持从512像素到4K的多种分辨率以及包括4:1、1:4、8:1、1:8在内的多种宽高比。
Gemini 3 Pro Image(Nano Banana Pro):https://blog.google/technology/ai/nano-banana-pro/
2025年11月Google Deepmind更新的Gemini原生的图像生成能力。相比于前一个版本更擅长二创的Nano Banana,Pro版本基于Gemini 3强大的推理能力和世界知识,文生图的能力也显著加强,多语言文本的渲染大幅升级;二创时支持参考多达14张图像,并保持多达5个人物的一致性和相似度,以及更加精细化的图片局部编辑。详见《如何评价谷歌发布新一代图像生成模型 Nano Banana Pro,有哪些亮点?》
Imagen 4:https://deepmind.google/models/imagen/
Google Deepmind 2025年5月发布的AI图像生成模型。在LMSYS竞技场T2I子榜上Image 3长期霸榜,Imagen 4生图质量比3高,速度比3快,很可能扩大领先优势。
- OpenAI
GPT-Image 2:Introducing ChatGPT Images 2.0 | OpenAI
OpenAI 2026年4月发布的 GPT 原生图像生成模型。模型基于 GPT-5.4 骨干网络构建,原生集成了“推理模式”(Thinking Mode),在绘图前能进行逻辑构思、实时检索互联网信息并对输出结果进行自我核验,从而在处理诸如“1969年伍德斯托克音乐节”等具备复杂背景知识的指令时展现出极高的世界知识准确度。
在生产力表现上,它彻底攻克了文字幻觉,支持多语种(包括中日韩、印地及孟加拉语)的精准排版与微小 UI 元素的结构化生成,并能输出带透明通道的贴图或 4K 超清的分辨率,比例跨度从 3:1 延伸至 1:3。其突破性的“一致性锚定”技术支持单次连发 8 张角色与风格高度统一的图像,配合无需遮罩的自然语言局部编辑与多图参考合成功能,使该模型在 Image Arena 排行榜上以超过 240 分的断层优势领先。
通过提供 Instant 与 Thinking 双重模式,GPT-Image-2.0 已从艺术创意工具演进为能够直接交付商用海报、交互原型及长篇绘本的专业级视觉生产系统。
DALL·E 3: https://openai.com/dall-e-3
OpenAI研发的AI图像生成器。
Midjourney研究实验室开发的生图模型,可以实现文字生图和图生图。2025年3月发布v7.0。和Stable Diffusion一起出道的生图元老,但是更新太过缓慢,听闻主程已离职,不知是否要退出历史年舞台了。
- Flux 2: FLUX.2 | Black Forest Labs
Black Forest Labs 2025年11月发布的生图模型,建立在潜在流匹配(latent flow matching)架构之上,并将图像生成与编辑功能结合在单一架构中。旗舰模型 FLUX.2 [pro] 在图像生成质量、在指令遵循和视觉保真度方面可以匹配SOTA模型,同时以更快的速度和更低的成本生成图像。自定义模型 FLUX.2 [flex] 支持控制模型参数,例如生成步数(steps)和引导系数(guidance scale),赋予开发者对质量、指令遵循及生成速度的完全控制权。详见《如何评价最新发布的FLUX 2?》。
视频类
- Google DeepMind
Gemini Omni Flash: https://deepmind.google/models/gemini-omni/
Google Deepmind在2026年7月推出的高性价比版本,定位于高质量视频生成与对话式编辑。该模型支持文本、图像和视频的多模态输入,允许用户通过自然语言进行多轮对话式视频精修,并能调用 Gemini 的真实世界知识辅助叙事逻辑,实现文本与视频动作的同步。不过当前版本仍存在若干限制:仅支持 10 秒视频生成,暂不支持音频参考与场景扩展,API 中 3 秒以内的视频参考目前无法被正确处理,且在场景切换或镜头平移时的角色一致性仍有不足。
Google Omni:https://deepmind.google/models/gemini-omni/
Google Deepmind在2026年5月推出的融合 Gemini 推理能力与创造能力的视频生成模型,核心定位在于对世界物理规律的深度理解与实时视频编辑生成。该模型能够基于自然语言提示对输入视频进行高度一致的语义级改造,例如将触摸镜面的画面实时转化为液体波纹、线稿、毛毡玩偶或体素艺术等风格,同时保持人物动作、空间结构和光影关系的物理连贯性,体现出极强的时序一致性与复杂提示遵循能力。
Veo 3.1: https://deepmind.google/technologies/veo/
Google Deepmind在2025年10月发布的AI视频生成模型。相比5月份发布的3.0版本,音频生成、指令遵循、视频真实感这几个维度都有显著增强的同时*,新增“插入”工具,可在视频中添加新元素并自动匹配光影*。**
- Gen-4.5: Runway
Runway在2025年12月发布的AI视频生成模型,保持了 Gen-4 的速度和效率,在不牺牲性能的前提下提供了突破性的质量,但在视频生成时,因果倒置、物体消失、场景成功率过高等局限性依然存在。Gen系列在视频生成模型的队伍中掉队了,本来打算要移除,看它还活着就先留着吧。
- Pika 2.5: https://www.pika.art/
Glen Pika在2025年11月发布的AI视频生成产品,支持文生视频、图生视频和视频生视频。
Luma Labs在2025年9月发布的电影级视频生成产品,增加了CoT推理生成功能,使用专业ACES2065-1 EXR标准生成真正的高动态范围视频,支持10位、12位和16位格式,可以生成时长约10秒。
- Stable Video Diffusion: https://stability.ai/stable-video
Stablility AI发布的AI视频生成模型,以两个图像到视频模型的形式发布,能够以每秒 3 到 30 帧的可定制帧速率生成 14 帧和 25 帧,生成视频时长2-5秒。需下载代码布署本机使用,对电脑硬件配置有一定的要求。
- Midjourney:https://www.midjourney.com/
Midjourney研究实验室开发的视频生成模型,2025年6月发布v1.0。采用图像转视频(I2V)的工作流程,支持用户上传外部图像并进行动画处理。掉队的先驱者。
音乐类
Google Deepmind 2026年2月发布的音乐模型,生成音乐时长30秒,支持文本、图片和视频多种输入方式**。系统会根据提示词自动生成歌词**;用户获得了更强的创作控制权,可以精细调整音乐风格、人声和节奏等元素;模型能够创作出更加真实且音乐复杂度更高的曲目。
- Suno 5.0: https://suno.ai
Suno AI 2025年9月发布的音乐模型。相对于v4.0,完成了音质升级,达到了录音室级别;还能像专业工作站一样,拆解歌曲的鼓点、合成器、人声等 12 个分轨,随意替换、重组;对音乐风格也有更强的掌控力。
音频类
- Stable Audio: https://www.stableaudio.com/
Stablility AI发布的AI音频生成模型。
- MuseNet: https://openai.com/research/musenet
OpenAI研发的AI音频生成模型。
Google Deepmind 2024年6月研发的音频生成大模型,可以根据源视频和文字prompt给源视频配上合适的BGM。详见Generating audio for video——Google V2A简介
世界类
Google DeepMind 于 2025 年 8 月发布的世界模型。该模型能够以 720p 分辨率和 24 帧/秒的速率实时渲染可探索的虚拟环境,模型会根据输入即时生成对应的画面,并将可交互时长从前代的 10 到 20 秒扩展到了数分钟。Genie 3 具备约一分钟的视觉记忆能力,这意味着当用户离开某个场景后再返回时,环境中的物体状态会保持一致。此外,Genie 3 支持可提示的世界事件功能,用户可以在探索过程中通过文本指令实时修改环境。模型并未使用硬编码的物理引擎,而是通过观察大量视频数据自发学会了模拟流体、光影、碰撞等物理规律,能够呈现出水波涟漪、风吹树叶和物体阴影等自然现象。
- World Labs:https://www.worldlabs.ai/
**Marble:**World Labs 于 2025 年 11 月正式推出的首款商用 3D 世界生成模型。用户只需提供单张图片、一段短视频或文字描述,模型即可生成高保真、持久的 3D 虚拟环境;Marble 生成的是可下载、可持久存在的 3D 场景,这显著减少了场景变形和不一致性问题;用户可以先手动构建空间框架,再由 AI 自动补充视觉细节;支持"场景扩展"功能,可在场景边缘自动生成更多环境内容;对于超大规模空间,还可使用"作曲家模式"将多个独立生成的世界拼接在一起。
RTFM:World Labs 于 2025 年 10 月发布的实时生成式世界模型。模型仅需单张 NVIDIA H100 GPU 即可实现实时推理,以交互帧率渲染 4K 画面;采用"空间记忆"技术(Posed Frames as Spatial Memory)和上下文切换机制(context juggling),确保生成的 3D 世界不会因用户离开或视角转换而消失,支持长时间探索后的场景一致性;能够自主学习和渲染反射、阴影、光泽表面、镜头光晕等复杂物理效果。
开源组
通用类
- Mistral
Mistral Large 3:https://docs.mistral.ai/models/mistral-large-3-25-12
法国的大模型公司 MistralAI 于2025年12月份发布并开源的通用模型,采用稀疏 MoE 架构,参数量为 **675B(A41B),支持 256K 上下文。**根据官网介绍,性能位于开源模型梯队前列(官网比较对象为DeepSeek-V3.1和Kimi-K2)。
Ministral 3:https://mistral.ai/news/mistral-3
Mistral AI于2025年12月发布并开源的端侧模型,提供三种参数规模:3B、8B 和 14B。每个变体都有多模态能力,且实现了开源模型中的最佳性价比(官网比较对象为Qwen3和Gemma3)。
Google Deepmind 2026年4月发布的开源小语言模型,架构设计注重计算与内存效率,支持在个人硬件上进行高效部署和微调。该系列提供多个规模版本,从适合边缘设备运行的E2B和E4B,到面向高性能计算的26B和31B参数版本。在智能体能力方面,模型实现了性能突破,原生支持函数调用,使开发者能够构建具备规划、应用导航和任务执行能力的自主智能体。在多模态处理上,模型展现出强大的音频和视觉理解能力,同时在语言支持方面覆盖140种语言,不仅能完成翻译任务,更能深入理解不同文化语境。
- Phi: Introducing Phi-4
微软发布的大语言模型,2024年12月发布了v4.0,截止目前只发布了14B参数的版本,虽然架构和phi-3类似但通过改进的数据质量、优化的训练课程以及创新的后期训练方案**,**展现出相较其参数规模的卓越表现,详见《Phi-4技术报告》。
推理类
OpenAI于2025年8月发布的开源推理模型,MoE架构,有**120B(A5.1B)和20B(A3.6B)**两个版本,性能分别于o4-mini和o3-mini相当。
- Phi
微软2025年5月发布的推理模型Phi-reasoning系列,包括加强版plus,和效率版mini。参数量和通用版本一致为14B。
- Magistral
Mistral发布的推理模型,2025年9月发布了并开源了24B参数的Magistral Small v1.2版本,增加了多模态支持,提升了模型本身和工具使用时的智能。
Meta超级智能实验室2026年4月发布的首款模型,设计小巧快速但擅长科学、数学与健康等复杂推理。其突出特点是强大的多模态感知能力,可识别图像、理解图表,支持通过提示直接生成网站或小游戏。模型能并行启动多个子代理协同处理任务,并深度整合社交内容与购物场景。Muse Spark现已在Meta AI应用中上线,未来将通过API开放并计划开源。小扎实在不行你还是去搞元宇宙吧,同样是没啥成果,毕竟那个亏钱慢一点。
图像类
- Flux 2 [dev] : FLUX.2 | Black Forest Labs
2025年11月由Black Forrest Lab发布,参数量**32B,**衍生自 FLUX.2 基础模型。号称是当今可用的最强大的开放权重图像生成和编辑模型,在单个检查点中结合了文本到图像合成和带有多个输入图像的图像编辑功能。
- Stable Diffusion: https://stability.ai/stable-diffusion/
由CompVis、Stability AI 和 LAION 的研究人员创建文本到图像潜在扩散模型,需下载代码布署本机使用,对电脑硬件配置有一定的要求,目前更新到了3.5版本。
----- 国内部分 -----
国内的大语言模型一开始都是为了想在这个市场中分一杯羹赶鸭子上架陆续上线的,不过在经历了一年多的发展后,和国外领先团队的差距在不断缩小,尤其是在音乐、生图、生视频和推理模型这几个细分领域大有赶超之势。
闭源组
通用类
- 豆包(Doubao):豆包(国内版),https://www.ciciai.com/ (海外版)。
字节跳动研发的大语言模型应用,2026年6月发布Agent模型Doubao-Seed-2.1,包含Pro和Turbo两个版本,定位为面向Coding和Agent时代的基础模型。相比Seed-2.0,模型在三大核心能力上实现全面升级:一是通用Agent能力质变,强化了跨工具、跨环境串联任务的执行水平,可联动多款工具完成一整套闭环任务;二是Coding端到端交付能力显著提升,可在真实企业级开发任务中完成需求理解、功能实现、bug修复、运行环境搭建和结果验证;三是多模态理解能力进一步增强,对复杂视觉信息和视频内容处理更准确。详见《字节跳动Seed 2.1》
Qwen3.6-plus:大模型服务平台百炼控制台——Qwen3.6-plus
阿里千问团队2026年发布的通用模型。在Agent编程能力上实现突破性跃升,尤其在复杂代码仓库级问题求解与前端开发领域树立全新业界标杆,同时默认支持百万token超长上下文窗口。模型深度融合逻辑推理、海量记忆与精准工具执行能力,在代码修复、终端操作、长程规划及工具调用等任务中全面领先,正加速向具备高度自主性的超级智能体演进。多模态感知与推理能力显著增强,在复杂文档理解、视频推理、视觉编程及真实场景感知方面表现更为精准敏锐,为开发者提供稳定可靠的"氛围编程"体验。详见《Qwen3.6-Plus:走向现实世界智能体》
Qwen3.5-Omni:大模型服务平台百炼控制台——Qwen3.5-Omni
阿里千问团队2026年3月发布的All in One模型,采用 Thinker-Talker 双模块架构,且两者均升级为 Hybrid-Attention MoE 结构,提供 Plus、Flash、Light 三种尺寸。模型支持 256K 上下文,可处理超过 10 小时音频或 400 秒 720P 音视频输入,基于超过 1 亿小时的海量音视频数据完成原生端到端预训练。相比 Qwen3-Omni,3.5在多语言能力上显著增强,支持 113 种语种及方言的语音识别和 36 种语言的语音生成。实时交互方面,支持语义打断、自主 WebSearch 与 Function Call、端到端语音控制(音量/语速/情绪调节)及音色克隆功能。针对流式语音合成中的漏读、误读问题,提出 ARIA(自适应速率交错对齐)技术,在保证实时性的同时显著提升语音自然度与稳定性。详见《视听全才,言出码随!全模态Qwen3.5-Omni上线》
相对于只专注于模型性能的DeepSeek,Qwen更贴近应用,更全面。
- 智谱清言(GLM):智谱清言
GLM-5V-Turbo:https://docs.bigmodel.cn/cn/guide/models/vlm/glm-5v-turbo
智谱 AI 公司于2026年4月发布的 Agent 模型,深度适配"龙虾"(OpenClaw/AutoClaw)Agent场景,是智谱首个面向视觉编程的原生多模态Coding基座模型。技术层面采用新一代CogViT视觉编码器与推理友好的MTP架构,上下文窗口 200K token,最大输出128K,具备强大的长程规划与复杂任务执行能力。模型核心特点在于从预训练阶段即深度融合视觉与文本能力,能够直接理解设计稿、截图、网页界面及视频等多模态输入并生成可运行代码。
GLM-5-Turbo:https://docs.bigmodel.cn/cn/guide/models/text/glm-5-turbo。
智谱 AI 公司于2026年3月发布的 Agent 模型,参数量不详,上下文长度200K token。重点强化了工具调用、指令遵循、定时与持续性任务、高吞吐长链路执行四项核心能力。
- 月之暗面(Kimi): https://kimi.moonshot.cn/
月之暗面研发的大语言模型应用。曾经国内的长文档阅读之王,进入2025年后有些沉寂。
- 腾讯元宝(混元):https://yuanbao.tencent.com/
腾讯研发的大语言模型应用,前身为腾讯混元,目前最新语言模型版本为2025年12月发布的HY2.0。HY 2.0 基于 MoE 架构,总参数 406B(A32B),支持 256K 上下文窗口,在推理能力,代码与智能体,指令遵循等维度均实现了显著提升。2025年2月接入DeepSeek-R1后,下载量飚升,但后续的动作存在感都不强。
- 阶跃AI(Step):阶跃AI
阶跃星辰研发的大语言模型应用。
- Ernie-5.1:https://enrie.baidu.com/
百度文心团队2026年5月发布通用模型**,和 Enrie-5.0 一样采用 超稀疏MoE架构,总参数量压缩至前作(约2.4T**)的1/3(约 0.8T),激活参数减半(约 36B),预训练成本仅为业界同规模模型的 6% 左右。该模型采用 Once-for-All 弹性训练框架,通过弹性深度、弹性宽度和弹性稀疏度三个维度动态调控 Transformer 层、MoE 专家池规模及 Top-k 路由机制,在单次预训练中同时优化多规模子模型矩阵。后训练方面,模型构建了以多教师在线策略蒸馏为核心的四阶段管线,依次完成统一SFT、并行领域专家训练、OPD 能力融合与通用在线强化学习,有效避免了传统串行训练中的多目标冲突和跷跷板效应。
- 小米MiMo
MiMo-V2.5-Pro:MiMo-V2.5-Pro | Xiaomi
小米MiMo团队2026年4月发布的Agent模型,是 MiMo团队目前的最强模型,能自主规划和执行复杂长周期任务。它在编程能力大幅提升的基础上,首次展现出像人类专家一样连续工作数小时、通过大量工具调用从零构建编译器或完整桌面软件等完整项目的能力,同时在超长上下文中保持高度连贯和精准的指令遵循,并以更低的 token 消耗实现了前沿级别的效率。
MiMo-V2.5:MiMo-V2.5 | Xiaomi
小米MiMo团队2026年4月发布的通用模型,原生支持长达 1M token 的上下文窗口,其核心特点是显著提升了自主行动能力(Agentic)与多模态(视觉/听觉)的原生融合理解,使其成为一个能同时“看懂、听懂并直接行动”的统一模型。拥有原生多模态理解与行动能力,顶级的自主行动能力,增强的感知与视觉推理能力。
推理类
- 字节豆包
2026年2月发布推理模型Doubao-Seed-2.0 Pro,侧重提升了长链路推理能力与复杂任务稳定性,适配真实业务中的复杂场景,在视觉推理及感知、运动感知、指令遵循和真实世界任务几个维度处于业界第一梯队水平。详见《字节跳动 Seed 2.0》。
- 通义千问
Qwen3.7-Max:大模型服务平台百炼控制台——Qwen3.7-Max
2026年5月发布的推理模型,上下文1M token。该模型以长周期自主执行与跨框架泛化为突出特征,官方实验显示,Qwen3.7-Max 能在陌生的平头哥真武 M890 芯片平台上持续运行数天,完成上千次工具调用与数百次内核评估,自主实现推理内核优化并取得 10 倍几何平均加速。在 YC-Bench 创业公司模拟中,它能自主处理数百轮决策,生成数百万美元虚拟收入。详见《Qwen3.7:智能体新前沿》
- 阶跃AI
2025年4月发布多模态推理模型step-r1-v-mini。
- X1 Turbo
百度文心团队2025年4月发布推理模型**;9月发布了X1.1**,上下文长度64K,其余参数不详**。**
- HY2.0 Think
腾讯混元团队2025年12月发布推理模型,基于 MoE 架构,总参数 406B(A32B)。
- MiMo-V2.5-Pro-UltraSpeed:MiMo-V2.5-Pro-UltraSpeed | Xiaomi
小米MiMo团队2026年6月发布的推理模型,模型基于 MiMo-V2.5-Pro 的万亿参数 MoE 架构,首次在通用 GPU 上实现了单节点 8 卡突破 1000 tokens/s 的解码速度,峰值可达约 1200 tps。
视频类
- Seedance 2.0:Seedance 2.0
字节Seed 2026年2月发布的视频生成模型。新增的“全能参考”能力和增强的编辑能力让视频作品在视听真实感、创作可控性和工业适配性三个维度实现了显著提升,在文生视频、图生视频、多模态视频三个维度都达到行业SOTA水平。在跟随了kling和veo一年多之后,Seedance 2.0成为行业最强。
- 可灵AI
可灵-视频3.0 Omni:可灵 AI - 新一代 AI 创意生产力平台
2025年2月发布的全模态视频生成大模型,升级自可灵视频 O1。新模型基于深度集成的统一模型训练框架,在多模态原生交互上实现了显著进阶。在实现 15 秒长视频生成的突破基础上,提供了更灵活的分镜控制及更精确的语义响应能力。和同时发布的3.0版本相比,Omni模型更侧重多模态元素一致性控制深度融合。
可灵视频 3.0:可灵 AI - 新一代 AI 创意生产力平台
2026年2月发布的视频生成大模型,升级自可灵视频 2.6。相对于同时发布的3.0 Omni,可灵视频3.0更侧重于专业视频生成与叙事控制,提供长达15秒的视频生成能力,强调智能分镜和自定义分镜功能,适合需要精细控制镜头语言和叙事节奏的专业创作场景。
2025年与Google Veo 系列并列行业top 2地位,2026年Seedance有反超之势。
- (MiniMax) Hailuo 2.3:《MiniMax Hailuo 2.3 视频复杂表现新高度 & Media Agent》
MiniMax在2025年10月底推出的视频生成模型**。和6月发布并更名为Hailuo的版本02相比,2.3版本身体动态和面部表情更逼真传神**,对物理世界的理解更深刻,对用户指令的遵循更透彻,并增加了AI视觉特效(VFX)和生成模式选择*。*
- 智谱清影:智谱清言
智谱AI推出的视频生成模型,默认生成视频时长为6秒钟,支持视频风格、情感氛围、运镜方式这些进阶参数。
- (通义万相) Wan 2.7-Video: 通义万相 | 领先的AI视频与图像生成模型
阿里通义万相团队2026年4月发布的视频生成系列模型,包含文生视频(t2v)、图生视频(i2v)、参考生视频(r2v)和视频编辑(videoedit)四大专业模型。该模型支持文本、图像、视频、音频全模态输入,全系列支持720P和1080P分辨率输出,视频时长可在2~15秒内任意指定。用户可通过自然语言指令对视频进行增删元素、替换物体、切换季节与环境风格,以及调整角色行为、台词、表情和拍摄参数。模型支持最多5个主体的多模态参考生成,
- **(ATH)HappyHorse 1.0:**短暂荣登AA榜榜首的视频生成黑马,目前还没官方宣传物料流出,先占坑。
音乐类
- (MiniMax) Music-2.6:《MiniMax Music 2.6:我们想讲四个人的故事》
Minimax在2026年4月底推出的端到端音乐生成模型。其核心升级体现在四个真实场景的应用突破:国风音乐能够呈现二胡揉弦、笛子气口等细腻的演奏呼吸感,实现层次化编排;史诗风格的中低频得到专门优化,贝斯和鼓点具备足够的下潜深度与咬合紧密度;在 lo-fi、独立民谣等风格中,人声和旋律允许适度的"不精准",形成恰到好处的律动呼吸感;新增的 Cover 功能可精准提取上传歌曲的旋律骨架,在保留原曲辨识度的前提下自由切换风格、编曲甚至替换歌词。
此外,2.6 版本将首包延迟压缩至 20 秒以内,显著改善了创作等待体验;指令控制层面强化了对 BPM、调性、段落结构和情绪走向的精确执行能力;中低频的系统性优化也使 House、Trap、Drum & Bass 等依赖低频驱动的风格直接受益。面向开发者,MiniMax 还同步开源了三个 Music Skill。
昆仑万维发布的音乐生成模型,2025年7月发布**V7。**支持MusicCoT,区别于音乐生成模型常见的next token prediction生成方式,Mureka V7先搭音乐框架,再填充内容。在Song Quality Evaluation中的考分高过Suno v4.5。
音频类
- StepAudio 2.5 TTS:https://platform.stepfun.com/docs/zh/guides/models/stepaudio-2.5-tts
阶跃AI在2026年4月发布的 Contextual TTS模型,其核心特点在于通过理解语境,让AI“演”文本,而非简单“念”文本。模型实现了双档语境控制,通过全局语境定调整段基调,再用文中语境在句子中精调,实现复杂情绪的细腻演绎;零样本音色复刻,只需3秒参考音频即可复刻音色,且复刻后的声音依然支持灵活的语境控制,不受固定音库限制;**高品质声音表达,**在韵律、节奏等维度全面提升,有效改善“AI味”,人声品质更接近真人。
- (MiniMax) Speech-2.6:https://www.minimax.io/news/minimax-speech-26
Minimax在2025年10月底升级的文转语音模型。相比8月发布的Speech 2.5,Speech 2.6的延时更低,端到端延迟降至250ms以下;支持特殊格式文本解析,URL、EMail、电话号码、日期不需要预处理也能正常表述;引入“Fluent LoRA”技术,解决不完美音源声音克隆的需求难点。
通义团队在2025年9月发布的文本转语音模型,拥有领先的中文和英文稳定性,17种表现力丰富的声音 × 10 种语言,在中文、英文、意大利语、法语方面达到 SOTA水平,其中中文支持超过9种方言。
图像类
- 可灵 AI
可灵图片3.0 Omni:Next-Gen AI Video & AI Image Generator
可灵AI 2026年2月发布的图像生成模型。升级自可灵图片O1。新模型致力于强化电影级叙事视觉表达,通过对文生图与图生图生成能力的深度优化,使其精准适配影视类图像创作需求。3.0 Omni模型的四大核心优势包括结构化叙事表达强化、图像系列模式与批量优化功能、原生 2K/4K 超高清输出、提真实感与细节一致性提升。
可灵图片3.0:Next-Gen AI Video & AI Image Generator
可灵AI 2026年2月发布的图像生成模型,升级自可灵图片2.6。模型支持 10 张参考图像的特征融合与再创作,可一站式满足各类图像创作需求。其核心优势体现在特征保留、精确细节微调、风格受控准确、想象力卓越。
- (字节Seed)Seedream 5.0 Pro:Seedream 5.0 Pro
字节Seed团队2026年7月发布的多模态图像创作模型,其定位已从单纯的"画面生成"升级为"理解设计"——核心突破在于将创作者意图与视觉呈现之间的距离大幅缩短,使模型能够高效满足复杂、专业的真实生产需求。
相较于前代版本,该模型在图文匹配精度、结构合理性、文字渲染质量与画面美感等基础能力上均有全面提升,并围绕四大方向实现了关键突破。模型能够深度解析用户意图,自主完成逻辑推理与版面规划,将数据、概念与密集文字准确转化为专业排版,稳定输出高信息密度的内容图;模型基于对空间位置与区域语义的理解,支持点选、圈选、草图渲染、色彩与材质替换、图层分离、多图融合等自由组合操作,实现像素级编辑控制;模型在光影还原、材质表现与皮肤肌理等维度显著进步,兼顾CG表现与摄影质感,使画面更具生命力;模型还支持十余种世界常用语言的直接输入与高质量渲染,能够准确传递本地化特征。
- (通义万相) Wan 2.7-生图:万相 | 领先的AI视频与图像生成模型
阿里通义万相团队2026年3月发布的图像生成模型。强化了虚拟形象捏脸功能,支持从骨相、眼眸到五官细微处的全方位定制;支持全新的“调色盘”功能,用户一键提取或输入参考图的各种颜色和占比,并可自由调控颜色的数量和占比,自定义配色方案;对超长文字、表格和复杂公式的渲染可达印刷级,支持 12 种语言,最高 3K token 的超长文字输入。
世界类
- (ATH)Happy Oyster:Happy Oyster
阿里巴巴token事业部2026年4月发布的世界模型,目前内测资格少量放出中,先占坑。
开源组
通用类
- DeepSeek
DeepSeek-V4-Pro: DeepSeek-V4-Pro
深度求索团队2026年4月发布的旗舰混合推理模型,总参数 1.6T,每 token 激活 49B,上下文窗口 1M token,预训练使用超过 32T token 多样化高质量语料。采用混合注意力架构,引入压缩稀疏注意力(CSA)与重度压缩注意力(HCA),极大减少单 token 推理计算量和KV 缓存。采用了**流形约束超连接(mHC)**增强传统残差连接,提高信号跨层传播稳定性。Agent 能力也得到了大幅增强。整体性能位于开源模型SOTA,略逊于闭源模型SOTA。
DeepSeek-V4-Lite:DeepSeek-V4-Flash
深度求索团队2026年4月发布的混合推理模型,总参数约 284B,每token 激活 13B,上下文窗口 1M token。DeepSeek-V4-Flash 在世界知识储备方面稍逊 V4-Pro一筹,但展现出了接近的推理能力。而由于模型参数和激活更小,相较之下 V4-Flash 能够提供更加快捷、经济的 API 服务。在 Agent 测评中,V4-Flash 在简单任务上与 DeepSeek-V4-Pro 旗鼓相当,但在高难度任务上仍有差距。
- Qwen
Qwen3.6-27B:https://huggingface.co/Qwen/Qwen3.6-27B
通义千问团队 2026年4月发布并开源的稠密多模态通用模型,参数为**27B。**模型在智能体编程方面达到旗舰级表现,在多项核心编程基准上全面超越了总参数量高达其15倍的前代旗舰模型。该模型原生支持图像、视频与文本处理,具备多模态思考与非思考双模式,同时在自然语言推理任务上展现出媲美数倍体量模型的实力。详见《Qwen3.6-27B开源:小小身材,超级码力》。
Qwen3.6-Flash:https://huggingface.co/Qwen/Qwen3.6-35B-A3B
通义千问团队 2026年4月发布并开源的通用模型,参数为35B-A3B,基础上下文窗口256K,可扩展至1M。原生支持多模态,以 3B 激活参数展现出远超其体量的感知与多模态推理能力;在智能体编程任务上表现突出,仅凭3B 激活参数就超越了27B 参数的稠密模型Qwen3.5-27B,并在智能体编程和推理任务上大幅超越其前代Qwen3.5-35B-A3B;详见《智能体编程“小钢炮”:Qwen3.6-35B-A3B开源!》
Qwen3.5:https://github.com/QwenLM/Qwen3.5
通义千问团队 2026年2月发布通用模型,参数为397B-A17B。模型通过在数 T 多模态 token 上进行早期融合训练,在推理、编程、智能体及视觉理解基准等维度全面超越 Qwen3 和 Qwen3-VL;采用门控 Delta 网络与稀疏 MoE 相结合的方案,在极低的延迟与成本开销下实现了高吞吐量的推理性能;支持的语言与方言种类已扩展至 201 种。详见《Qwen3.5:迈向原生多模态智能体》。
Qwen3-VL:https://github.com/QwenLM/Qwen3-VL
2025年9月发布多模态通用模型,参数量为235B-A22B,拥有视觉智能体操作图形界面、视觉编程、精确空间理解、超长上下文,超长视频理解等能力,详见《Qwen3-VL 技术报告》
Qwen3-Omni:https://github.com/QwenLM/Qwen3-Omni
2025年9月发布All in one模型Qwen3-Omni,参数量为30B-A3B,这是一个原生端到端全模态 AI,统一整合文本、图像、音频和视频于单一模型——无模态权衡。详见《原生全模态!Qwen3-Omni视频通话来咯》
Qwen3-Next:Qwen3-Next
9月发布全新架构的Qwen3-Next,参数量为80B-A3B,核心改进包括混合注意力机制、高稀疏度 MoE 结构、一系列训练稳定友好的优化,以及提升推理效率的MTP机制。其它的训练成本仅为Qwen3-32B的十分之一不到,在32k以上的上下文下的推理吞吐则是Qwen3-32B的**十倍以上。**详见《Qwen3-Next:迈向更极致的训练推理性价比》
- GLM
GLM-5.2:https://huggingface.co/zai-org/GLM-5.2
智谱团队2026年6月发布并开源的混合推理模型*,*参数量为754B(A40B),上下文窗口1M,最大输出长度为 128K 。相较 GLM-5.1,GLM-5.2 针对长程 Coding Agent 场景进行了数月强化训练,在执行长程任务时更稳定、工程规范遵循更可靠,开发场景成功率更高。它能持续保留模块边界、架构约束、接口约定和历史决策,长任务后半程的上下文断层感明显降低;在跨文件、多步骤、长链路任务中表现更稳,会先拆解目标、识别依赖和风险,再分阶段实现、验证和收口;对代码风格、架构边界、依赖约束、构建流程和测试要求的保持度更高,能降低越界修改、无效依赖和跳过验证等风险。
GLM-4.6V:https://huggingface.co/zai-org/GLM-4.6V
智谱团队于2025年12月初发布并开源的多模态MoE混合推理模型,总参数和4.5V一致为106B(A12B),同时增加了一个 9B 的端侧模型 GLM-4.6V-Flash。模型上下文窗口扩展至 128K token,让模型可以胜任长上下文理解的任务。首次集成了原生的函数调用功能,让模型同时拥有多模态输入和多模态输出(交错图文、统计图表、图片渲染)的能力,能满足富文本内容理解创作、视觉网络搜索、前端开发和交互的应用场景需求。
- Kimi
Kimi-K2.6:https://huggingface.co/moonshotai/Kimi-K2.6
月之暗面团队2026年4月发布通用模型,参数量为 1T(A32B),上下文窗口256K,是目前业界总参数量最大的开源模型。相对于K2.5,其通用 Agent 能力、代码生成与视觉理解等综合能力得到全面提升。该模型支持文本、图片与视频的多模态输入,提供思考(thinking)与非思考两种模式,适用于对话与 Agent 任务场景。API 层面新增了 thinking 参数用于控制思考模式的启用与禁用,并支持基于 base64 编码的图片和视频上传,同时兼容多模态工具调用,允许模型在 Agent 循环中返回视频片段等富媒体内容作为工具执行结果。技术报告详见《Kimi K2.5:视觉增强的智能体能力》。
- MiniMax
Minimax M3:https://huggingface.co/MiniMaxAI/MiniMax-M3
MiniMax 2026年6月发布的Agent模型,参数量为 428B(A23B),支持高达1M(超过512K的长文本输入暂列为限量供应) token的上下文窗口,并原生支持文本、图像与视频多模态输入,输出为文本,最大单次输出可达128K token,同时具备编程、智能体协作与Computer Use能力,官方称其为**国内首个同时集成这三项能力且开源开放的模型。**该模型采用 **MiniMax Sparse Attention(MSA)**架构,以标准 GQA 为骨干,通过块级筛选在真实未压缩的 Key-Value 上执行稀疏注意力计算。
相比今年3月发布的M2.7,架构上从全注意力全面转向MSA稀疏注意力,在百万token长度下实现了约9.7倍的预填充速度提升与15.6倍的解码速度提升,长上下文推理成本降至前代的大约 1/20;模态能力也从纯文本扩展为原生多模态,新增图像与视频理解输入;上下文窗口从 205K 大幅扩展至1M token;应用场景从M2.7强调的自主代码演进与办公套件编辑,进一步延伸到长时程智能体任务、Computer Use与复杂工具调用,更侧重可持续多步骤协作而非单轮执行。
- Enrie
Enrie 4.5:https://github.com/PaddlePaddle/ERNIE
2025年7月,文心4.5系列开源模型共10款,涵盖了激活参数规模分别为47B和3B的MoE模型(最大的模型总参数量为424B),以及0.3B的稠密参数模型。
- MiMo
MiMo-V2-Flash:https://github.com/XiaomiMiMo/MiMo-V2-Flash/
小米MiMo团队2025年12月发布并开源的通用模型,MoE架构,参数量为 309B(A15B) 。模型采用了混合注意力架构,将滑动窗口注意力与全局注意力交替使用。在 27T token 上进行了**多 token 预测(MTP)预训练,引入多教师在线策略蒸馏(MOPD)**范式进行后训练,性能接近 Kimi-K2-Thinking 和 DeepSeek-V3.2。详见《小米 MiMo-V2-Flash 技术报告》。
- Hunyuan
Hy3:https://huggingface.co/tencent/Hy3
腾讯混元团队2026年7月在 Hy3-preview 基础上迭代推出的正式版本,参数 299B(A21B)、上下文窗口**256K。**技术架构上采用 192 路专家与 top-8 路由机制,并配备 3.8B 参数的 MTP 层。
相较于 Hy3-preview,正式版主要改进了数据质量与训练规模,用更高质量的数据扩展后训练,并加大了 RL 训练力度。Hy3在Agent 能力上显著增强,在代码、办公、金融建模、前端设计和游戏开发等生产力场景中表现可靠;产品体验更加稳定,工具调用和输出格式达到生产级标准,幻觉率大幅降低,复杂上下文保留与多轮意图跟踪能力明显提升;Token 效率突出,文档处理和演示文稿创建相比 GLM-5.2 分别节省 47.4% 和 49% 的 token 消耗。
- Step
Step3-VL:Compact Yet Frontier Multimodal Intelligence
阶跃AI 2026年1月发布的多模态通用模型,参数量 10B。模型在视觉感知、复杂推理和人类对齐方面表现卓越,官方介绍该模型为 10B 规模以下的SOTA模型,并能媲美甚至超越规模大 的开源模型(如 GLM-4.6V 106B-A12B、Qwen3-VL-Thinking 235B-A22B)以及顶级闭源旗舰模型(如 Gemini 2.5 Pro、Seed-1.5-VL)。阶跃团队表示,模型的成功归因于高质量多模态语料库的统一预训练(1.2T tokens)与规模化多模态强化学习(超过 1,400 次 RL 迭代),并引入**Parallel Coordinated Reasoning (PaCoRe)**实现并行视觉探索的证据聚合。
推理类
- DeepSeek
DeepSeek-V4-Pro-Thinking:DeepSeek-V4-Pro
深度求索团队2026年4月发布的旗舰混合推理模型,总参数 1.6T,每 token 激活 49B,上下文窗口 1M token。支持“Think High/Think Max”两档思考模式,通过 reasoning_effort 控制思考强度。
DeepSeek-V4-Flash-Thinking:DeepSeek-V4-Flash
深度求索团队2026年4月发布的混合推理模型,总参数约 284B,每token 激活 **13B,**上下文窗口 **1M token。**支持“Think High/Think Max”两档思考模式,通过 reasoning_effort 控制思考强度。
DeepSeek-R1:https://github.com/deepseek-ai/DeepSeek-R1
深度求索2025年1月发布了R1正式版,5月28日做了一次小更新,LMSYS总榜前10名的常客。详见《DeepSeek-R1技术报告(全文)》。
- Qwen
Qwen3.5-Thinking:https://github.com/QwenLM/Qwen3.5
通义千问团队2026年2月发布的推理模型,详见《Qwen3.5:迈向原生多模态智能体》。
Qwen3-Next-80B-A3B-Thinking:Qwen3-Next
通义千问团队2025年9月发布的推理模型,详见《Qwen3-Next:迈向更极致的训练推理性价比》。
Qwen3-VL-Thinking:https://github.com/QwenLM/Qwen3-VL
通义千问团队2025年9月发布的多模态推理模型,详见《千问家族最强视觉模型!Qwen3-VL来了》。
- GLM
GLM-4.7(Thinking Mode):https://huggingface.co/zai-org/GLM-4.7
智谱AI 2025年12月发布并开源的混合推理模型,显著提升了数学和推理能力,在 HLE(“人类最后的考试”)基准测试中获得 42.8% 的成绩,较 GLM-4.6 提升 41%,超过 GPT-5.1。
GLM-4.5V(Thinking Mode):https://huggingface.co/zai-org/GLM-4.5V
智谱AI 2025年8月初发布并开源的多模态混合推理模型**,参数106B(A12B)。**
- Seed
Seed-OSS:https://github.com/ByteDance-Seed/seed-oss
字节Seed 2025年8月发布并开源的推理模型,参数量36B,长达512K的上下文窗口。针对推理任务进行优化的同时保持均衡且优秀的通用能力,允许用户根据需要灵活调整推理长度,并且在智能体任务(如工具使用和问题解决)方面表现卓越。
- Hunyuan
Hunyuan-A13B-Thinking:https://github.com/Tencent-Hunyuan/Hunyuan-A13B
腾讯混元团队2025年6月推出的混合推理模型,总参数量80B,激活数量13B,拥有快/慢思考模式,集成了深度研究智能体。
- Kimi
Kimi-K2.6-Thinking:https://huggingface.co/moonshotai/Kimi-K2.6
月之暗面团队2026年1月推出的推理模型,参数量 1T(A32B),上下文窗口 256K 。详见通用模型介绍。
Kimi-VL-Thinking:https://github.com/MoonshotAI/Kimi-VL
月之暗面团队2025年3月推出多模态推理模型,MoE架构,参数量16B(激活3B),详见《Kimi-VL技术报告(全文)》。
- Step
Step-3.7-flash:https://huggingface.co/collections/stepfun-ai/step-37-flash
阶跃 AI 2026年5月发布的推理模型,MoE架构,参数量196B(A11B),上下文长度为 256K。最高生成速度可达每秒400个Token,同时提供低、中、高三档推理层级供开发者按需选择。3.7 Flash专门为生产级Agent工作流重新设计,具备原生多模态理解与执行能力,可直接处理UI界面、图表、文档、图片及各类应用界面,将复杂视觉信息转化为结构化结果和可执行任务;同时强化了联网检索与视觉搜索能力,能够在开放信息环境中跨文本与图像主动获取并交叉比对多源证据。在工具调用方面,模型针对长程多轮Agent工作流进行了稳定性优化,还针对Claude Code、KiloCode、RooCode、OpenClaw等主流Agent框架以及MCP、Skills等工具调用协议进行了兼容优化。
Step 3:https://huggingface.co/stepfun-ai/step3
阶跃 AI 2025年7月发布多模态推理模型,MoE架构,参数量 321B(A38B)。拥有强大的视觉感知和复杂推理能力,可准确完成跨领域的复杂知识理解、数学与视觉信息的交叉分析,以及日常生活中的各类视觉分析问题。
- MiniMax
MiniMax-M2.1(Interleaved Thinking):https://huggingface.co/MiniMaxAI/MiniMax-M2.1
MiniMax团队在2025年12月发布并开源的混合推理模型,参数量为230B(A10B)。和 M2 相比,新版模型编程语言能力、WebDev 与 AppDev、复合指令约束、Agent / 工具泛化能力显著加强,回复更简洁高效,对话和写作质量更高。
视频类
Hunyuan Video 1.5:https://github.com/Tencent-Hunyuan/HunyuanVideo-1.5
腾讯混元团队2025年11月发布的开源视频生成模型,参数量 8.3B,小于1.0版本时的 13B。采用的是 DiT 与 3D 因果 VAE 相结合的先进架构和多阶段、渐进式的训练策略,从整体上优化了运动连贯性、美学质量和对人类偏好的对齐,实现了专业级的内容生成。详见《Hunyuan Video 1.5 技术报告》。
Wan 2.2: https://github.com/Wan-Video/Wan2.2
阿里通义团队发布的开源视频生成模型,最新版是2025年7月发布的v2.2,这是一个基于先进Wan2.2-VAE构建的5B和14B参数模型。该模型支持720P分辨率、24fps的文本到视频和图像到视频生成,同时可在4090等消费级显卡上运行。这是目前可用的最快720P@24fps模型之一,能够同时满足工业界和学术界的需求。
图像类
- Qwen
Z-Image:https://github.com/Tongyi-MAI/Z-Image
阿里通义团队2025年11月发布并开源的可扩展单流 DiT(S3-DiT)生图模型,6B参数,包含Turbo(蒸馏版本,适配16G消费级显存),Base(基准模型),**Edit(基于基准模型专门针对图像编辑任务微调)**三个变体。在阿里自己的Arena上测试,已达到开源界SOTA水准。
Qwen-Image:https://github.com/QwenLM/Qwen-Image
阿里通义团队2025年8月发布并开源的MMDiT图像基础模型,20B参数,在复杂文本渲染和精确图像编辑领域实现了重大突破,对中文文本的处理尤为出色。9月升级了多图编辑功能。
- Hunyuan Image:https://github.com/Tencent-Hunyuan/HunyuanImage-3.0
腾讯混元团队2025年9月发布的文本到图像生成模型 3.0 版本。这是开源界规模最大的生图MoE模型,包含 64 个专家,总参数量高达 80B,每 token 激活参数量为 13B。它突破了目前主流的基于DiT 的架构限制,采用了一种统一的自回归框架,这一设计实现了对文本和图像模态更直接、更一体化的建模;它还利用混元团队世界模型里丰富的世界知识,智能解读用户意图,能够自动为简短稀疏的提示词补充语境合理的细节。
- GLM
GLM-Image:https://github.com/zai-org/GLM-Image
智谱AI团队2026年1月发布并开源的工业级离散自回归图像生成模型。其采用自回归模块与扩散解码器的混合架构,融合了 9B 参数的 GLM-4 与 7B 参数的单流 DiT。模型在文本渲染、知识密集型任务及复杂语义理解方面优势显著,支持文生图及多种图像编辑任务。通过 semantic-VQ 建模低频语义并由 diffusion 模块还原细节,结合解耦的强化学习策略,实现了艺术美学与精准信息表达的高度对齐。
CogView:https://github.com/zai-org/CogView4/
智谱AI团队发布并开源的DiT生图模型,2025年3月发布v4,参数量6B。模型具有较强的复杂语义对齐和指令跟随能力,支持任意长度的中英双语输入,能够生成在给定范围内的任意分辨率图像,同时具备较强的文字生成能力。
音频类
- HunyuanVideo-Foley:https://github.com/Tencent-Hunyuan/HunyuanVideo-Foley
腾讯混元团队2025年8月发布并开源的音频生成模型,参数 3B ,是开源模型中参数最多、性能最强的视频音效生成模型。Foley采用包含双流MMDiT与单流音频DiT的多模态音频生成架构,在DAC的基础上设计了改进的DAC-VAE,在10万小时高质量多模态数据集上完成了训练,能理解视频画面并结合文字描述,自动平衡不同信息源生成层次丰富的复合音效。
音乐类
- ACE-Step(音跃):https://github.com/ace-step/ACE-Step
阶跃星辰与数字音乐平台 ACE Studio ,2025年5月联合发布的开源音乐大模型,参数量为3.5B,详见《开源音乐大模型 ACE-Step 上线》
世界类
- HY-World 2.0:https://github.com/Tencent-Hunyuan/HY-World-2.0/
腾迅混元团队2026年4月发布的面向世界生成和世界重建的多模态世界模型。它接受多种输入模态——文本、单视图图像、多视图图像和视频——并生成3D世界表示(网格 / 3D高斯点云)。世界生成能力(文生世界和图生世界)通过四阶段方法合成高保真、可导航的3D场景,世界重建(多视图图像生世界和视频生世界)由 WorldMirror 2.0 驱动,这是一个统一的前馈模型,能够在单次前向传播中同时预测深度、表面法线、相机参数、3D点云和3DGS属性。
更新日志
2026
6月更新
- **Claude:**国外闭源组更新 Agent 模型 **Claude Sonnet 5,**新增 Agent 模型 Claude Fable 5 / Mythos 5;
- **GPT:**国外闭源组更新 Agent 模型 GPT-5.6;
- **豆包:**国内闭源组更新 Agent 模型 Seed-Doubao-2.1;
- **GLM:**国内开源组更新Agent 模型 GLM-5.2;
- **MiMo:**国内开源组新增推理模型 MiMo-V2.5-Pro-UltraSpeed。
- **Step:**国内开源组更新推理模型 Step-3.7-Flash;
- **MiniMax:**国内开源组更新 Agent 模型 MiniMax M3。
5月更新
- **Claude:**国外闭源组更新Agent模型 **Claude Opus 4.8,**推理模型 Claude Opus 4.8 Thinking;
- **Qwen:**国内闭源组更新Agent模型 Qwen3.7-Max;
- **Google Deepmind:**国外闭源组更新通用模型 Gemini-3.5-Flash;新增生视频模型 Gemini Omni;
- **Enrie:**国内闭源组更新通用模型 Enrie-5.1;
- **Grok:**国外闭源组更新 Agent 模型 Grok-4.3;
- **GPT:**国外闭源组新增通用模型 GPT-5.5 Instant。
4月更新
- **DeepSeek:**国内开源组新增通用模型 DeepSeek-V4-Pro、**DeepSeek-V4-Flash,**推理模型 DeepSeek-V4-Pro-Thinking、DeepSeek-V4-Flash-Thinking;以及 DeepSeek-V4技术报告
- **OpenAI:**国外闭源组更新通用模型 **GPT-5.5,**推理模型 GPT-5.5 Thinking 和 **GPT-5.5 Pro,**图像模型 GPT-Image 2;
- **Hunyuan:**国内开源组更新通用模型 Hy3-Preview ;
- **MiMo:**国内闭源组更新 Agent 模型 **MiMo-2.5-Pro,**通用模型 MiMo-2.5;
- **Step:**国内闭源组新增音频模型 StepAudio 2.5 TTS;
- **Kimi:**国内开源组更新通用模型 Kimi-K2.6,推理模型 Kimi-K2.6 thinking;
- **Qwen:**国内开源组新增通用模型 **Qwen3.6-27B,**更新通用模型 **Qwen3.6-Flash,**国内闭源组更新通用模型 **Qwen3.6-Max-Preview,**All in One 模型 Qwen3.5-Omni,通用模型 Qwen3.6-plus;
- **Claude:**国外闭源组更新通用模型 Claude Opus 4.7;推理模型 Claude Opus 4.7 Adaptive Thinking;
- **(ATH)Happy Oyster:**国内闭源组新增世界模型 Happy Oyster 1.0;
- 新增世界模型分类**,**增加国外闭源世界模型 **(DeepMind)Genie 3,(World Labs)Marble、 RTFM,**国内开源世界模型 (Hunyuan)HY-World 2.0;
- MiniMax:国内闭源组更新音乐模型 Music 2.6,MiniMax M2.7从国内闭源组移到国内开源组;
- **(MetaAI)Muse Spark:**国外开源组新增推理模型 Muse Spark;
- **(ATH)Happy Horse:**国内闭源组新增视频模型 HappyHorse 1.0;
- **GLM:**国内闭源组新增Agent模型 GLM-5V-Turbo;
- **Wan:**国内闭源组更新生图模型 Wan2.7-Image,Wan2.7-Video;
- **Google Deepmind:**国外闭源组更新通用模型 **Gemini 3.1 Flash,**国外开源组更新通用模型 Gemma 4;
3月更新
- **GLM:**国内开源组新增通用模型 GLM-5.1;
- **MiMo:**国内闭源组新增Agent模型 MiMo-V2-Pro;
- **GLM:**国内闭源组新增Agent模型 GLM-5-Turbo;
- **MiniMax:**国内闭源组更新Agent模型 MiniMax 2.7。
- ChatGPT: 国外闭源组更新通用模型 GPT-5.4,推理模型 GPT-5.4-Thinking。
2月更新
- **Gemini:**国外闭源组更新更新生图模型 **Gemini 3.1 Flash Image(Nano Banana 2),**推理模型 Gemini 3.1 Pro;
- **Claude:**国外闭源组更新通用模型 Claude Sonnet 4.6;
- **Lyrics:**国外闭源组新增音乐模型 Lyrics 3;
- **Qwen:**国内开源组更新通用模型 Qwen 3.5,推理模型 Qwen 3.5-Thinking。
- **字节豆包:**国内闭源组更新通用模型 Doubao-Seed-2.0 Lite/Mini,推理模型 Doubao-Seed-2.0 Pro;
- **MiniMax:**国内开源组更新通用模型 **MiniMax M2.5;**国内闭源组更新音乐模型 Music-2.5;
- **GLM:**国内开源组更新通用模型 GLM-5;
- **Seedance:**国内闭源组更新生视频模型 Seedance 2.0;
- **Claude:**国外闭源组更新通用模型 **Opus 4.6,**推理模型 Opus 4.6 Adaptive Thinking;
- **可灵AI:**国内闭源组更新生视频模型 可灵视频 3.0 和 **3.0 Omni,**生图视频 可灵图像 3.0 和 3.0 Omni;
- **Step:**国内开源组新增推理模型 Step-3.5-Flash。
1月更新
- **Kimi:**国内开源组更新通用模型 Kimi-K2.5 ,推理模型 Kimi-K2.5-Thinking 以及模型技术报告;
- **Qwen:**国内闭源组更新推理模型 Qwen-Max-Thinking;
- **Enrie:**国内闭源组更新通用模型 Enrie-5.0 正式版;
- **Step:**国内开源组新增通用模型 Step3-VL;
- **GLM:**国内开源组新增生图模型 GLM-Image。
2025
12月更新
- **GLM:**国内开源组更新通用模型 GLM-4.7、GLM-4.6V,推理模型 GLM-4.7(Thinking Mode);
- **MiniMax:**国内开源组更新通用模型 **MiniMax M2.1,**推理模型 MiniMax M2.1(Interleaved Thinking);
- **Seedance:**国内闭源组更新通用模型 doubao-Seed-1.8,推理模型 doubao-Seed-1.8 thinking,生视频模型 Seedance 1.5 pro;
- MiMO:国内开源组新增通用模型 MiMo-V2-Flash及模型技术报告;
- **Gemini:**国外闭源组更新通用模型 Gemini 3 Flash;
- **ChatGPT:**国外闭源组更新生图模型 GPT-Image-1.5;
- **Wan:**国内闭源组更新生视频模型 **Wan 2.6-视频,**生图模型 Wan 2.6-图像。
- OpenAI:国外闭源组更新通用模型GPT-5.2 Instant、推理模型GPT-5.2 Thinking,新增推理模型GPT-5.2 Pro;
- **腾讯混元:**国内闭源组更新通用模型 HY 2.0,新增推理模型 HY 2.0 Think;
- 可灵AI:国内闭源组新增生视频模型 可灵-视频O(mni)1、可灵视频 2.6,生图模型 可灵-图像O1;
- **字节豆包:**国内闭源组更新生图模型 Seedream 4.5;
- **Runway:**国外闭源组更新生视频模型 Gen-4.5;
- **Mistral:**国外开源组新增通用模型 Mistral Large 3,Ministral 3;
- **DeepSeek:**国内开源组更新通用模型 **DeepSeek-V3.2,**推理模型 DeepSeek-V3.2-Thinking,DeepSeek-V3.2-Speciale 以及模型技术报告。
11月更新
- **Qwen:国内开源组新增生图模型Z-image;**国内闭源组更新推理模型 Qwen3-Max-Thinking-Preview。
- Flux:国外闭源组新增生图模型 Flux 2[pro] 和 Flux 2[flex],开源组新增生图模型Flux 2[dev];
- Claude:国外闭源组更新通用模型Claude Opus 4.5,推理模型Claude Opus 4.5 Extended Thinking。
- **Hunyuan:**国内开源组更新视频模型 Hunyuan Video 1.5 及技术报告,音频模型 HunyuanVideo-Foley;
- **Gemini:**国外闭源组更新推理模型 Gemini 3 Pro 和 **Gemini 3 DeepThink ;**新增图像模型 Gemini 3 Pro Image(Nanano Banana Pro);
- Grok: 国外闭源组更新通用模型 **Grok 4.1,**推理模型 Grok 4.1 Thinking;
- **OpenAI:**国外闭源组更新通用模型 GPT-5.1,推理模型 GPT-5.1-Thinking;
- **百度文心:**国内闭源组更新 Ernie-5.0-preview;
- **Kimi:**国内开源组更新推理模型 Kimi-K2-Thinking;
10月更新
- **MiniMax:**国内开源组更新推理模型 MiniMax-M2;国内闭源组更新生视频模型 Hailuo 2.3,音乐模型 Music 2,语音模型 Speech 2.6。
- Google Deepmind:国外闭源组更新视频类模型Veo 3.1;
- Anthropic:国外闭源组更新通用类模型Claude Haiku 4.5。
9月更新
- GLM:国内开源组更新通用模型GLM-4.6;
- DeepSeek:国内开源组更新通用模型DeepSeek-V3.2-Exp,推理模型DeepSeek-V3.2-Exp-Thinking;
- Claude:国外闭源组更新通用模型Claude Sonnet 4.5;推理模型Claude Sonnet 4.5 Extended Thinking;
- OpenAI:国外闭源组更新视频类模型Sora 2;
- Suno:国内闭源组更新音乐类模型Suno v5;可灵AI:国内闭源组视频类更新可灵2.5 Turbo;
- Qwen:国内闭源组通用类填坑Qwen3-Max,推理类新增Qwen3-Max-Thinking,音频类新增Qwen3-TTS;国内开源组通用类新增Qwen3-Omni、Qwen3-VL、Qwen3-Next,推理类新增Qwen3-VL-Thinking、Qwen3-Next-Thinking;
- DeepSeek:国内开源组通用类更新DeepSeek-V3.1-Terminus;推理类更新DeepSeek-V3.1-Terminus-Thinking;
- Luma AI:国外闭源组视频类更新Ray 3;
- Mistral:国外闭源组推理类更新Magistral Small 1.2,国外闭源组推理类更新Magistral Medium 1.2。
- MiniMax:国内闭源组音乐类更新Music-1.5;
- 文心一言:国内闭源组推理类更新X1.1;
- Hunyuan Image:国内开源组图片类新增v2.1;
8月更新
- Gemini:国外闭源组新增生图模型Gemini 2.5 Flash Image;
- 字节Seed:国内开源组更新推理模型Seed-OSS;
- DeepSeek:国内开源组更新混合推理模型DeepSeek-V3.1;
- GLM:国内开源组更新多模态混合推理模型GLM-4.5V;
- OpenAI:国内闭源组更新通用模型GPT-5,推理模型GPT-5 Thinking;国外开源组更新推理模型gpt-oss;
- Claude:国外闭源组更新通用模型Opus 4.1;
- Qwen:国内开源组新增生图模型Qwen-Image;
- MiniMax:国内闭源组更新音频模型Speech 2.5。
7月更新
- Mureka:国内闭源组新增音乐模型Mureka V7;
- Step:国内开源组新增推理模型Step 3;
- Wan:国内开源组更新视频生成模型Wan2.2;
- Kimi:新增K2技术报告;
- GLM:国内开源组更新通用模型GLM-4.5,更新推理模型GLM-4.5-X;
- Qwen:国内开源组新增推理模型Qwen3-235B-A22B-Thinking。
- Kimi:国内开源组通用模型更新K2。
- Grok:推理模型更新Grok 4;
- GLM:国内开源组推模模型新增GLM-4.1V-Thinking;
- Black Forest Labs:更新开源生图模型Flux.1 Kontext;
- 百度文心:国内开源组新增Enrie 4.5系列。
6月更新
- MidJourney:新增生视频模型V1;
- Hunyuan:国内开源组新增混合推理模型Hunyuan-A13B。
- MiniMax:国内开源组新增推理模型MiniMax-M1,闭源组更新生视频模型Hailuo-02。
- **Google Gemini:**新增Gemini2.5技术报告链接
- Mistral:新增推理模型Magistral Small(开源组),Medium(闭源组);
- 字节豆包:更新通用模型Doubao-Seed-1.6,推理模型Doubao-Seed-1.6-Thinking,生视频模型doubao-seedance 1.0。生图模型doubao-seedream 3.0。
- OpenAI:更新推理模型o3 pro。
5月更新
- **可灵:**更新至2.1版本;
- **可图:**更新至2.1版本;
- Google Imagen:更新至v4.0;
- Google Veo:更新至v3.0;
- Google Gemini:新增Gemini Diffusion,Gemini 2.5 Pro Deep Think;
- Claude:更新Claude Opus 4(Extend Thinking),Claude Sonnet 4(Extend Thinking);
- Minimax:升级语音模型Speech-02;
- Phi:新增推理模型Phi-4-Reasoning系列;
- 阶跃AI:新增推理模型step-r1-v-mini;
- 字节豆包:新增多模态推理模型Seed1.5-VL;
- Mistral:新增Mistral Medium 3;
- **ACE-Step:**新增音乐模型。
4月更新
- 通义千问:新增3.0版相关模型
- **Qwen:**新增Qwen3相关模型
- 文心一言:新增4.5 Turbo和X1 Turbo;
- ChatGPT: 新增GPT-4.1,o3,o4-mini;
- 智谱清言:新增海外版应用 z.ai;
- GLM:新增GLM-4-0414、GLM-Z1、GLM-Z1-Rumination;
- **可灵:**新增2.0版本;
- 可图:新增2.0版本。
如何学习AI 大模型?(文末获取)
作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
一、大模型学习路线
一个明确的学习路线可以帮助新人了解从哪里开始,按照什么顺序学习,以及需要掌握哪些知识点。大模型领域涉及的知识点非常广泛,没有明确的学习路线可能会导致新人感到迷茫,不知道应该专注于哪些内容。
我们把学习路线分成L1到L4四个阶段,一步步带你从入门到进阶,从理论到实战。
L1级别:AI大模型时代的华丽登场
L1阶段:我们会去了解大模型的基础知识,以及大模型在各个行业的应用和分析;学习理解大模型的核心原理,关键技术,以及大模型应用场景;通过理论原理结合多个项目实战,从提示工程基础到提示工程进阶,掌握Prompt提示工程。

L2级别:AI大模型RAG应用开发工程
L2阶段是我们的AI大模型RAG应用开发工程,我们会去学习RAG检索增强生成:包括Naive
RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。

L3级别:大模型Agent应用架构 进阶实践
L3阶段:大模型Agent应用架构进阶实现,我们会去学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、
MetaGPT等多Agent系统,打造我们自己的Agent智能体;同时还可以学习到包括Coze、Dify在内的可视化工具的使用。

L4级别:大模型微调与私有化部署
L4阶段:大模型的微调和私有化部署,我们会更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam
Factory等工具快速进行模型微调;并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。

整个大模型学习路线L1主要是对大模型的理论基础、生态以及提示词他的一个学习掌握;而L3 L4更多的是通过项目 实战来掌握大模型的应用开发,针对以上大模型的学习路线我们也整理了对应的学习视频教程,和配套的学习资料。
二、大模型经典PDF书籍
书籍和学习文档资料是学习大模型过程中必不可少的,我们精选了一系列深入探讨大模型技术的书籍和学习文档,它们由领域内的顶尖专家撰写,内容全面、深入、详尽,为你学习大模型提供坚实的理论基础。(书籍含电子版PDF)

三、大模型视频教程
对于很多自学或者没有基础的同学来说,书籍这些纯文字类的学习教材会觉得比较晦涩难以理解,因此,我们提供了丰富的大模型视频教程,以动态、形象的方式展示技术概念,帮助你更快、更轻松地掌握核心知识。

四、大模型项目实战
学以致用 ,当你的理论知识积累到一定程度,就需要通过项目实战,在实际操作中检验和巩固你所学到的知识,同时为你找工作和职业发展打下坚实的基础。

五、大模型面试题
面试不仅是技术的较量,更需要充分的准备。
在你已经掌握了大模型技术之后,就需要开始准备面试,我们将提供精心整理的大模型面试题库,涵盖当前面试中可能遇到的各种技术问题,让你在面试中游刃有余。

领取方式我会放在下面,希望领取了的朋友不要忘了(安全链接,放心点击)

更多推荐


 6
 0
- 0


 已为社区贡献10条内容

所有评论(0)