


- @2501_93716422


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
《FutureSightDrive:基于时空视觉链式思考的自动驾驶框架》提出了一种创新的自动驾驶视觉推理方法。该研究突破传统文本链式推理的局限,通过构建统一的图像形式时空CoT(时空链式思考),使视觉语言模型能够以视觉方式进行未来场景预测和决策。核心创新包括:1)将VLM作为世界模型生成未来帧;2)采用渐进式生成策略确保物理约束;3)设计统一预训练范式激活视觉生成能力。实验表明,该方法在nuSce
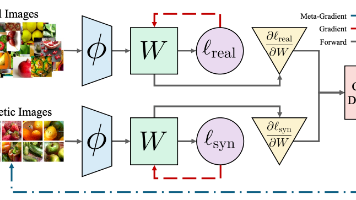
本文提出了一种针对预训练自监督视觉模型的数据集蒸馏新方法——线性梯度匹配(Linear Gradient Matching)。该方法通过优化合成图像,使其在预训练特征空间中产生的梯度与真实图像一致,从而仅需每类一张图像即可训练出高性能线性分类器。
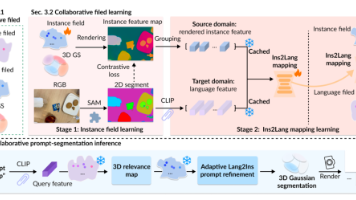
语言场方法如 LangSplat、LEGaussians 等,通过可微分渲染将 CLIP 特征蒸馏至三维语言场中,实现对语言查询的响应,但其语言特征表达能力有限,导致分割边界模糊。为此,COS3D 提出协同场(collaborative field)概念,将实例场与语言场有机结合,通过双向映射机制在训练与推理阶段实现两者的协同优化,从而在分割质量与训练效率上均取得显著提升。COS3D 的核心思路是
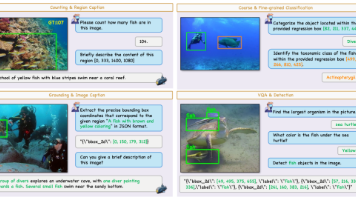
华中科技大学与国防科技大学联合提出首个水下多模态大模型NAUTILUS,突破传统水下视觉任务的局限。该研究创新性地构建了包含145万图像-文本对的NautData数据集,并设计了基于物理成像模型的视觉特征增强模块(VFE),在特征空间显式恢复水下退化图像信息。实验表明,NAUTILUS在8类水下任务中表现优异,显著提升识别准确性,且VFE模块可兼容主流多模态模型。研究成果为水下场景理解提供了新思路
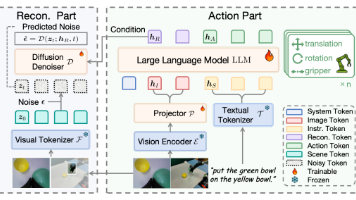
本文提出ReconVLA模型,通过隐式视觉grounding机制提升机器人操作精度。该方法让模型在训练中重建任务相关的凝视区域,引导视觉注意力聚焦目标物体。模型包含动作生成和视觉重构两个部分,使用扩散变换器从噪声中重建目标区域。
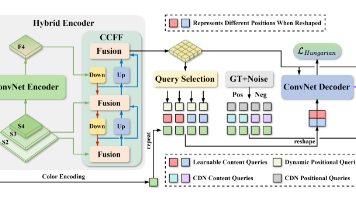
U-DECN的核心思路是在卷积编码器-解码器架构中引入多尺度特征、动态查询初始化与颜色去噪机制,以提升检测精度与速度,同时避免使用NMS和复杂注意力模块。U-DECN在卷积编码器-解码器架构中成功融合了多尺度特征、动态查询与颜色去噪机制,显著提升了水下目标检测的精度与速度,并在嵌入式设备上实现实时推理。的端到端水下目标检测模型,它基于卷积网络架构,融合了多尺度特征、动态查询初始化与颜色去噪机制,显
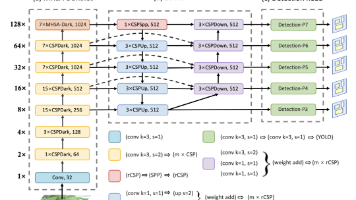
本文提出了一种名为ViT-YOLO的混合目标检测框架,用于解决无人机图像中目标尺寸差异大、背景复杂等问题。该模型将多头自注意力机制嵌入CSP-Darknet主干网络以增强全局上下文信息提取,并引入加权双向特征金字塔网络进行多尺度特征融合。
华中科技大学与国防科技大学联合提出首个水下多模态大模型NAUTILUS,突破传统水下视觉任务的局限。该研究创新性地构建了包含145万图像-文本对的NautData数据集,并设计了基于物理成像模型的视觉特征增强模块(VFE),在特征空间显式恢复水下退化图像信息。实验表明,NAUTILUS在8类水下任务中表现优异,显著提升识别准确性,且VFE模块可兼容主流多模态模型。研究成果为水下场景理解提供了新思路
本文系统综述了三维与四维世界建模方法,填补了该领域系统性综述的空白。研究聚焦从二维生成转向几何驱动的三维/四维建模,提出了基于视频、占据栅格和LiDAR的三类方法体系,并划分为数据引擎、动作解释器等四种功能类型。论文明确定义了世界建模概念,总结了VAE、GAN等生成模型在三维/四维数据上的应用,系统梳理了专用数据集(nuScenes、KITTI等)和评估指标(FID、IoU等)。实验表明,几何一致
本文提出ReconVLA模型,通过隐式视觉grounding机制提升机器人操作精度。该方法让模型在训练中重建任务相关的凝视区域,引导视觉注意力聚焦目标物体。模型包含动作生成和视觉重构两个部分,使用扩散变换器从噪声中重建目标区域。