- @2501_92994129


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
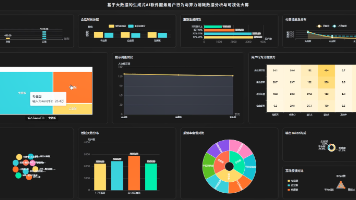
本文介绍《基于大数据的生成式AI软件服务用户行为与算力消耗数据分析》毕业设计项目,系统采用Hadoop+Spark架构,实现用户行为日志与算力数据的采集、清洗、分析与可视化。通过Java(Spring Boot)与Python(Django)双后端,结合Vue+ECharts前端,完成用户活跃度、Token消耗、输入内容排行、再生率等多维度分析,并支持异常检测与分群挖掘,全面呈现生成式AI服务的使
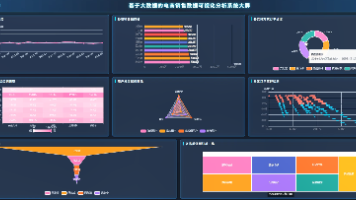
基于大数据的电商销售数据可视化分析系统,采用Hadoop与Spark处理海量数据,结合Django/SpringBoot后端、Vue前端及Echarts实现多维度可视化。涵盖销售趋势、品类结构、地区分布、支付行为等十大模块,支持时间粒度灵活分析,助力电商运营决策。代码展示涵盖数据清洗、聚合统计与动态指标计算,完整呈现从数据存储到可视化的全流程。
本文介绍了一个基于大数据的痴呆症预测数据可视化分析系统。该系统采用Hadoop+Spark技术架构,结合Python和Java开发,集成Vue.js前端框架,实现痴呆症多维度数据分析。系统包含七大功能模块,运用分布式存储、数据挖掘和可视化技术,为医疗研究提供精准预测工具。核心代码展示了脑影像分析功能,通过Spark SQL处理影像数据并计算脑区萎缩比例。系统还提供了完整的文档和演示资源,展现了大数
本文介绍了一款基于Hadoop+Spark大数据技术架构的大学生请假管理系统。该系统采用Django+Vue前后端分离架构,整合Hadoop分布式存储和Spark实时计算能力,实现学生请假申请、审批管理、数据统计分析和机器学习预测等功能。系统通过ElementUI构建友好界面,结合Echarts进行数据可视化展示,并利用Spark SQL、Pandas等技术完成从数据采集到预测分析的完整处理流程。
摘要: 本文介绍了一个基于Spark+Django的豆瓣电影数据可视化分析系统。系统采用Hadoop+Spark处理海量电影数据,后端使用Django构建API,前端通过Vue+Echarts实现交互式可视化。核心功能包括电影信息管理、评分分析、类型统计、敏感词过滤等,利用Spark SQL和Pandas进行多维度分析,并以图表形式展示结果。系统架构稳定,支持大规模数据处理与实时分析,为用户提供直
基于Bilibili青少年模式数据分析系统简介 该系统是一个采用Hadoop+Spark架构的大数据处理平台,专门针对B站青少年模式使用情况进行分析。相比传统单机处理方式,性能提升达10倍以上。系统提供Python+Django和Java+SpringBoot两套后端方案,前端采用Vue+ElementUI框架,通过Echarts实现数据可视化。核心功能包括用户行为分析、使用时长统计、特征使用频率
摘要:本文介绍了一个基于Spark的温布尔登网球赛事数据分析平台,该系统整合Hadoop、Spark等大数据技术,结合Python、Django和Vue.js实现全栈开发。平台提供赛事数据管理、可视化分析、机器学习预测等功能,支持对选手战绩、比赛统计等多维度数据进行深度挖掘。系统采用Spark SQL进行高效查询,运用随机森林等算法实现赛事预测,并通过Echarts实现数据可视化展示。文章包含平台
本文介绍了一个基于Spark的医疗大数据分析系统,该系统整合了数据采集、处理、分析和可视化功能。系统采用Python+Django+Vue.js技术栈,结合Spark SQL和Hadoop生态,实现海量医疗数据的高效处理。核心功能包括医疗数据管理、统计分析、趋势预测和动态可视化展示,采用前后端分离架构确保扩展性。通过代码示例展示了数据清洗、统计分析和风险预测的实现方式,为医疗研究提供技术支撑平台。
本文介绍了一个基于Hadoop+Spark的电商评论情感分析系统,该系统整合了多种技术框架实现从数据采集到情感分析的全流程。系统采用Spark SQL处理海量评论数据,结合Pandas、NumPy进行数据预处理,后端使用Django提供API服务,前端采用Vue+ElementUI构建可视化界面。核心功能包括评论数据清洗、机器学习情感评分预测、多维度统计分析等,并利用Echarts实现数据可视化。
本文介绍了一个基于机器学习的农产品价格数据分析可视化系统。该系统采用大数据技术栈,整合Hadoop分布式存储和Spark处理能力,对农产品市场价格进行深度挖掘与分析。系统使用Python开发核心算法模块,结合Django后端和Vue前端框架,实现数据采集、处理、分析和可视化功能。核心功能包括蔬菜/水产品信息管理、价格预测分析等模块,运用Spark SQL、Pandas和NumPy等工具进行数据查询