


- @2302_79932616


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
Day 10:混合精度训练如何加速大模型训练?可能出现什么问题?如何解决?

知识是人类对客观世界认识的结晶,它涵盖了对事实的认知、对事物的理解以及通过经验积累所获得的信息。在大语言模型(LLMs)的语境下,知识的定义与传统认知有所关联,但也具有其独特性。若LLMs能针对某一知识相关问题给出正确答案,那么我们就认为该模型掌握了这一知识。例如,当被问及“2024年美国总统是谁”,如果模型能够准确回答“拜登”,则表明它对这一知识有所掌握。这里的知识记录形式多样,既可以是文本形式

在大型语言模型中,KV Cache(Key-Value缓存)的主要作用是存储历史token的Key和Value向量,以加速自回归生成过程,避免重复计算。然而,随着序列长度的增加,KV Cache的显存占用也会线性增长,成为显存瓶颈。为了优化内存占用,Window Attention(窗口注意力)机制被引入,它通过滑动窗口的方式限制每个token的注意力范围,仅关注局部窗口内的历史信息,从而显著减少
CoT通过单一路径生成推理链,具有低计算成本和强可解释性,但容易因单步错误导致最终错误。Self-Consistency则通过多路径生成和集成,提升了准确性,尤其在复杂任务中表现更优,但计算成本较高。CoT适用于简单任务和实时交互场景,而Self-Consistency更适合高价值决策任务。两者在推理机制、计算成本和适用场景上各有优劣,选择时需根据具体需求权衡效率与精度。
【大模型面试每日一题】Day 14:大模型训练中显存占用的主要来源有哪些?如何通过激活重计算降低显存?
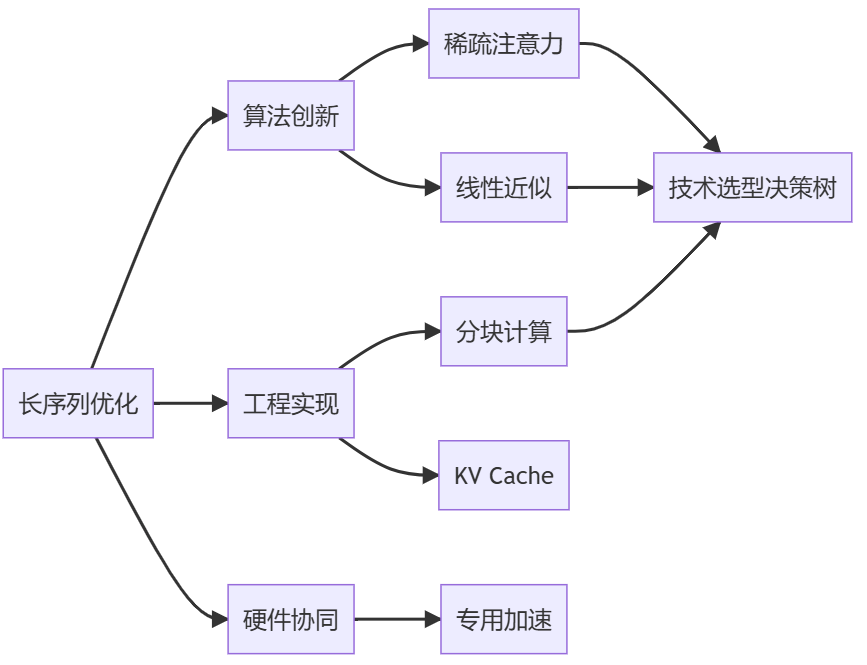
面试官:当序列长度超过10万时,你会如何改进Self-Attention?
介绍了大型语言模型的微调技术,重点探讨了有监督微调(SFT)和高效微调方法(PEFT)。有监督微调通过标注数据对预训练模型进行二次训练,使其适应特定任务,类似于医生通过专科培训获得特定领域的诊疗能力。SFT的步骤包括数据收集与预处理、模型选择与初始化、评估与优化。高效微调方法如LoRA、Adapter和Prefix Tuning则通过引入低秩矩阵、小型神经网络模块或可学习前缀向量,显著减少计算资源
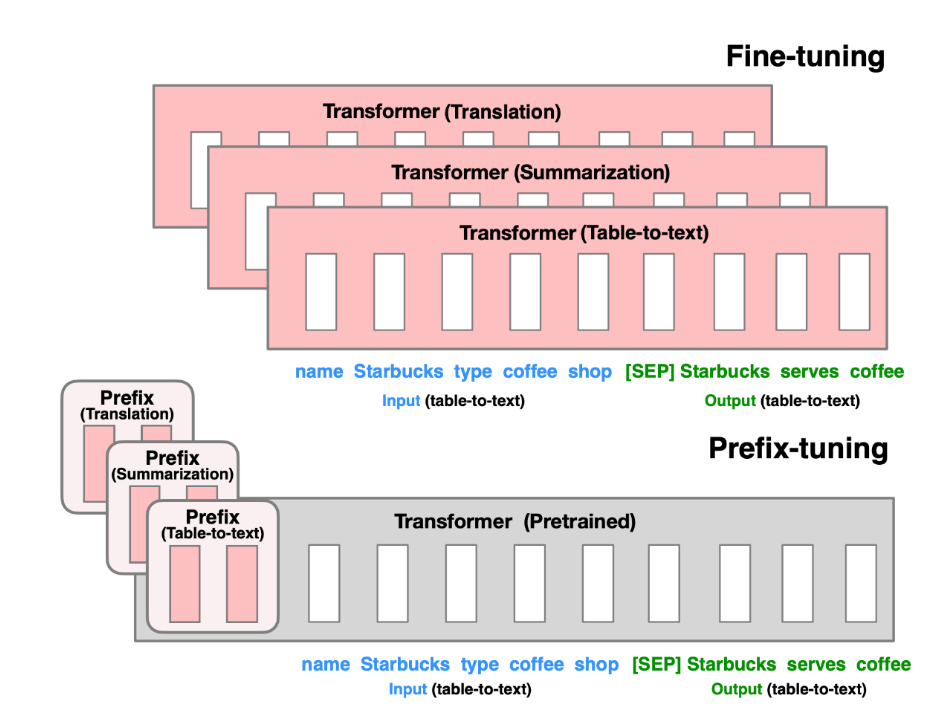
介绍了大型语言模型的微调技术,重点探讨了有监督微调(SFT)和高效微调方法(PEFT)。有监督微调通过标注数据对预训练模型进行二次训练,使其适应特定任务,类似于医生通过专科培训获得特定领域的诊疗能力。SFT的步骤包括数据收集与预处理、模型选择与初始化、评估与优化。高效微调方法如LoRA、Adapter和Prefix Tuning则通过引入低秩矩阵、小型神经网络模块或可学习前缀向量,显著减少计算资源
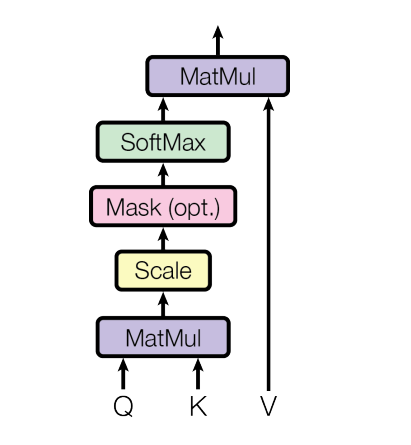
请解释Transformer中Self-Attention的计算过程,并说明为什么它在处理长序列时优于RNN?(考察概率:90%)
介绍了大型语言模型的微调技术,重点探讨了有监督微调(SFT)和高效微调方法(PEFT)。有监督微调通过标注数据对预训练模型进行二次训练,使其适应特定任务,类似于医生通过专科培训获得特定领域的诊疗能力。SFT的步骤包括数据收集与预处理、模型选择与初始化、评估与优化。高效微调方法如LoRA、Adapter和Prefix Tuning则通过引入低秩矩阵、小型神经网络模块或可学习前缀向量,显著减少计算资源