


- @2301_80215627


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
目录 一、先分清:金融的四类负载,算力画像完全不同 1. 智能文档与财报抽取(批处理型) 2. 实时风控与反欺诈(低延迟型) 3. 智能客服与问答(高并发型) 4. 合规审查与审计报告(长文 + 重质量型) 二、算力分层口径:先套负载,再算显存 三、选型:信创合规下,海光/昇腾怎么落 四、落地前先过
目录 一、先分清:金融的四类负载,算力画像完全不同 1. 智能文档与财报抽取(批处理型) 2. 实时风控与反欺诈(低延迟型) 3. 智能客服与问答(高并发型) 4. 合规审查与审计报告(长文 + 重质量型) 二、算力分层口径:先套负载,再算显存 三、选型:信创合规下,海光/昇腾怎么落 四、落地前先过
问题来了,真正卡死吞吐的从来不是"显存够不够",而是显存带宽和PCIe 带宽。这两个东西,全网讲清楚的人真不多。今天把这层窗户纸捅破。 你品,你细品——显存容量决定"能不能跑",显存带宽决定"跑多快",PCIe 带宽决定"内存兜底的时候有多惨"。 大模型的"吞吐公式":先看懂瓶颈在哪 本地推理慢,90% 的人归因于"显卡不够强"。但大模型和传统渲染不一样,它有个硬规律。
本地部署大模型,真正的"隐形账单"不是买显卡的钱——是电费和散热(实测1年跑下来才懂) 年初装机时我算的是显卡钱,年底一算账才发现算错了 先别急着往下看,我想先问你一个反直觉的问题: "本地部署大模型,最大的单笔成本是啥?" 十个人里有九个会答:显卡。那张卡动不动几万块,谁都能记住。 我年初也是这么想的。配了台机器跑 7B + 13B,花了大几万买了块高端卡,激动地在工位上开机——结果呢?用了三个
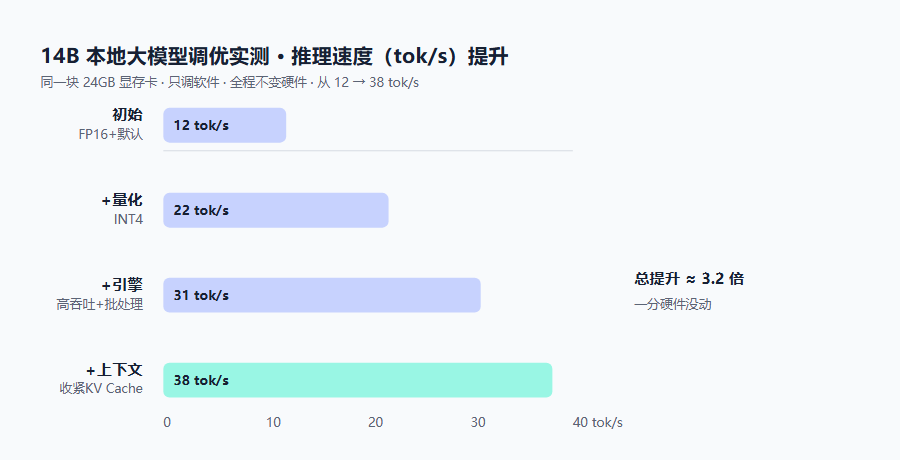
本地大模型跑得慢?先别急着加显卡,这 6 个 GPU 推理调优步骤能让你白赚 3 倍速度 本文是一篇面向已经用上本地大模型(Ollama / llama.cpp / vLLM)的开发者和技术博主的实操调优指南,聚焦"同一块 GPU 上,怎么把大模型推理从'能跑'优化到'跑得快、跑得稳'"。文中的推理速度数据、显存/上下文实测方法均基于公开技术资料与部署实践整理,不构成对任何品牌或产品的商业推荐。
企业AI算力采购白皮书。需求分类、硬件选型决策树、20个真实案例(金融/制造/政务/高校),避坑指南与2026-2027技术趋势预测。
目录 自动驾驶大模型训练到底要多少算力?数据闭环与算力账 先说结论 一、数据量,远比想象大 二、标注是算力账里最容易被低估的一环 三、训练算力:从单卡到 EFLOPS 集群 四、智驾算力怎么落地,看三个问题 五、写在最后 自动驾驶大模型训练到底要多少算力?数据闭环与算力账 面向智驾团队、车企与做端到
目录 具身智能 VLA 模型训练要多大显存?国产 GPU 训练链实测与选型思路 先说结论 一、VLA 是不是「很吃显卡」 二、国产 GPU 现在能撑住 VLA 训练吗 三、选题型的三个硬判据 四、按阶段给两档配置参考 五、写在最后 具身智能 VLA 模型训练要多大显存?国产 GPU 训练链实测与选型
企业AI算力采购白皮书。需求分类、硬件选型决策树、20个真实案例(金融/制造/政务/高校),避坑指南与2026-2027技术趋势预测。
企业AI算力采购白皮书。需求分类、硬件选型决策树、20个真实案例(金融/制造/政务/高校),避坑指南与2026-2027技术趋势预测。