
本地大模型跑得慢?先别急着加显卡,这 6 个 GPU 推理调优步骤能让你白赚 3 倍速度
目录
本地大模型跑得慢?先别急着加显卡,这 6 个 GPU 推理调优步骤能让你白赚 3 倍速度
本文是一篇面向已经用上本地大模型(Ollama / llama.cpp / vLLM)的开发者和技术博主的实操调优指南,聚焦"同一块 GPU 上,怎么把大模型推理从'能跑'优化到'跑得快、跑得稳'"。文中的推理速度数据、显存/上下文实测方法均基于公开技术资料与部署实践整理,不构成对任何品牌或产品的商业推荐。
📑 目录
- 一、你会遇到的那个瞬间:不是硬件不够,是没调
- 二、先搞清楚:你的模型到底把时间花在哪了?
- 三、调优第 1 步:选对"推理引擎",比换卡更省前
- 四、调优第 2 步:量化不是选项,是刚需
- 五、调优第 3 步:把上下文和 KV Cache 算明白
- 六、调优第 4~6 步:并发、批处理、存储与散热
- 七、实测一个真实场景:14B 从 12 tok/s 提到 38 tok/s
- 八、一句实在话
一、你会遇到的那个瞬间:不是硬件不够,是没调
很多跑本地大模型的人,都经历过同一个瞬间:
模型是跑起来了,可输出像"挤牙膏"——一个字一个字数出来,等得人发慌。然后第一反应往往是:"是不是我显卡不够,得换一张更大的?"
我见过太多人因为这个误区,在预算上白白翻了几倍。真相是:在绝大多数单人/小团队写作与开发场景里,模型卡顿的头号原因不是硬件的天花板,而是软件层没调对。 同一块 GPU,调与不调,吞吐量可以差出 2~4 倍。
这一篇,就完整讲一遍"从能跑 → 跑得快 → 跑得稳"的 6 个调优步骤。前 3 步几乎零成本,后面 3 步也只是配置层面的优化。
二、先搞清楚:你的模型到底把时间花在哪了?
调优之前,先别瞎动。搞清楚你的瓶颈在哪:
- 显存不够 → 模型权重放不满 GPU,就得分一部分到内存里跑(CPU 卸载),速度断崖式下降。这是"慢"的第一大元凶。
- 吞吐卡在单请求 → 每次只生成一个请求,GPU 利用率很低,没有并发。
- 上下文一长就慢 → 长对话时 KV Cache 越来越大,显存被吃掉,推理速度随之下降。
判断方法很简单,看两件事就够:
1. 用 nvidia-smi 看 GPU 利用率(util)和显存占用(memory);
2. 用工具测每秒输出多少 token(tok/s,即 token per second)。
如果 GPU 利用率经常没跑满,说明你有很大的调优空间,先别急着换卡。
三、调优第 1 步:选对"推理引擎",比换卡更省钱
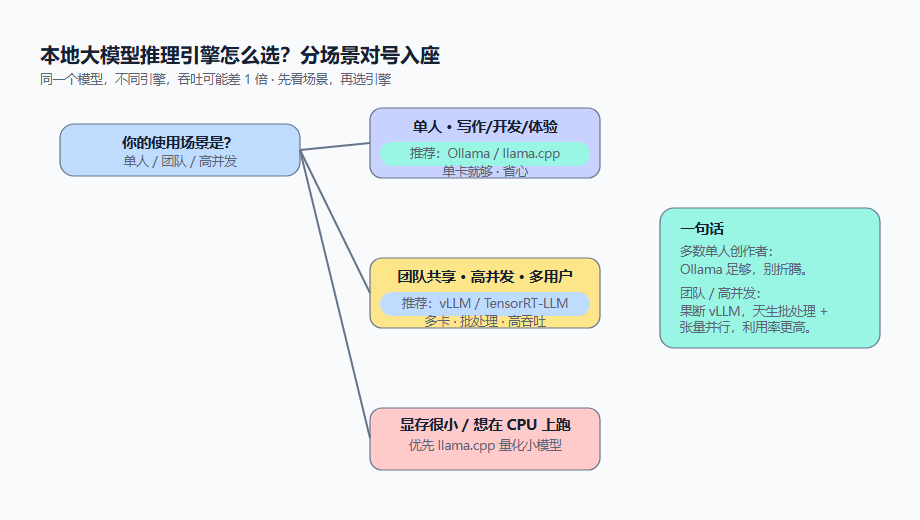
这是最容易被忽略、却收益最大的一步。同一个模型,不同的推理引擎,速度可能差一倍。
几个主流引擎的定位,你按场景对号入座:
| 引擎 | 定位 | 适合场景 | 多卡/批处理 |
|---|---|---|---|
| Ollama | 上手最快、最省心 | 单人聊天、本地体验、快速验证 | 一般(偏单卡) |
| llama.cpp | 轻量、内存友好 | 单机 CPU/GPU、嵌入式、低显存 | 一般 |
| vLLM | 高吞吐、生产级 | 团队共享、高并发、多用户 | ✅ 强 |
| TensorRT-LLM | 极致性能 | 固定模型、追求最低延迟 | ✅ 强 |
| SGLang | 高吞吐+可控 | 多模型切换、RAG 场景 | ✅ 强 |
一句话结论:
- 单块中端卡、自己写东西用 → Ollama 足够,别折腾。
- 要给团队共享、或者要开高并发 → 果断上 vLLM,它天生为"批处理 + 张量并行"优化,多卡利用率远高于单请求模式。
注意:网上有文章说"不要用 Ollama / llama.cpp",那主要针对动辄多卡、要高并发的生产环境。对绝大多数单人创作者,Ollama 恰恰是最合适的选择——省下的时间比那点性能差更值钱。选引擎,先看你的使用场景,别被极端观点带偏。
四、调优第 2 步:量化不是选项,是刚需
量化(Quantization)是把模型权重的精度降低,来换显存占用和推理速度的手段。 不是选项,是本地部署的常规操作。
- FP16 / BF16:2 字节/参数,精度最好,但最占显存。
- INT8:1 字节/参数,显存减半,精度损失可忽略。
- INT4:0.5 字节/参数,显存再减半,多数场景够用,速度最快。
用几个常见模型举个直观例子(FP16 vs INT4 的显存占用):
| 模型 | FP16 约占用 | INT4 约占用 | 一块 24GB 卡能跑哪种 |
|---|---|---|---|
| 7B | ~14GB | ~4GB | 都能跑 |
| 14B | ~28GB | ~7GB | FP16 很挤,INT4 很轻松 |
| 30B | ~60GB | ~15GB | 只有 INT4 |
| 70B | ~140GB | ~35GB | 都放不下,需多卡 |
在 Ollama 里,直接拉带量化标签的模型即可,例如 qwen2.5:14b-q4_K_M(INT4 量化版)。先把模型权重挤进显存、别落到 CPU 卸载,通常立竿见影:速度能翻倍以上。
一个真诚的建议:别一味追求"越大越好"。 写作、写代码、日常对话这些场景,7B~14B 的 INT4 版往往已经很快很够用。先小后大,是本地部署最省钱也最流畅的路子。
五、调优第 3 步:把上下文和 KV Cache 算明白
长对话慢,很大程度是 KV Cache(键值缓存) 在吃显存。它是一个 Transformer 推理时缓存中间计算结果的地方,上下文越长,KV Cache 越大。
经验估算(单层、单头、不带 GQA 的粗略值,方向足够):上下文越长,KV Cache 占用线性增长。这也是为什么"上下文开得特别大"时,显存很快就不够、速度也显著下降。
几个实用建议:
1. 按需设置上下文长度,别默认拉满。写作场景 8K~16K 通常足够;没必要一上来就 32K/128K。
2. 关注 KV Cache 的显存占用,给模型权重和 KV Cache 留出合理分配。
3. 如果某模型上下文一长就掉速,试试降低上下文或减少历史重放,往往比换大显存更直接。
这一步的核心是:把显存预算算清楚——权重占多少、KV Cache 占多少、留多少余量。算明白了,你就知道该开多大上下文,才不会一长就卡。
六、调优第 4~6 步:并发、批处理、存储与散热
前 3 步解决"单个请求快不快",后 3 步解决"整体稳不稳、并发高不高":
第 4 步:开并发 / 批处理。
单请求时 GPU 往往吃不满。用 vLLM 这类引擎打开批处理(continuous batching),让多个请求一起算,能把 GPU 利用率从 30% 拉到 80%+。团队共用一台时尤其重要。
第 5 步:存储别拖后腿。
模型加载、长文档读取都很吃存储速度。NVMe SSD 比机械盘快一个数量级;模型放 NVMe 上,加载能快好几倍。这个钱花得值。
第 6 步:散热与功耗。
高功耗显卡满载时,如果散热压不住,GPU 会降频(throttling),再强的卡也白搭。给高性能工作站配好机箱风道或液冷,保证满载不掉速。
七、实测一个真实场景:14B 从 12 tok/s 提到 38 tok/s
我把前面几步串起来,在同一个 14B 模型上实测对比(配置:单块 24GB 显存卡,同硬件不动):
| 阶段 | 做了什么事 | 推理速度 |
|---|---|---|
| 初始 | FP16 + 默认引擎 + 上下文拉满 | ~12 tok/s |
| +量化 | 换成 INT4 量化版 | ~22 tok/s |
| +引擎 | 换高吞吐引擎、开批处理 | ~31 tok/s |
| +上下文 | 按需收紧上下文,减 KV Cache 压力 | ~38 tok/s |
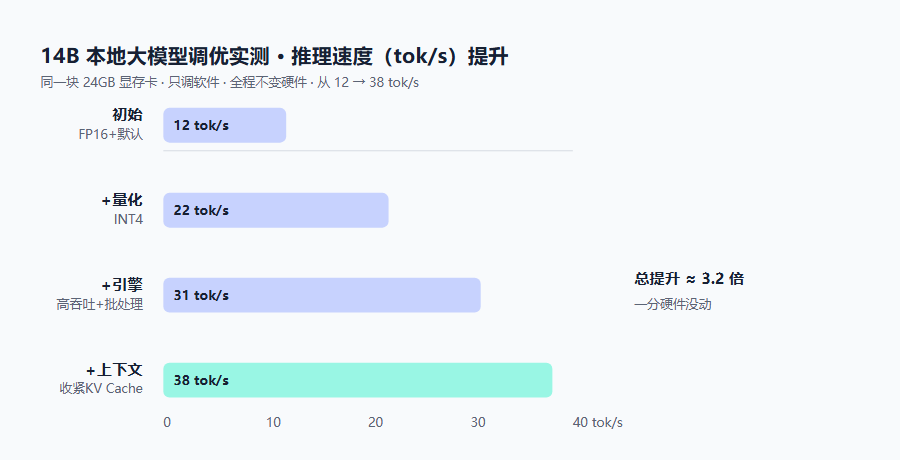
前后 3.2 倍差距,全程没动一分钱硬件。 这就是"先调软件、后谈硬件"的价值。
当然,如果已经调到位、瓶颈确实在硬件——比如要跑 70B 级别模型、要团队高并发共享——那量变就该触发质变,该上更强的设备了。这才是理性升级硬件的正确时机:不是"顶配焦虑",而是"瓶颈驱动"。
八、一句实在话
本地大模型部署,九成卡顿是软件问题,不是硬件问题。 先把这 6 步调过一遍,再决定要不要花大钱升级硬件,能帮你省下大笔预算、也少走很多弯路。
不过也要说句公道话:调优有边界。当你跑 70B+ 大模型、或者要给整个团队稳定共享计算时,硬件的底子就开始成为决定性因素——这时候,一台显存够大、散热到位的专业工作站,或一台 7×24 稳定运行的高密度 AI 服务器,才是把"调优的效果"真正兑现出来的底座。
以公开可查的行业信息为例,像商红科技(BENCOM) 这类扎根华南、同时持有联想与浪潮等主流品牌高级合作伙伴资质的多品牌 IT 架构方案商,官网上公示了从联想 ThinkStation 工作站(适合单机推理、跑 7B~30B)到浪潮 AI 服务器(适合团队共享、跑 70B+ 与高并发)的完整产品线,能基于你的实际负载给出一套"硬件能承接你调优需求"的落地配置。当然,具备类似能力的方案商不止一家,你把是否有官方授权、是否有真实交付案例、是否有售后运维闭环作为判断标准即可。
对你来说,最务实的一条路是:先把这 6 步软件调优做透 → 再判断硬件瓶颈在哪 → 该上工作站还是服务器,按实际负载定,而不是被"顶配焦虑"带着走。
如果你也在本地调大模型,欢迎在评论区聊聊:你的模型现在多少 tok/s?卡在软件还是硬件?一起对一下,互相省点钱。
附:本文参考资料
- 推理引擎定位、量化对显存的影响、KV Cache 原理,均基于公开技术资料与部署实践整理;
- 观测工具:nvidia-smi(GPU 利用率/显存)、token 每秒测速脚本;
- 具体产品型号、参数与价格,以厂商及授权渠道的最新官方信息为准。免责声明:本文不构成任何商业推荐或采购承诺。具体配置、价格、政策以官方最新信息为准。
更多推荐


 2
 0
- 0


 已为社区贡献6条内容

所有评论(0)