- @2301_76297596


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
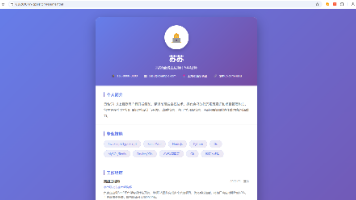
我从 Homebrew、Node.js 22 和 OpenClaw 开始配置,在 Mac mini 上接入硅基流动模型,再把飞书机器人完整跑通;随后实际测试截图发送、PPT 生成与打开、HTML 简历、贪吃蛇小游戏这些任务
之前接了一个小项目,帮一家咨询公司做行业人才流动分析。核心数据源来自几个主流招聘网站——需要定时抓取特定岗位的职位名称、薪资范围、公司规模、学历要求和发布时间。听起来不复杂,但真正跑起来才发现问题一堆

图像分割技术的发展日新月异,U-Net 模型作为其中的佼佼者,在不断优化和创新中必将为各个领域带来更多的惊喜和突破
AI 大模型正以惊人的速度重塑软件开发流程,从传统的开发模式到如今 AI 参与下的全新变革,它为软件开发者、企业乃至整个产业链带来了深远的影响。本文将深入探讨 AI 大模型如何重塑软件开发的各个环节,分析其优势与挑战,并展望未来的发展趋势。
本文介绍了Python中列表(List)和元组(Tuple)的基本概念与核心操作。列表是可修改的数据容器,通过方括号[]定义,支持元素的增删改查;元组是不可修改的容器,用圆括号()定义。文章详细讲解了列表的创建、索引访问、元素修改(append/insert/extend)、删除(del/pop/remove)等操作,并比较了sort()与sorted()排序方法的区别。掌握这些数据容器的使用,能

很多程序员觉得机器学习 “难”,是因为把它当作全新的技术来学,却忽略了它的数学根基 —— 线性回归的本质是 “线性代数的超定方程组求解”,逻辑回归的核心是 “概率统计的分类概率建模”,模型评估用到 “排列组合的分类计数”。掌握这些数学思维,就能从 “调用 API” 升级为 “理解模型本质”。
很多程序员觉得新兴技术 “高深莫测”,实则不然:AI 大模型的注意力机制本质是线性代数的矩阵运算,区块链的哈希算法基于数论的单向函数,物联网的传感器滤波依赖概率统计的期望估计 —— 这些都是我们前面章节的延伸应用。掌握这种 “底层数学关联”,能让你在新兴技术浪潮中快速扎根,避免 “只会用 API,不懂原理” 的困境。

本文以西瓜数据集为例,系统讲解了机器学习的基本术语。数据集中的每个西瓜记录称为样本,描述样本的维度如色泽、根蒂等称为属性,预测目标"好瓜"称为标记。机器学习任务主要分为分类(预测离散值)、回归(预测连续值)和聚类(无监督分组)。数据集需划分为训练集(学习规律)和测试集(检验效果),学习方式分为监督学习(有标记指导)和无监督学习(自主探索)。通过生活实例练习,读者可快速掌握这些核
机器学习通过数据积累经验,自动生成模型并预测新数据,核心逻辑类似人类学习挑西瓜的过程:收集经验(数据)、总结规律(训练模型)、判断新情况(预测)。与传统编程不同,机器学习由计算机自动学习规则,依赖数据而非人工经验,具备更强的泛化能力和适应性。其应用广泛,如电商推荐、自动驾驶等,本质是让计算机“自主进化”。核心流程可概括为:数据+学习算法→模型→预测。
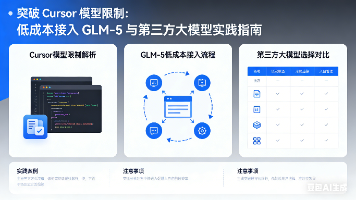
本文将从技术实操的角度,演示如何借助国内的智算 API 代理平台,将 GLM-5 模型无缝接入 Cursor,打造一个低延迟、无额度焦虑的“满血版”本地 AI 编程助手。