


- @2202_75961842


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
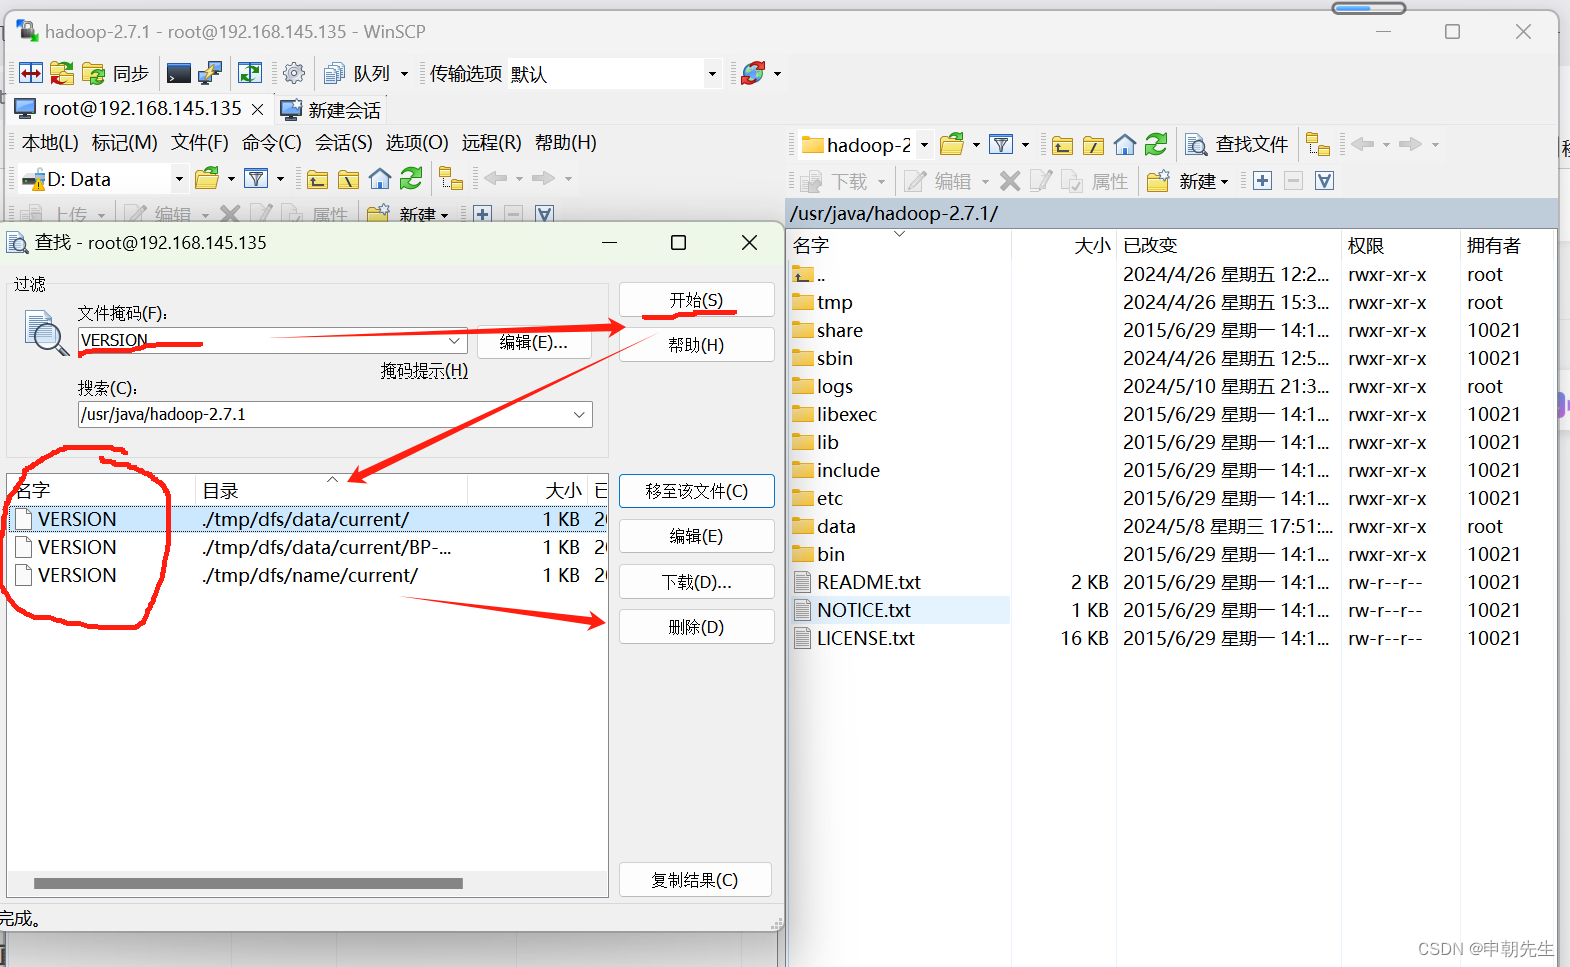
我们可以找到datanode的资料,VERSION文件,然后把所有用到datanode进程的节点上面的VERSION都删除,再在主机上重新进行格式化,再次使用。因为各种原因导致需要快照或重新配置,进入到最后一步格式化过后,开启集群发现主机进程一切正常,从节点其他进程也都有,唯独Datanode进程没有的情况。,datanode进程就可以出来了。可能是因为两次甚至多次的。然后重启Hadoop。
在 Docker 中部署 Vue 项目能有效解决环境一致性问题。其主要流程包括准备构建产物、编写构建文件、制作镜像和运行容器。下面这个流程图概括了主要步骤和关键命令:下面是每个步骤的具体细节和命令。
Hadoop在浏览器中下载出错

选择跨域方案时,若能控制服务器端,CORS是首选的标准方案。若在开发阶段或无法配置后端,代理服务器是更灵活的选择。对于特定通信场景,可考虑或 WebSocket。而JSONP主要用于兼容老旧系统。
一:案例需求现假设有数据文件num.txt,现要求使用MapReduce技术提取上述文本中最大的5个数据,并最终将结果汇总到一个文件中。先设置MapReduce分区为1,即ReduceTask个数一定只有一个。我们需要提取TopN,即全局的前N条数据,不管中间有几个Map、Reduce,最终只能有一个用来汇总数据。在Map阶段,使用TreeMap数据结构保存TopN的数据,TreeMap默认会根据

在操作Hadoop集群时,务必遵循正确的启动和停止流程,避免异常退出导致的问题。定期检查Hadoop集群的配置文件,确保各项配置正确无误。在进行NameNode格式化之前,务必备份重要数据,以防数据丢失。如果在解决问题过程中遇到其他错误或异常,请查看Hadoop的日志文件以获取更多详细信息,并根据日志提示进行相应的调整。
