


- @wlei0618


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
文章目录1、引言2、相关度概率模型3、Okapi BM25 函数3.1 逆文档频率:IDF(qi)IDF(q_i)IDF(qi)3.1.1 函数公式及参数3.1.2 函数曲线3.1.3 总结3.2 词频相关性函数:S(qi,D)S(q_i,D)S(qi,D)3.2.1 函数及参数3.2.2 相关性曲线3.2.3 k1k_1k1值的作用:3.3 文档长度相关性:KKK4、最终函数公式1、引言B
Elasticsearch term聚合 用于创建 给定字段的唯一值对应的存储桶。例如,包含国家名称的字段上的 term 聚合将为中国创建一个存储桶,为巴基斯坦创建一个存储桶,为俄罗斯创建一个存储桶,等等。在一般情况下,term聚合非常快,但在某些特殊情况下,它们可能会很慢。缓慢聚合的一个原因可能是集群配置错误。性能不佳的另一个原因可能是执行term聚合的字段上的值。在这篇博文中,我将首先简要概述

本文主要讨论在 CentOS环境下基于 rpm 包部署 ELK 系统磁盘异常占用的问题解析和解决方案。生产问题描述:以下问题现实场景基于ELK体系下,ES服务的磁盘占用问题解析。默认情况下,基于 RPM 安装的 Elasticsearch 服务的安装位置位于目录下,配置文件位于,在此前提下可能会遇到如下问题。

Elasticsearch 并没有直接提供一个 API 来返回当前系统时间,但可以通过以下方式间接获取或使用当前时间:使用 _ingest.timestamp 在 Ingest Pipeline 中获取当前时间。使用 Painless 脚本在查询或更新中获取当前时间。使用 now 关键字在查询中表示当前时间。利用 date 类型字段的默认值自动填充当前时间。使用 Kibana 的 Dev Tool

tar 文件实际上是 Docker 镜像的打包文件,它包含了镜像的所有层(layers)和元数据。Docker 镜像是通过多个层组成的,而 .tar 文件是将这些层打包成一个文件的形式。.tar 文件:当你使用 docker save 命令时,Docker 会将镜像的所有层打包成一个 .tar 文件。加载镜像:通过 docker load 命令,可以将 .tar 文件加载回 Docker,使其成为

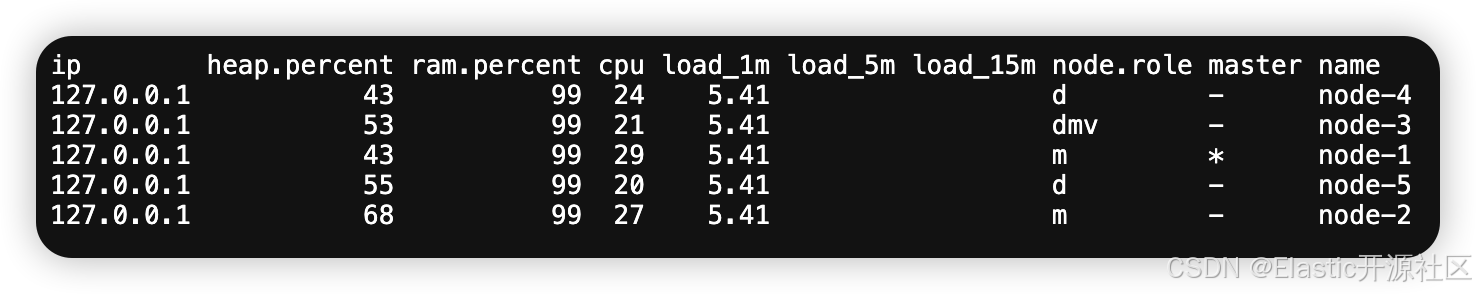
是 Elasticsearch 中用于查看集群节点状态的重要工具。通过返回的字段信息,可以全面了解节点的资源使用情况、角色和健康状况。掌握这些字段的含义,有助于更好地监控和优化 Elasticsearch 集群的性能。API 支持多种可选参数,用于过滤和格式化输出。参数,可以返回带有表头的详细输出,便于理解每个字段的含义。API 用于查看集群中所有节点的信息。在 Elasticsearch 中,
Elasticsearch 的向量检索是一种强大的技术,适用于处理高维向量数据的相似性搜索。通过将文本、图像等数据转换为向量,并结合高效的相似度计算,可以实现语义搜索、图像搜索、推荐系统等复杂场景。掌握向量检索的原理和使用方法,可以帮助开发者构建更智能的搜索应用。

Elasticsearch提供了多种方式来自动为索引添加时间戳字段。你可以通过索引映射、ingest pipeline、index template等方式来实现这一功能。根据你的具体需求,选择合适的方法来确保时间戳字段的准确性和一致性。通过合理配置时间戳字段,你可以更好地管理和分析数据,提升系统的可观测性和运维效率。希望本文对你理解和使用Elasticsearch的时间戳功能有所帮助!

search_after 是 Elasticsearch 中用于实现高效深度分页的机制。它通过基于排序值的游标机制,避免了传统分页的性能问题,特别适合处理大数据集的分页查询。使用时需要注意排序字段的唯一性和实时性,并结合实际场景选择合适的排序字段。
Elasticsearch 索引具备不可变性,字段的类型是不可修改的,包括删除字段,因此一切通过修改当前索引的操作都是不可行的,包括:update API重建索引可以通过 Script 或者 Pipline 完成过滤字段,但是后者需要创建 pipline,因此更推荐前者。
