- @wl1780852311


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
一、问题描述实验课上,老师因故暂时离开,A君与B君要游戏,但怕被抓,就委托门口的Spy同学盯梢。老师回来了,Spy分别通知A君和B君,关闭游戏,赶紧编程。二、完成如下题目要求(1)画出静态图写出采用该设计模式的好处1.观察者模式在被观察者和观察者之间建立一个抽象的耦合。被观察者角色所知道的只是一个具体观察者列表,每一个具体观察者都符合一个抽象观察者的接口。被观察者并不认识任何一个具体观...
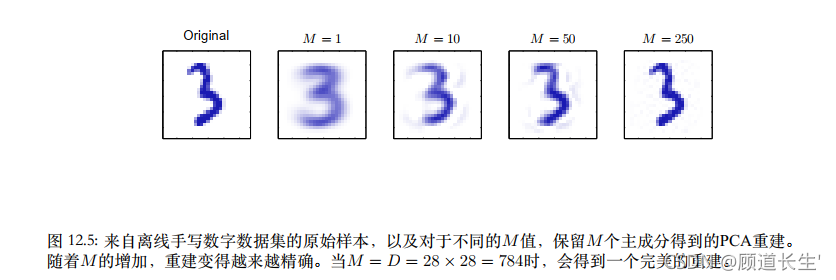
本文略微有点长,请大家耐心观看,你一定会有收获文章目录PCA数学原理数据的向量表示及降维问题向量的表示及基变换内积与投影基基变换的矩阵表示协方差矩阵及优化目标方差协方差协方差矩阵协方差矩阵对角化算法进一步讨论主成分分析(李航)16.1 总体主成分分析16.1.1 基本想法16.1.2 定义和导出16.1.3 主要性质16.1.4 主成分的个数16.1 .5 规范化变量的总体主成分16.2 样本主成
在国际象棋中马是走日字的,如果是一般情况马一共有八种走法(如下图):所以我在这边用2个一位数组来表示其8种走法//考虑到马有8种走法int dx[8]={-2,-1,1,2,-2,-1,2,1};int dy[8]={-1,-2,-2,-1,1,2,1,2};之后就让马根据这八种走法来走不过还要考虑下面3种情况第一种情况...
一、枚举类型的定义枚举类型的定义:枚举类型(enumeration)是 C++ 中的一种派生数据类型,它是由用户定义的若干枚举常量的集合。定义格式:枚举类型的定义格式为:enum <类型名> {<枚举常量表>};例如:enum color_set1 {RED, BLUE, WHITE, BLACK}; // 定义枚举类型color_set1enum week {Sun, M
摘要 本文提出VideoMage框架,首次实现了文本生成视频中多主体身份与动作模式的联合定制。现有方法仅能单独处理主体定制或动作定制,难以实现多主体的交互式动作控制。VideoMage通过主体LoRA和动作LoRA分别捕捉用户提供的图像和视频中的视觉特征与动作模式,并创新性地采用外观无关的动作学习方法消除视觉干扰。同时,提出时空协同组合机制引导多主体在目标动作下的交互。实验表明,VideoMage
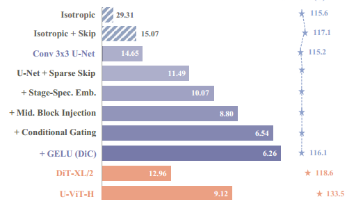
文章摘要 本文提出DiC(Diffusion CNN),一种基于纯3x3卷积的扩散模型架构,旨在替代当前主流的Transformer架构。研究发现,采用编码器-解码器沙漏结构比各向同性架构更有效,并进一步引入稀疏跳跃连接提升可扩展性。针对条件建模,提出了阶段特定嵌入、中间块条件注入和条件门控等改进。实验表明,DiC在性能上超越现有扩散Transformer,同时保持显著的速度优势。该方法为扩散模型
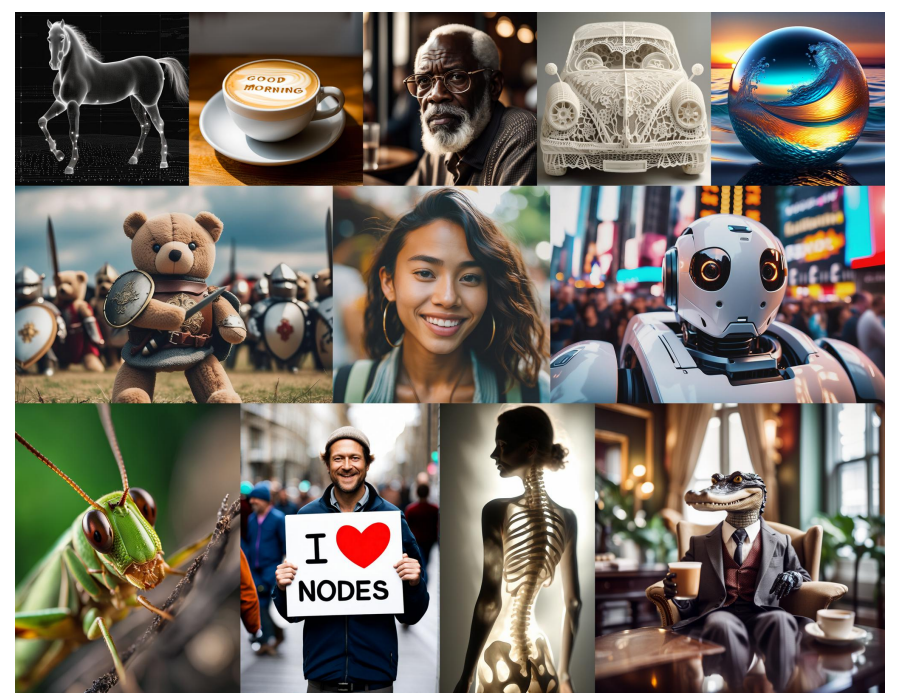
我们提出了 SDXL,一种用于文本到图像合成的潜在扩散模型。与之前版本的 Stable Diffusion 相比,SDXL 利用了三倍大的 UNet 主干:模型参数的增加主要是由于更多的注意力块和更大的交叉注意力上下文,因为 SDXL 使用第二的文本编码器。我们设计了多种新颖的条件方案并在多种纵横比上训练 SDXL。我们还引入了一个细化模型,该模型用于提高使用事后图像到图像技术由 SDXL 生成的
本文提出MaskUNet方法,通过分析扩散模型中U-Net参数的时间维度机制,发现适当置零部分参数(包括较大参数)能提升去噪效果。作者提出两种微调策略:1)训练式方法通过MLP生成时间步和样本相关的二值掩码;2)免训练方法直接利用奖励模型优化掩码。在COCO数据集上,MaskUNet在zero-shot推理中取得最优FID分数,并验证了在下游任务中的有效性。该方法不修改预训练参数,仅通过动态掩码选
扩散模型在视觉生成任务中表现出色。最近,这些模型已经从传统的 U 型 CNN-Attention 混合结构转变为完全基于 Transformer 的各向同性架构。虽然这些 Transformer 表现出强大的可扩展性和性能,但它们对复杂的自注意力操作的依赖导致推理速度缓慢。与这些工作相反,我们重新思考了深度学习中最简单但最快的模块之一 3x3 卷积,以构建一个放大的纯卷积扩散模型。我们首先发现,编

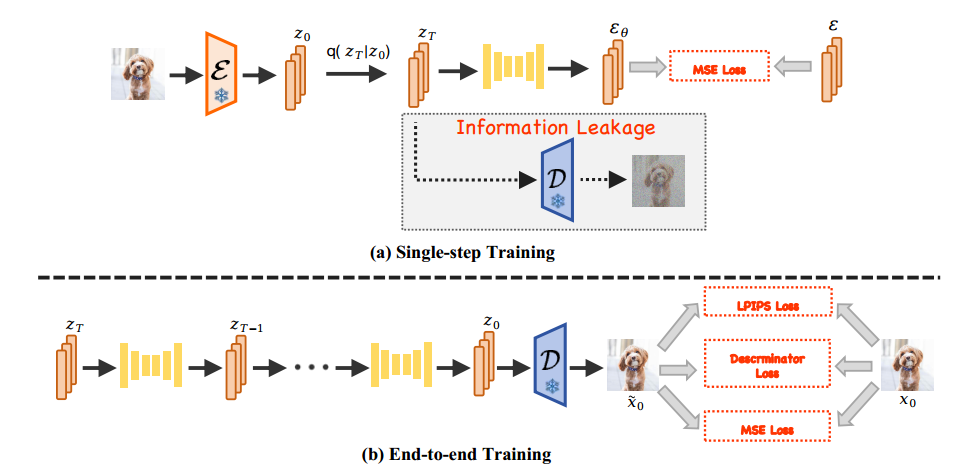
扩散模型已成为生成建模的强大框架,在各种任务中都取得了最先进的性能。然而,它们面临着几个固有的局限性,包括训练采样差距、渐进噪声过程中的信息泄漏,以及无法在训练期间纳入感知和对抗损失等高级损失函数。为了应对这些挑战,我们提出了一个创新的端到端训练框架,通过直接优化最终的重建输出来协调训练和采样过程。我们的方法消除了训练采样差距,通过将训练过程视为从纯噪声到目标数据分布的直接映射来减轻信息泄漏,并将