


- @weixin_73917603


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
对比学习学习路线:从入门到精通
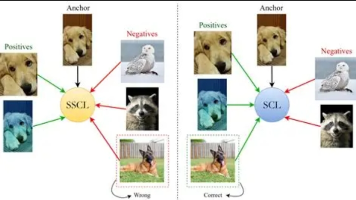
这篇文章简要介绍了数学基础中的线性代数和概率论核心概念。在线性代数部分,解释了标量、向量、矩阵和张量的层级关系,其中张量是多维数组,涵盖标量(0D)、向量(1D)、矩阵(2D)及更高维结构。还概述了矩阵运算(转置、加减、数乘、乘积)、特殊矩阵(单位矩阵、迹)以及线性方程组解的存在唯一性条件。概率论部分涉及概率质量/密度函数的归一化特性,并提及方差、协方差和常见分布。文章整体是对关键数学概念的简明梳
本文摘要梳理了信息论与数值计算的核心概念。信息论部分涵盖伯努利变量熵、衡量分布近似信息损失的KL散度(具有不对称性)。数值计算部分包括:一阶导数、梯度下降原理(梯度为各方向偏导之和)、极值点判定;二阶导数相关内容涉及曲率计算、基于泰勒展开的最优步长推导。文末提及实验课将演示相关代码实现。
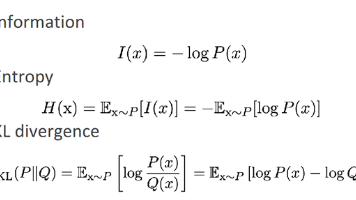
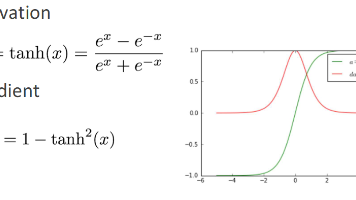
这篇文章介绍了深度学习中的关键概念和方法。主要内容包括:1)机器学习的基本定义(任务T、性能P、经验E);2)线性回归示例和误差类型(训练/测试/泛化误差);3)模型容量与泛化能力的关系;4)感知机和深度神经网络结构;5)基于梯度的学习方法(反向传播)和常用损失函数(交叉熵);6)三种输出类型和隐藏单元激活函数(ReLU、sigmoid、tanh);7)网络架构设计原则;8)反向传播计算中的链式法
本文介绍了在Jupyter中使用Matplotlib进行数据可视化的面向对象(OO)风格编程方法。主要内容包括:1) 环境配置要求(Python≥3.9及相关依赖库);2) 解决中文显示问题的通用方法;3) Matplotlib的两种编程风格对比,重点讲解面向对象风格中Figure(画布)和Axes(坐标轴)的分离概念;4) 通过代码示例演示了创建空白图表、添加子图(add_subplot方法)以

( w^{(t)} ) 和 ( w^{(t+1)} ) 是模型的参数状态。( \eta_t ) 控制更新的步长。( \nabla_{w^{(t)}} L ) 指示损失函数的下降方向。( L ) 量化了模型的误差。“前向存结果,反向链式传;本地 Jacobian,乘以上层梯;一步降学习,万卷梯度平。
本文介绍了多层神经网络与反向传播机制。文章首先解释了单层感知机的局限性,提出通过添加隐藏层和非线性激活函数来增强模型表达能力。重点讲解了三种常用激活函数(Sigmoid、Tanh、ReLU)的特性及适用场景。通过手写数字识别案例,展示了前向传播的计算流程。在反向传播部分,作者以"梯度快递"的比喻生动阐释了链式法则的运作原理,并提供了PyTorch实现示例和常见门电路的梯度规则。
摘要:本文通俗讲解神经网络反向传播原理,通过投篮类比说明"前向传播-损失计算-反向传播-参数更新"的学习过程。重点解析链式法则如何将误差梯度逐层分解,并强调激活函数非线性对模型能力的关键作用。文章提供了完整的NumPy实现代码,包括参数初始化、激活函数、前向/反向传播及损失计算,帮助读者从零理解并搭建两层神经网络。
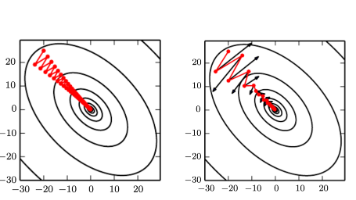
想象一下,训练一个深度学习模型就像是在一个巨大、黑暗且地形复杂的山谷里寻找最低点(即损失函数的最小值)。优化就像是你的寻路策略。你是选择一步看一步(随机梯度下降),还是先观察整个山谷的地形再行动(批量梯度下降)?你是直来直去,还是借助惯性(动量)更快地滑行?正则化则像是给你的寻路装备增加约束。为了防止你只在训练走过的小路上表现优异(过拟合),你需要一些方法让自己变得更“皮实”,能适应各种未知的路况
作者:南方的狮子先生日期:2025-10关键词:PyTorch、深度学习、CNN、CIFAR-10、Autograd、CUDA、初学者。
