- @weixin_54625990


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
如果不了解背景的同学可以查看之前的文章,以便于大家学习交流!其实逻辑也简单的,就是根据主键唯一标识分割数据发给不同的节点上两阶段执行,每个节点都是执行会监听Binlog的日志变化读取变化的数据发给节点Sink根据主键更新Source的数据源是一个CDC的数据源Sink端的数据源是一个JDBC的数据源的这个跟写业务代码处理数据同步有啥区别么?比如说同步一张有几千万数据的一个单表,第一步:分页根据id
Apache SeaTunnel作为一个高效、灵活的数据集成平台,在数据中台战略中扮演着重要角色。通过本文的介绍,读者可以了解如何基于SeaTunnel快速搭建数据集成平台,并在实际应用中灵活运用。未来,随着技术的不断发展,SeaTunnel将继续在数据集成领域发挥重要作用,助力企业实现数据驱动的业务变革。本文由白鲸开源科技提供发布支持!
在数字化转型加速的今天,金融行业正面临前所未有的数据挑战:数据量指数级增长、任务调度日益复杂、数据源类型多样化、处理链路不断延长。某证券公司,作为国内领先的综合性券商,面向内部高强度的 IT 运维与业务流程自动化需求,构建了覆盖调度控制与数据集成的双引擎体系。

Apache SeaTunnel 是一个非常易用的超高性能分布式数据集成产品,支持海量数据的离线及实时同步。每天可稳定高效同步万亿级数据,已应用于数百家企业生产,也是首个由国人主导贡献到 Apache 基金会的数据集成顶级项目。SeaTunnel 主要解决数据集成领域的常见问题:数据源多样:常用的数据源有数百种,版本不兼容。随着新技术的出现,出现了更多的数据源。用户很难找到能够全面快速支持这些数据
Connector-JDBC模块使用自动服务加载器(ServiceLoader)实现方言组件的自动加载(目前大部分开源组件都会使用类似机制以提高程序的可扩展性)。同时华为增强的ClickHouse版本是基于ELB(Elastic Load Balance)的HA部署架构,需要通过Https协议访问高可用的ELB节点。基于通用性的考虑,采用增强Connector-JDBC的方式,使该连接器兼容华为增
2023年4月15日,一场别开生面的大数据盛会在成都春日阳光下圆满落幕。由ApacheDolphinScheduler和Apache SeaTunnel社区联合主办,批流一体与大数据最佳实践技术主题活动在成都成功举办。此次活动吸引了50+大数据领域的技术爱好者、行业精英和专家齐聚一堂,共同探讨大数据调度、数据集成等前沿技术和最佳实践。活动开始,白鲸开源高级社区经理曾辉进行了活动开场,对来到现场参.
数据仓库通过分层结构,使得每层数据都有特定的应用范围和职能,从而保证数据结构层次更清晰,结构更明确。使用时,数据表的层级划分能帮助用户快速理解和定位相关数据,减少查询复杂性。
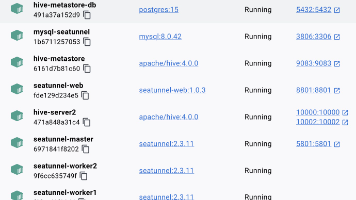
本文档详细介绍如何使用 Docker 部署 SeaTunnel 2.3.11,并配置 Kafka 虚拟表、数据源以及 Kafka 同步到 Hive 和 Elasticsearch 的完整实战案例。
本文档将深入解析 Apache SeaTunnel 支持的三大执行引擎:Zeta (SeaTunnel Engine)、Flink 和 Spark。我们将从架构设计、核心特性、优缺点对比以及使用方法等多个维度进行详细讲解,帮助你根据业务需求选择最合适的引擎。

数据仓库做大之后,最先“失控”的往往不是数据,而是命名。命名规范看似细节,却直接决定了数据是否好找、好用、好维护。