

写文章


- @weixin_52056073


简介
该用户还未填写简介
擅长的技术栈
未填写擅长的技术栈
可提供的服务
暂无可提供的服务
yolo系列tensorRT推理中的NMS(非极大抑制的实现)
本文是基于c++并根据yolov11模型编写的基于非极大抑制的操作。不同的模型输出还得根据实际情况修改代码。

基于窗口的注意力机制
在Swin Transformer中的划分窗口操作我个人认为实际上基于窗口的自注意力机制就是将原本的图像大小除以窗口的大小从而获得总的窗口的数量然后合并到Batch_size这个维度上。会把所有的元素按顺序重排,这样可能无法保持窗口之间正确的空间关系,导致恢复后的图像丧失空间结构。其次,图像在被拆分成窗口时可能存在边界处理、填充等问题,简单的。在划分完窗口送进Transformer块后需要调整回原
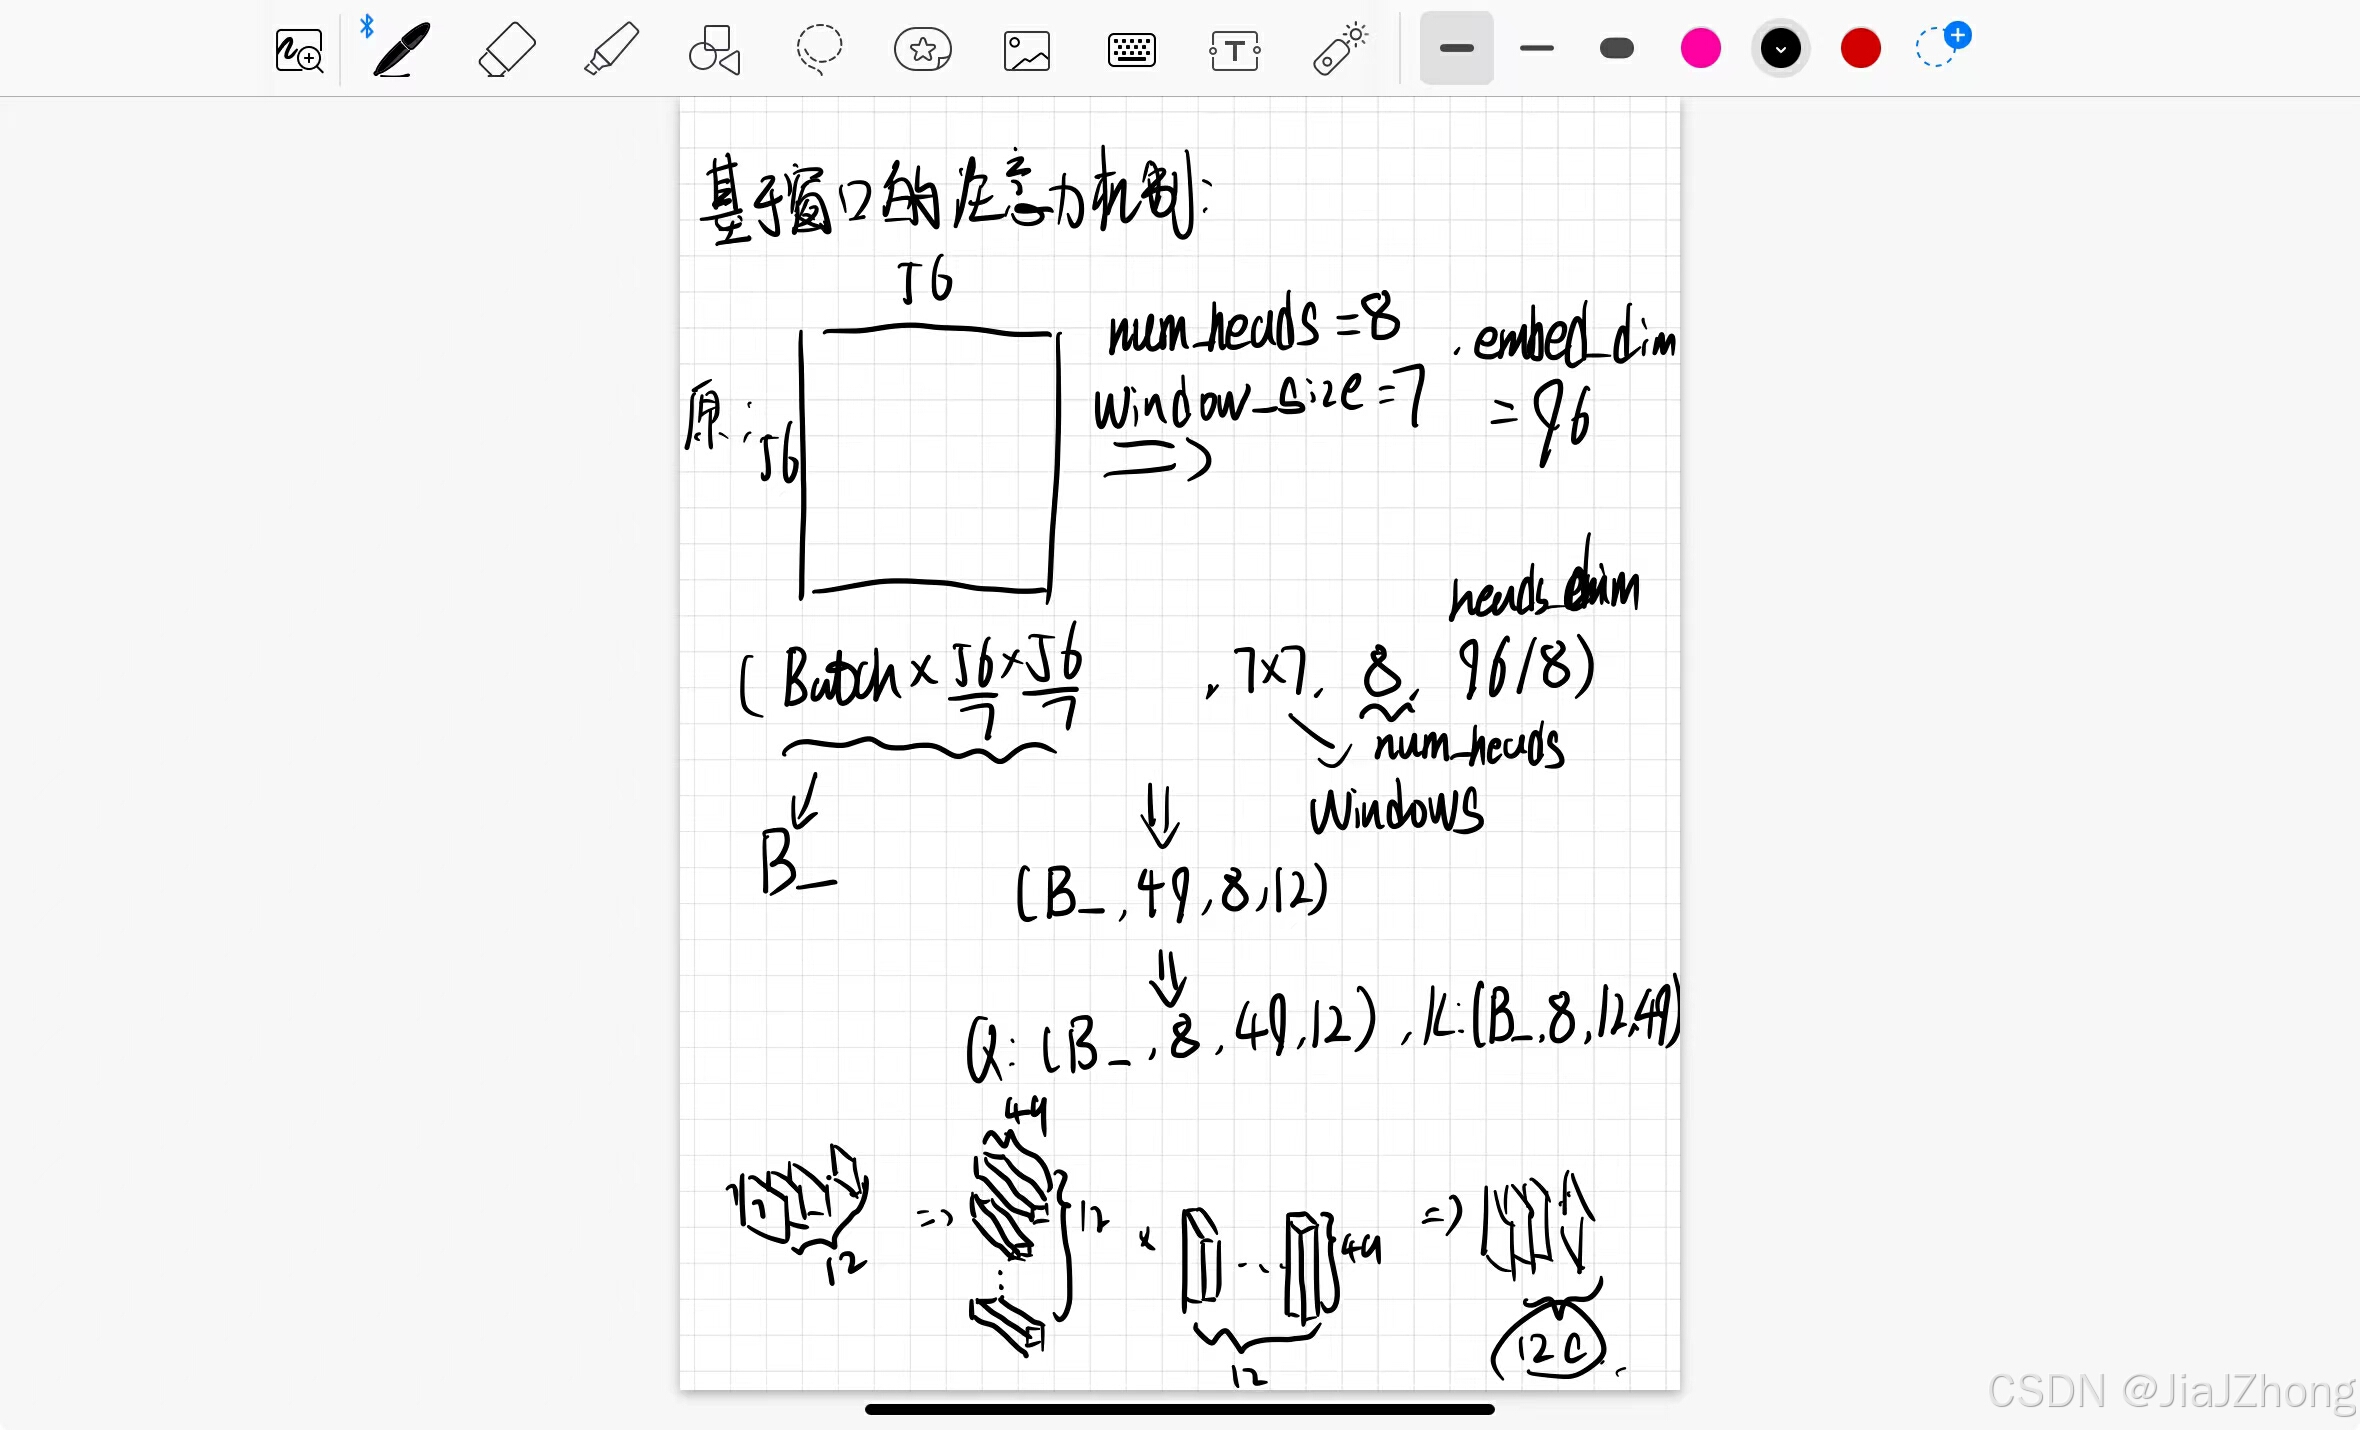
多头注意力机制(CV)
虽然代码中通过 reshape和 permute。
3×3、5×5 和 7×7 卷积核的区别
3×3:更适合捕获细节,通过堆叠获得更大感受野。5×5:适合中等感受野,平衡细节和上下文信息。7×7:用于全局感知,更适合注意力机制或任务初始阶段。选择卷积核大小需根据任务需求、网络深度和计算成本综合权衡。

到底了