- @weixin_50197960


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
随着RTX 5090的到来,我们看到了一款在AI模型推理、微调与中型训练任务中表现出色的全能GPU。与此同时,RTX 4090 48GB凭借更大的显存,在长上下文与多任务并发下仍具优势。

这些方案基于强大的 NVIDIA GPU 技术(如 H100/H200 NVL、RTX PRO 6000 Blackwell、L40S 和 L4),并可通过灵活适配 8卡、标准服务器、高密度、边缘计算及工作站等不同形态的硬件平台来实现,精准满足不同规模与需求的 AI 部署。

相比 B200 这类面向超大规模训练的数据中心 GPU,NVIDIA本次在GTC 2026上推出的 RTX PRO 4500 Blackwell Server Edition,更像是一款直接面向企业侧部署环境设计的产品。从规格上看,它并不追求绝对性能上限,而是在算力、功耗、形态与部署适配之间做了一个更工程化的平衡,这种取向在当前企业 AI 基础设施落地阶段反而更具现实意义。
特朗普政府宣布允许英伟达等公司向中国出售AI芯片,但将从中抽取25%的分成,并表示这一安排也将适用于AMD、英特尔等其他芯片公司。

英伟达通过对NVLink带宽、FP64运算及Tensor Core算力做“阉割”,巧妙规避美国对高端AI芯片的出口管制,同时保留核心AI与HPC性能,从而巩固其在全球最大半导体市场的份额。特供版策略既是技术创新的体现,也是地缘政治压力的产物。短期内,这些产品仍能满足部分市场需求,但长期需应对国产芯片崛起和美国政策的不确定性。NVIDIA若再推新特供版,你认为它会如何平衡性能与政策?下一次禁售的“红

SYS-210SE-31A是Supermicro在日益流行的边缘服务器领域的最新产品。有趣的是,这款2单元430mm短深度服务器提供了3个热插拔节点,每个节点都有1个CPU和8个DIMM插槽。
从场景复杂度、传感器、并行环境和持续运行方式分析机器人仿真对CPU、GPU、显存、内存、NVMe与网络的需求,并说明工作站、服务器和多GPU平台的适用边界。
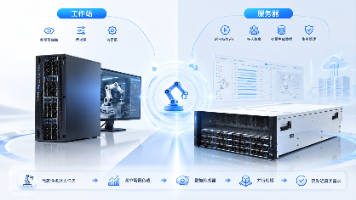
从数据处理、机器人仿真、模型训练和真机推理四条链路拆解CPU、GPU、显存、内存、存储与网络需求,并给出工作站、服务器和集群的升级判断方法。
AI智能体接入EDA工具后,新增负载并不只在GPU。本文按逻辑仿真、并行回归、本地大模型和多物理场等任务拆解CPU、GPU、内存、NVMe与共享存储的配置逻辑,并给出PoC指标。
本文基于截至2026年8月5日的官方资料,对比Qwen3.8-Max与Kimi K3的API状态、开放权重、MoE参数口径、精度、推理引擎、集群拓扑、1M上下文、Coding Agent基础设施及企业PoC路径。GPU卡数需在目标环境完成验证后确定。