


- @weixin_48708052


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
工程团队已经会把云端 Agent 接到触发器上:新 Issue 进来就复现打标,PR 打开就留评,Sentry 报警就排查,CI 挂了就找回滚,文档和 changelog 跟着改,浏览器代理做一轮视觉验收。Trigger → Agent Activity,单点风险低、成本低,也确实能培养手感。我起初觉得把这些点连起来,软件工厂就出现了。后来看完一轮“评审变好了、分诊还是老样子、QA 读不到评审学到
2020 年 Shopify 全押 React Native,同一套功能写一次、没有移动背景的人也能进应用、功能对齐不再靠人肉追。2025 年 1 月 Mustafa Ali 还写过:React Native 的未来足够亮,公司会继续投。那句话在当时的前提上成立。前提在 2025 年下半年被编码模型改掉了:Swift 和 Kotlin 各写一遍,不再自动等于双倍工期。他们没有因为一次成功的押注就把
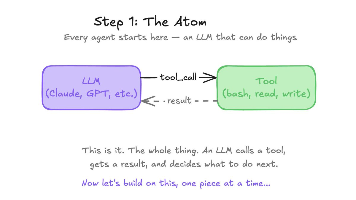
能干活的 Agent 缺的往往不是又一段系统提示,而是一套能管上下文、会省着使工具、能调度子 Agent,并且让进程在文件和代码之间连续跑上几天的基础设施。OpenAI 把这套东西从 Codex 和 ChatGPT for Work 里抽出来,做成 2026 年 9 月 10 日进入公开测试的 Agents API:一次调用里写下任务、模型、工具和环境,harness 由他们托管维护,计算放在官方
恭喜!你现在拥有了一个完全离线、零成本、功能媲美 Claude 的个人 AI 助理。用 Qwen3 + OpenClaw 的组合,日常办公、编程、总结文档、自动化任务全都搞定。本次 Auth 配置更新让你的本地部署更加规范和未来兼容,强烈建议所有用户按新写法配置。后续我还会出《OpenClaw 技能开发实战》《多设备同步》《与 VS Code 深度集成》等进阶篇。有任何问题,欢迎在评论区留言(或直

LLM-as-a-Judge(简称 LLM Judge)是一种评估范式:让一个能力更强或独立配置的大模型,充当“裁判”,去评估另一个模型的输出质量。它的目标不是替代人工,而是在可控成本下,逼近人工判断。自 GPT-4 之后,研究和实践都发现:强模型在很多开放任务上的评估结果,与人类偏好高度相关。在一些任务上,一致率可以达到 85%-95%。这使得 LLM-as-a-Judge 从研究实验,迅速进入
OpenClaw 在 84 天内狂揽 20 万 GitHub Stars,成为史上增长最快的开源仓库!现在很多人用一台老游戏本就能跑起全自主 AI 代理:在 Telegram 发一条消息,就能让它帮你管理整个邮箱、控制智能家居,甚至拍 TikTok 爆款视频。Andrej Karpathy(@karpathy)上周末专门去苹果店买了台新 Mac mini,就为了在家玩 Claw。他吐槽店员说:“这
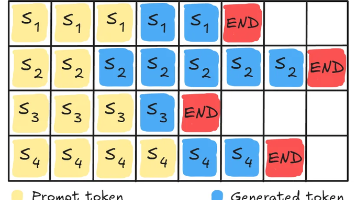
传统ML推理是“固定输入、固定输出、独立请求”,LLM推理则是“变长输入、变长输出、强依赖缓存、动态路由、两阶段分离”。几乎每个环节都不一样,这也是为什么LLM推理引擎必须从零重构的原因。👉 你还知道LLM推理和传统推理之间其他重要的区别吗?欢迎在评论区分享你的发现!我们下期继续深挖Paged Attention和更前沿的推理优化技术。(完)
服务端签名响应:AI 模型服务器在生成响应后,使用官方私钥对响应内容签名,并将签名附加到输出中。用户接收后,用官方公钥验证。客户端签名 Prompt:用户生成 RSA 或 ECDSA Keypair,将公钥注册到服务器。发送 Prompt 时,用私钥签名 Prompt,服务器验证签名后处理请求。这取代 API Key,避免 Key 静态泄露。官方密钥对:AI 服务提供商生成一对非对称密钥(私钥保密
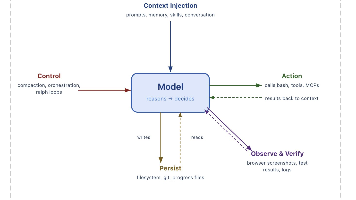
Agent 的本质从来不是大模型本身,而是围绕它构建的 Harness 系统。模型提供智能,Harness 让智能落地。谁把 Harness 工程做得越深、越巧妙,谁就能把今天的模型变成明天的超级生产力引擎。这才是 AI Agent 时代真正的“内功心法”。我是紫微AI,我们下期见。(完)
Lost in the Middle不是巧合,而是Transformer softmax竞争 + Attention Sink + Recency Bias + 有限bandwidth的必然产物。模型本质是个聪明的“内存路由器”,而不是全能记忆体。搞懂这一点,你不仅能写出更稳的prompt,还能看清下一代长上下文架构的真正突破口在哪里。context长度只是表象,attention带宽才是决定模型