


- @weixin_44021329


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
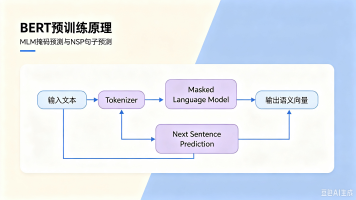
介绍 BERT 预训练的 MLM 掩码语言模型、NSP 下一句预测两项自监督任务,分析任务实现细节与存在问题,梳理 BERT 预训练流程、下游微调方法以及 RoBERTa、ALBERT 等变体模型的核心改进
在深度学习与大模型开发中,数据要经历「Python 列表→Numpy 数组→PyTorch 张量」三次形态转换。矢量化将原生列表转为规整数组,摆脱循环低效运算,是传统机器学习与数据预处理的底层支撑;张量化基于数组生成张量,依托 GPU 硬件加速、自带自动求导,是 Transformer、LLM 大模型的核心算力底座。本文从数据格式、适用场景、代码实例区分矢量化与张量化,理清大模型最底层的数据运行逻
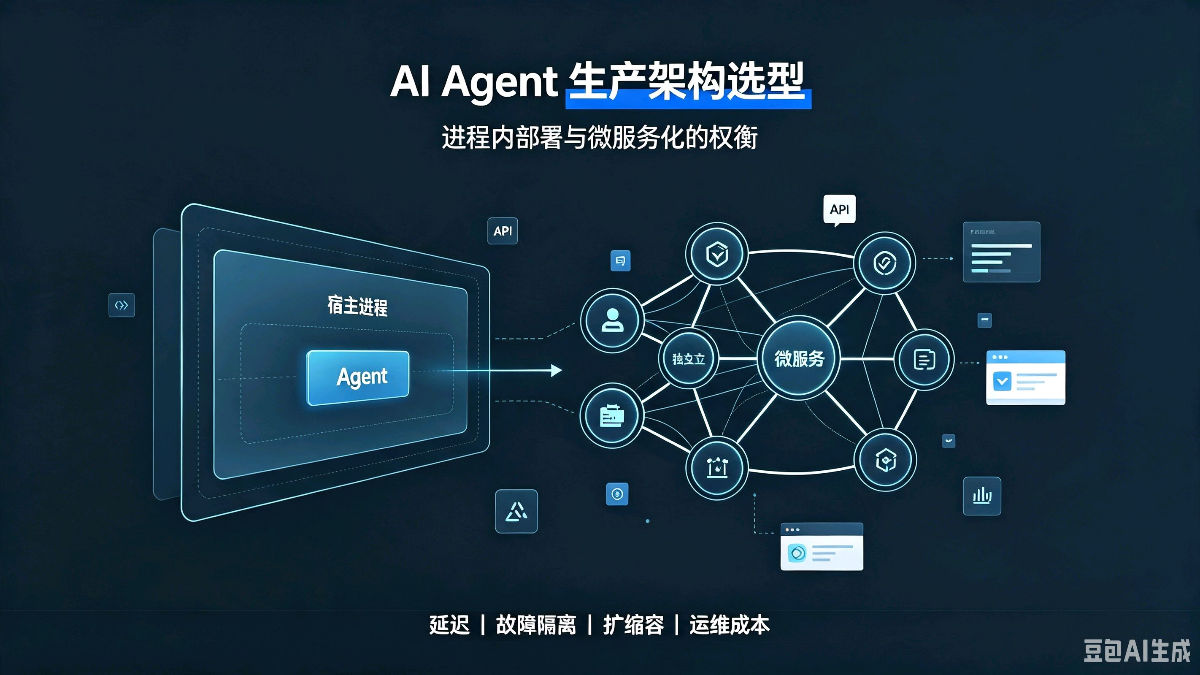
在AI Agent项目开发中,很多开发者都会遇到一个核心架构选型问题:Agent逻辑应该内嵌在业务进程中,还是拆分为独立微服务部署?这两种部署模式决定了项目的性能、可用性、可扩展性和运维成本,也是企业级Agent落地的核心知识点。本文将通俗易懂地讲解进程内Agent和独立微服务Agent的核心原理、优缺点、适用场景,附带可运行Python实战代码和生产选型方案,适合新手学习、面试复盘和项目落地参考
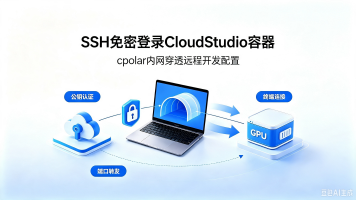
CloudStudio 免费 GPU 容器仅支持网页 IDE 访问,无法直接通过 SSH 远程连接。本文采用 cpolar 内网穿透,将容器 22 端口 SSH 服务暴露至公网,搭配 SSH 密钥免密登录方案,实现 Windows WSL2 终端一键远程登录云端容器,方便本地开发、远程模型训练。同时整理实操过程大量踩坑点,适合新手完整复现。
大模型自回归推理分为 Prefill 与 Decode 两个核心阶段,KV Cache 是推理加速的关键数据缓存机制。本文从底层原理出发,系统讲解 KV Cache 工作逻辑、GPU 算子执行机制、vLLM 分页优化方案,并解析 TTFT、TPOT 两大推理性能指标,串联大模型部署完整链路,帮助开发者理解推理性能瓶颈与工程优化思路
大模型全参微调硬件门槛极高,PEFT参数高效微调成为工业界主流方案。本文讲解PEFT核心概念,对比LoRA、QLoRA、DoRA三者原理、优缺点、适用场景,附带代码示例与选型建议,帮助快速落地大模型微调。
本文系统梳理了大模型从预训练、持续预训练、SFT 微调、RLHF/DPO 对齐、主动学习、KV 缓存、注意力优化、模型量化、归一化处理到数据集范式与评测体系的核心知识,重点面向 AI 面试与工业落地场景,兼顾理论原理和工程实践,适合作为大模型技术学习、面试复习和技术博客收藏参考。
Softmax交叉熵损失是分类、对比学习的基础损失函数,其与生俱来的梯度不对称性是深度学习训练中各类训练问题的核心诱因。CLIP模型使用的InfoNCE损失本质是跨模态版Softmax损失,完整承袭了该固有特性。本文从数学原理、梯度特性、训练弊端三个维度拆解Softmax不对称性,延伸分析CLIP InfoNCE的训练缺陷,最终详解负采样(难负样本挖掘)的核心作用与优化逻辑,系统梳理分类学习与多模
在AI Agent项目开发中,很多开发者都会遇到一个核心架构选型问题:Agent逻辑应该内嵌在业务进程中,还是拆分为独立微服务部署?这两种部署模式决定了项目的性能、可用性、可扩展性和运维成本,也是企业级Agent落地的核心知识点。本文将通俗易懂地讲解进程内Agent和独立微服务Agent的核心原理、优缺点、适用场景,附带可运行Python实战代码和生产选型方案,适合新手学习、面试复盘和项目落地参考
在深度学习与大模型开发中,数据要经历「Python 列表→Numpy 数组→PyTorch 张量」三次形态转换。矢量化将原生列表转为规整数组,摆脱循环低效运算,是传统机器学习与数据预处理的底层支撑;张量化基于数组生成张量,依托 GPU 硬件加速、自带自动求导,是 Transformer、LLM 大模型的核心算力底座。本文从数据格式、适用场景、代码实例区分矢量化与张量化,理清大模型最底层的数据运行逻