- @weixin_41072743


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
相位相关:利用傅里叶变换,根据傅里叶的平移特性,两幅图像如果存在平移,那么他们的互功率谱的相位差就是一个线性斜坡,其逆傅里叶变化就会形成峰值。基于特征的方法核心思想是: 不把整张图片交给算法,而是找出图像中的代表性的特征,独一无二的角点或者斑点,再根据这些点的周围生成一个描述子,最后使用这些描述子进行匹配,识别或者三维重建。(对线性光照变化鲁棒,计算相对简单,但是对于旋转,缩放。这个是基于区域,也

步骤 1:将 IP 地址来源改为「静态」(核心操作)步骤 2:冷重启 BMC 使配置生效。就算主机关机、死机、进不了系统,一、通过进bois来看 按esc。步骤 3:验证配置是否生效。

答题卡自动识别是计算机视觉在教育场景中的经典应用,核心目标是基于扫描或拍摄的答题卡图像,自动识别考生填涂的选项、与标准答案对比,最终完成评分并统计正确率。该项目无需人工干预,可大幅提升阅卷效率,适用于考试、测验等大规模答题场景。项目核心逻辑是 “先规范图像,再定位选项,最后判断填涂状态”,融合了 OpenCV 图像处理(透视变换、二值化、轮廓检测)等关键技术,无需深度学习模型,仅通过传统图像处理即

翻转二叉树,交换左右孩子节点,使用中序遍历或者后序遍历都可以只会递归法1、确定递归函数的参数和返回值参数就是要传入节点的指针,不需要其他参数了,通常此时定下来主要参数,如果在写递归的逻辑中发现还需要其他参数的时候,随时补充。返回值的话其实也不需要,但是题目中给出的要返回root节点的指针,可以直接使用题目定义好的函数,所以就函数的返回类型为TreeNode*。2、确定终止条件当前节点为空的时候,就

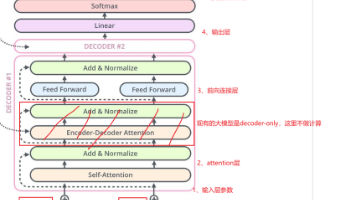
所有参数=$$词向量维度 × (词表大小 + 窗口长度) +(4D^2 + 8D^2 + 5D)*注意力层数 $$,D为词向量维度代码计算看7、代码计算。(计算复杂度和宽度是平方关系,和层数是线性关系)
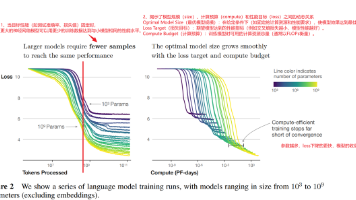
量变引起质变,当规模达到一定程度的时候,产生了一种群体的现象,这种群体的现象再也不能从原来的个体现象推知,可能需要一个新的学科,或者一些新的定律来研究整体的系统。(说人话就是一开始模型学习翻译的,训练完之后,模型也学会了做完型填空……)总结:大模型出现涌现现象(Emergent Abilities)的本质是复杂系统在规模效应和高维表征能力的共同作用下,产生的非线性相变。小模型不具备,但是大模型拥有
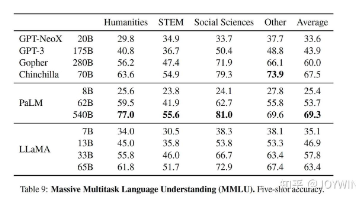
LLaMA是一个系列模型,模型参数量从7B到65B。在大部分的任务上,LLaMA-13B强于GPT-3(175B)。LLaMA-65B的性能,可以和最好的LM相媲美,如Chinchilla-70B 和PaLM-540B。
参考视频:【BERT 论文逐段精读【论文精读】】 https://www.bilibili.com/video/BV1PL411M7eQ/?
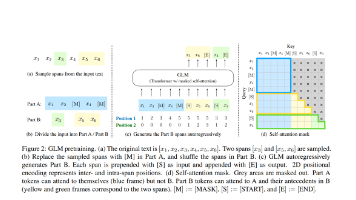
GLM:https://arxiv.org/abs/2103.10360GLM130B: https://arxiv.org/abs/2210.02414 code: https://github.com/THUDM/GLM-130B/Code: https://github.com/THUDM/ChatGLM-6B相关博客参考(按优先级顺序):https://blog.csdn.net/zsq_
论文题目Training language models to follow instructions with human feedback,即训练语言模型,使得它们能够服从人类的一些指示。语言模型每次是给定一段东西,然后去预测下一个词,它是一个自监督模型,所以认为它是没有标号的。如果想让语言模型去解释某一个概念的话,就需要文本中出现过类似的东西,因此模型的行为取决于文本搜集的好坏。这样的问题在