


- @wangjye99


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
在现代数据分析中,NL2SQL系统通过大模型将自然语言查询转换为SQL语句,极大地简化了数据访问流程。系统的核心包括理解数据库模式、设计有效提示词、生成SQL、执行查询并进行可视化展示。通过记录和分析日志,系统不断优化大模型的提示词和参数设置,提升查询准确性和效率。日志不仅帮助识别性能瓶颈,还为系统的持续改进提供数据支持。最终,NL2SQL系统通过智能化的查询和可视化引擎,为用户提供了高效、直观的

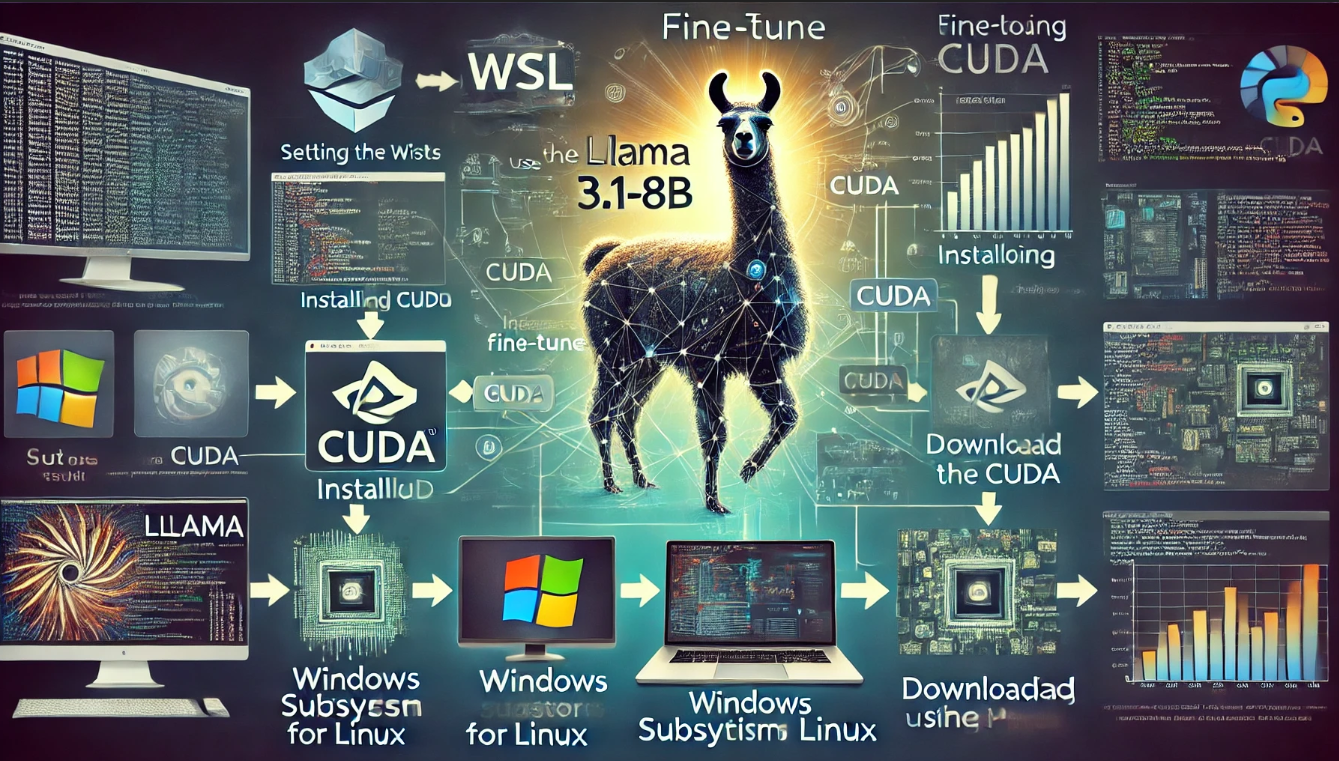
本文详细介绍了如何使用Unsloth框架在WSL环境下对LLaMA 3.1-8B模型进行微调的全过程。通过从环境搭建、微调过程等,读者可以一步步了解如何高效微调自己的专属模型,并通过实例演示了微调后模型的推理效果。本教程特别适合初学者,帮助他们快速掌握Unsloth框架的应用。
本文全面解析了大模型应用生态:从基础模型、模型运行、模型优化、开发框架、中间件到应用层,为企业AI落地提供了清晰路线图。文章深入浅出地介绍了各层关键技术与工具,包括主流开源闭源模型、运行环境、优化方法、开发框架、AI Agent与向量数据库等中间件,以及低代码应用平台。这是一份帮助企业和个人理解大模型技术栈、选择适合工具、实现AI价值的实用指南。

摘要:针对LLM处理海量日志的挑战,提出"日志模板+智能体"方案。通过模板匹配将GB级日志压缩为结构化摘要,结合关键字搜索保留关键细节,利用语义查询增强理解。采用Agent+Tools架构实现动态决策分析,支持按需调用工具组合。该方案有效解决日志数据量与LLM处理能力的矛盾,将原始日志从GB级压缩至KB级,使智能体能快速定位根因。典型场景中,智能体通过分析模板统计趋势和异常日志
本文介绍了NL2SQL(自然语言转SQL)在企业数据分析场景中的应用方案。通过Agent+RAG架构,实现了业务人员自然语言查询到可执行SQL的自动转换。文章详细阐述了从数据准备、知识向量化、RAG检索到Agent配置的全流程,重点讲解了如何构建业务知识库、优化检索策略,以及通过智能体编排实现多阶段推理和SQL验证。该方案解决了传统NL2SQL在表名猜测、业务术语理解等方面的痛点,使业务人员能够直
我于2022年花费2790元购买的华为显示器,在14个月内竟两次发生主板、屏幕等核心部件故障。产品刚过保修期,官方售后维修报价竟高达2492元。这不仅暴露了其产品存在严重质量缺陷,更以不合理的天价维修费剥夺了消费者的公平交易权。我已拒绝其“打折”方案并向12315平台投诉,以此谴责其利用售后牟利的行为。
当我们在 Jupyter Notebook 中查看数据时,有时可能会遇到仅显示部分数据的情况,例如使用省略号(...)表示数据字段。这是因为 Jupyter Notebook 会自动将数据字段的长度限制在一定范围内。本文将介绍如何控制在 Jupyter 中数据字段全部进行显示,而不是显示省略号。

本文全面解析了大模型应用生态:从基础模型、模型运行、模型优化、开发框架、中间件到应用层,为企业AI落地提供了清晰路线图。文章深入浅出地介绍了各层关键技术与工具,包括主流开源闭源模型、运行环境、优化方法、开发框架、AI Agent与向量数据库等中间件,以及低代码应用平台。这是一份帮助企业和个人理解大模型技术栈、选择适合工具、实现AI价值的实用指南。
Markdown 是一种简单易读、易写的标记语言,而且具有高级功能,例如内联图像和链接等。Markdown 可以用于编写文档、博客、Readme 文件等,因为它的格式简单明了,易于编写和阅读。本文介绍了 Markdown 的常用标记和示例,以及如何在 Markdown 中展示图像、进行换行等。
本篇文章介绍了在使用Pandas数据处理库时的一些常见问题的解决方法。文章涵盖了如何在DataFrame中查找、替换、排序数据,以及如何对某一列进行计数。其中,对于每个问题,文章都提供了具体的代码示例,并解释了代码的含义和使用方法。本篇文章适用于Pandas初学者或有一定经验的用户,涵盖了许多常见问题的解决方案,希望能够对读者在数据处理中有所帮助。