- @victory0431


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
NeurIPS 2025论文高效筛选与研究方向挖掘指南 核心策略: 快速定位资源:通过官方渠道(NeurIPS官网、OpenReview、PapersWithCode)获取完整论文列表和会议信息 两步筛选法: 第一层:标题+摘要扫读(<90秒/篇),筛选至约100篇 第二层:速读图表+实验(15-30分钟/篇),精选10篇候选 深度评估:对每个方向进行1-2周的专题研究,包括核心问题、技术路
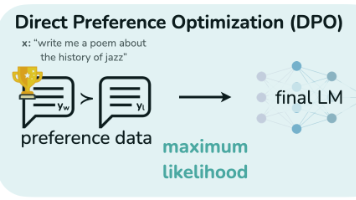
本文探讨了语言模型直接偏好优化(DPO)的效果。研究发现:1)28万条数据微调的SFT模型容易产生无意义回答,680万条数据则需要精细调参;2)DPO训练中,降低学习率(5e-7)、减小batch size(16)和beta值(0.5)能有效平衡事实准确性和回答质量。调整后的模型在技术解释、生活建议等场景表现良好,能提供结构化回答且保持基本事实。实验表明,保守的参数设置更有利于保留关键信息,同时优
Mantis论文实验部分使用了三类时间序列分类基准数据集:1)UCR包含128个单通道时间序列分类任务(如ECG200);2)UEA提供30个多通道数据集(如三轴加速度数据);3)4个真实应用数据集(Blink-EEG、MotionSenseHAR等)。这些基准覆盖医疗、运动、金融等领域,用于评估模型在单/多通道时间序列分类任务上的通用性。数据集特点包括变长序列处理、多分类任务,类比于图像领域的C
摘要:大模型需要具备情景化感受能力,通过训练将场景信息编码为高信息量的向量,实现机器间的模糊情感传递。这种向量支持相似性查询,使模型能共情并支持创作过程——从输入向量发散查询,形成多样化作品。相比简单编码的token,这种向量具有更强的抽象表达能力,为AI情感理解和艺术创作提供了新思路。(149字)
您当前的知识基础(CNN/MLP/Transformer)是必要的,但RLHF属于强化学习的进阶应用,不是"太深",而是您需要扩展的知识领域。RLHF及其变体是当前AI研究的新兴热点,论文数量快速增长但尚未饱和,相比图像处理和NLP等"人满为患"的赛道,RLHF是更好的研究切入点。正如知识库[6]中"强化学习之父"理查德·萨顿所说:“人类数据红利逼近极限,AI正进入以持续学习为核心的’经验时代’”
摘要(149字): 大模型训练入门建议从代码切入,通过解剖train.py掌握核心模块:数据加载、分布式训练、模型迭代等。建议拆解路径为:1)理解数据预处理与流式加载;2)分析训练循环的双层结构;3)研究分布式实现;4)关联模型架构与损失设计。吃透代码后需建立系统思维,绘制训练流程图,结合论文验证理论落地。不必追求千亿参数经验,关键在于掌握数据-模型-算力的平衡能力。通过"复现-简化-创

你的Idea完全可行,且已有多个顶级研究团队实现了类似系统。自监督学习 + 音频token化 + Transformer生成 + 零样本音色控制。Bark是目前最接近你设想的开源工具,支持本地部署,你可以直接拿来实验。加入音乐生成能力(如Suno AI的音乐生成模型)。实现跨语言音色迁移(如VALL-E X)。引入情感控制或上下文理解(对话式语音生成)。你的想法非常有潜力,继续深入,你完全有可能做
摘要 本文为AI研二学生提供了一份大模型/强化学习方向面试准备指南,重点分析了RLHF/RFT岗位的核心考察点,包括强化学习算法、大模型训练流程、优化技术等五大知识板块。针对可能的知识盲区,推荐了分阶段学习路径:先夯实强化学习基础(Sutton教材+David Silver课程),再掌握RLHF/RFT技术(Alignment Handbook+关键论文),最后通过实践项目巩固。文章特别强调PPO
摘要 本文针对200M参数小模型的预训练与监督微调(SFT)阶段,提出了一套可落地的量化评测体系,包含4类核心指标: 困惑度指标:通过验证集计算token-level负对数似然,评估语言建模能力 自动文本相似度:使用BLEU/ROUGE/BERTScore衡量生成内容与参考答案的匹配度 行为稳定性指标:监测重复率、生成长度、EOS使用等生成特性 任务准确率:设计选择题/简单QA等微型评测集 文章强
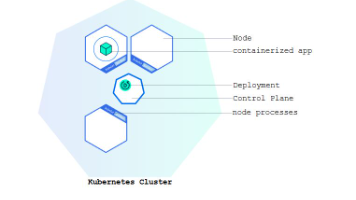
Kubernetes单节点集群部署总结 本文详细记录了Kubernetes v1.28.2单节点集群的部署过程。通过阿里云镜像源成功安装了containerd容器运行时和kubeadm等核心组件,配置了必要内核参数并初始化了控制平面。关键组件(etcd、kube-apiserver等)均已健康运行,但节点状态显示NotReady,主要因Calico网络插件镜像拉取失败所致。部署过程包括:环境准备(