


- @taifyang


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
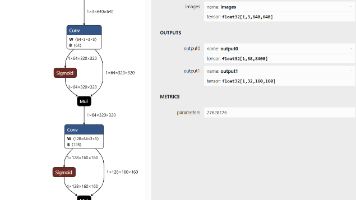
本文介绍了YOLOE模型的ONNX导出与部署流程。首先展示了如何将PyTorch格式的YOLOE模型转换为ONNX格式,并提供了模型结构示意图。然后详细说明了使用ONNX Runtime进行推理的完整代码实现,包括图像预处理、模型推理和后处理过程。后处理部分实现了非极大值抑制(NMS)、坐标转换和掩码处理等关键步骤。最后还提供了辅助工具函数,包含NMS算法、坐标转换和图像letterbox处理等实
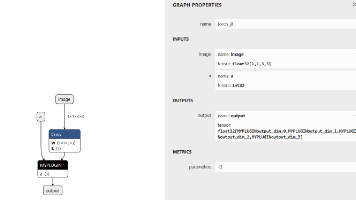
摘要:本文介绍了如何将PyTorch模型导出为ONNX格式,并实现TensorRT自定义算子。首先定义了一个包含自定义算子MYPLUGIN的PyTorch模型,通过torch.onnx.export导出ONNX模型。然后详细讲解了TensorRT自定义算子的实现过程,包括创建插件文件夹、编写CUDA核函数(myselu_kernel)和插件类(myPlugin)。该插件类继承自IPluginV2D
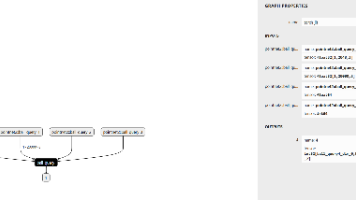
本文介绍了如何将PointNet++中的ball_query操作导出为ONNX模型并实现TensorRT插件。主要内容包括:1) 使用PyTorch导出包含ball_query操作的ONNX模型;2) 分析导出的ONNX模型结构;3) 开发TensorRT插件实现ball_query功能,包括插件类的接口实现和CUDA内核封装。该插件支持动态输入维度计算,包含初始化、执行、序列化等核心方法,并提供
本文介绍了GRCNN机器人抓取项目的模型转换与推理过程。首先从GitHub下载项目后,将训练好的PyTorch模型转换为ONNX格式,并展示了模型结构图。然后分别使用ONNXRuntime和TensorRT进行推理:ONNXRuntime版本实现了数据预处理、模型加载、推理执行以及结果后处理;TensorRT版本则详细展示了引擎加载、显存分配和推理流程。两种方法都能成功预测抓取点位置、角度和宽度,

链接: https://pan.baidu.com/s/15EDzhLEWywpcelyKDEUkAw 提取码: btae 复制这段内容后打开百度网盘手机App,操作更方便哦。–来自百度网盘超级会员v7的分享。
本文介绍了ONNX模型推理流程及预处理方法,主要包括两部分内容:1) 图像预处理模块(image_preprocess.py)实现了图像尺寸调整、归一化和维度转换;2) 简化版CLIP BPE分词器(SimpleCLIPBPETokenizer)实现了从vocab.json和merges.txt加载词表,包含bytes转unicode映射、BPE编码和正则分词功能。其中图像预处理将输入调整为100
本文介绍了如何在PyTorch自定义算子基础上编写支持FP16的TensorRT插件。主要内容包括: 自定义PyTorch模型导出ONNX模型,包含自定义算子的实现和属性设置 TensorRT插件开发,实现了IPluginV2DynamicExt接口,支持FP16推理 插件包含两个构造函数,分别用于引擎构建和推理阶段 实现了必要的插件方法如序列化、反序列化、格式支持检查等 提供了FP16和FP32
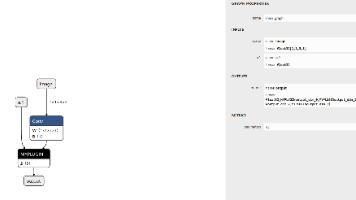
文章摘要:本文介绍了DEIMv2模型在ONNX Runtime和TensorRT两种环境下的部署方法。通过Python代码示例演示了图像预处理、模型推理和后处理流程,包括保持宽高比的图像缩放、边界框调整和结果可视化。两种部署方式都支持目标检测任务,能够处理输入图像并输出检测框、类别和置信度分数。ONNX Runtime使用CPU执行,而TensorRT则利用CUDA加速,展示了深度学习模型在不同推
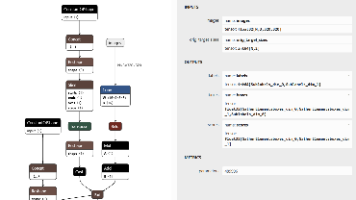
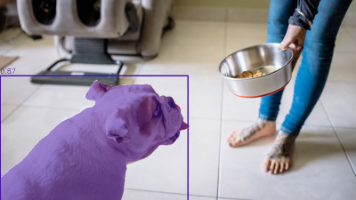
本文介绍了FastSAM模型在ONNXRuntime和TensorRT框架下的部署方法。首先展示了如何将PyTorch模型导出为ONNX格式,并提供了ONNXRuntime的完整推理脚本,包括图像预处理、模型推理、后处理(NMS、掩膜处理)和结果可视化。然后简要提及了TensorRT的部署方案,虽未提供完整代码,但表明可通过类似流程实现。两种部署方式均支持目标检测和实例分割任务,能够处理输入图像的
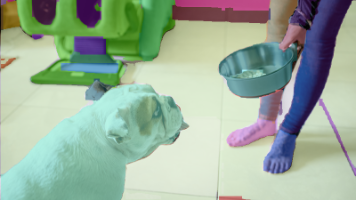
本文介绍了DINOv3视觉模型的三种部署方式:PyTorch推理、ONNX Runtime部署和TensorRT部署。在PyTorch部分,详细展示了模型加载、图像预处理和推理过程,并提供了将模型导出为ONNX格式的代码。ONNX Runtime部分说明了如何加载ONNX模型并进行推理,包括图像预处理和推理执行步骤。TensorRT部署部分则着重介绍了显存需求(约30GB)和推理流程,包括引擎加载