


- @sunbaigui


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
参考链接:http://tortoisesvn.net/docs/nightly/TortoiseSVN_zh_CN/tsvn-serversetup-svnserve.html参考链接: http://blog.csdn.net/lu7kang/article/details/6245588参考链接:http://blog.csdn.net/starnight_cbj/article/d
世界名牌大学的开放教育链接资源
本文介绍AI开源能力对抖动的视频进行稳像,达到清晰稳定的效果。在ModelScope魔搭平台上开源了DUT-RAFT视频稳像算法,几行代码即可调用,无需复杂的操作,也无需复杂的输入。鼠标一点即可畅快体验让视频变稳定的AI“魔法”。
转载链接:http://wenku.baidu.com/view/cedf3244a8956bec0975e328.html我的VS2010+VAssistX最近越来越觉得VAssistX好用,可能是以前没有去仔细研究过吧,也可能是因为我是个快捷键控吧,不管怎样,用或不用,方便或不方便,它就是那里,一动也不动,进入正题,给大家介绍下我的使用配置:(我只是引玉,你可以抛砖)VS201
运动目标检测、阴影检测及目标跟踪中用得到的标准测试视频下载
CVPR 2023将于2023年6月18-22日举办。届时第三届“无人机跟踪”挑战赛将作为第三届反无人机挑战研讨会的一部分与CVPR2023一起举办。近来国内外多次发生无人机滥用事件。因此,开展复杂环境下低慢小(无人机)目标智能感知的研究,从而对无人机进行有效的探测和监管,具有重要意义。
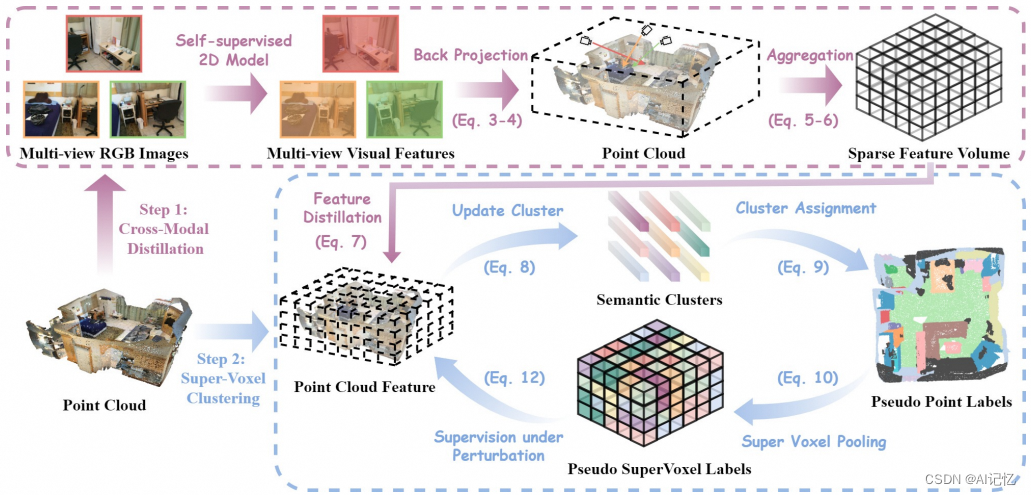
针对无监督3D场景的语义分割,提出一套基于深度聚类的自监督学习算法,可以大幅提升3D分割的效果(ScanNet-v2 (+18.4 mIoU)、S3DIS (+11.5 mIoU))。
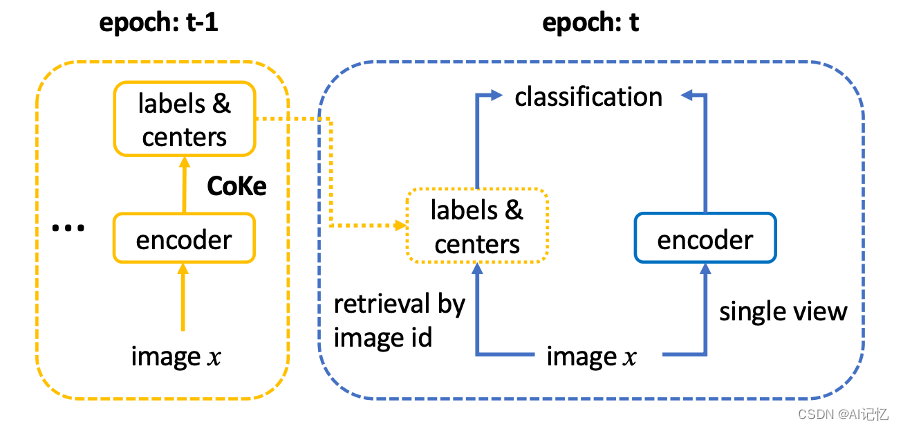
本文设计了基于聚类的自监督学习框架CoKe,参考有监督学习,以极简的框架进行高效的训练.同时,为了避免聚类自监督学习中常遇到的collapse问题,我们提出一个新的聚类size下限的限制并开发online算法进行相应的优化.
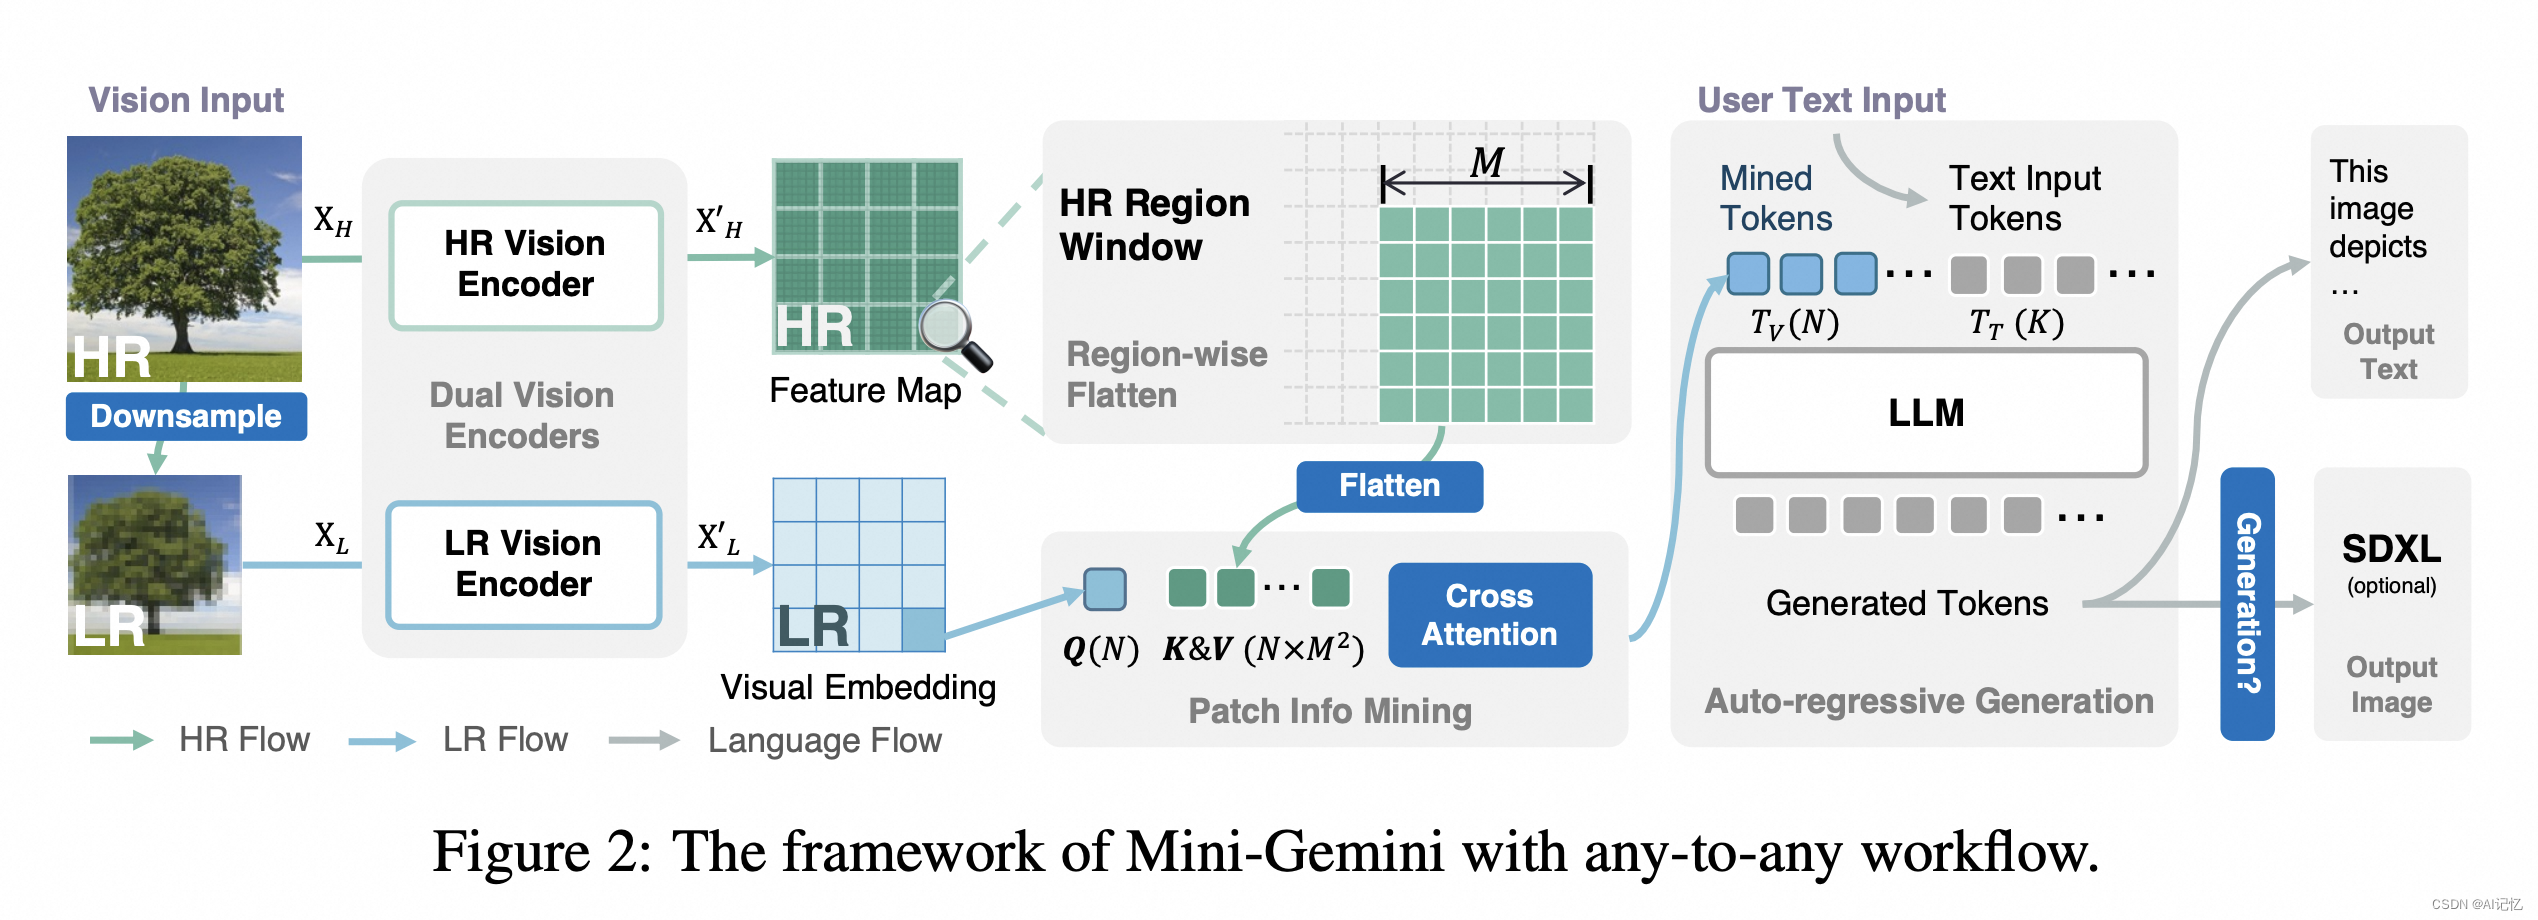
最近,一篇名为“Mini-Gemini: Mining the Potential of Multi-modality Vision Language Models”的文章在arXiv上发表,为我们展示了一个简单而有效的框架,旨在提升多模态视觉语言模型(VLMs)的性能。它即能直接提升图像感知能力,也能作为多模态环境下图像生成任务的前置prompt生成器。主要探索了如何增强图像全局感受野,以及探索
vgg和googlenet是2014年imagenet竞赛的双雄,这两类模型结构有一个共同特点是go deeper。跟googlenet不同的是,vgg继承了lenet以及alexnet的一些框架,尤其是跟alexnet框架非常像,vgg也是5个group的卷积、2层fc图像特征、一层fc分类特征,可以看做和alexnet一样总共8个part。根据前5个卷积group,每个group中的不同配置,