- @smile_tianya


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
启动 Web 浏览器(例如 Firefox、Chrome 或 Safari),然后在地址栏中输入上一步中的主机名或 IP 地址。如果您使用自签名证书(而不是使用 Let's Encrypt),您的 Web 浏览器将要求您确认您信任该证书。如果您正在从 iOS 或 Android 应用程序进行测试,并且您使用的是自签名证书,则此时它可能会失败。您应该会看到一个网页,提示您创建新会议。确保您可以成功创
你看完 100 个视频可能忘掉 80 个。但如果每个视频都有一份结构化摘要,你可以搜索「微前端 Module Federation 部署」,立刻找到所有相关视频和对应的时间点。
这篇文章通过50行Go代码演示了大语言模型(LLM)的核心工作原理,帮助程序员快速理解三个关键概念: Token机制:LLM处理的是文本片段而非单个字,中文字通常1-2个token,直接影响API调用成本; Temperature参数:控制模型输出的随机性,从保守(0.1)到创意(1.5)可调,不同场景需要不同设置; 上下文窗口:决定模型的"短期记忆"容量,如DeepSeek V4支持128K t

模块一结束了。10 篇文章,从「AI 能帮程序员做什么」到「AI 的边界在哪」。但你可能有个问题:每次写代码都要重新搭环境——注册 API Key、配置环境变量、装各种依赖。能不能一次性搭好?这篇给你答案:一个 Docker Compose 文件,把 AI 开发需要的所有基础设施拉起来。

这篇把 Agent 全套打包进 Docker——包含 LLM 调用、Redis 缓存、向量数据库。一个 `docker compose up -d`,全部就绪。

别想着 AI 包办一切。正确姿势是:AI 写 80%(正常+边界),你写 20%(核心业务规则+并发安全)。
你有没有遇到过这种情况——Agent 生成的代码跑不起来,它自己不知道,还一脸自信地说「代码已完成」?
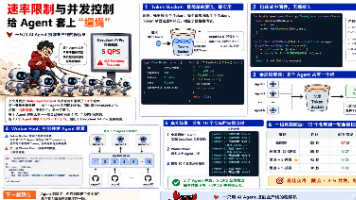
这篇给你一个 Token Bucket 限流器,以及多 Agent 场景下的并发编排方法。
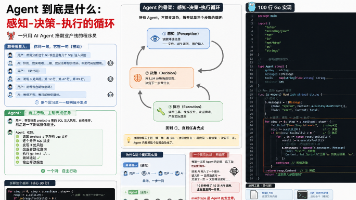
普通聊天:`用户 → AI → 用户 → AI`,单向,一步一问。Agent:`用户 → AI → 工具 → AI → 工具 → AI → 答案`,AI 能自己驱动流程。**AI 从一个「回答问题的人」变成了「完成任务的人」。**
传统爬虫的痛点不是写代码——是维护。你要爬一个技术博客,先 F12 看 DOM,找到标题的 class 是 `.article-title`,作者是 `.author-name span`,正文是 `#content p`。写好了跑两周,网站改版了——class 全变了,你的爬虫挂了。AI 爬虫的思路刚好反过来:**不写选择器,让 AI 自己看 DOM 决定什么是标题、什么是正文。**