


- @robert_chen1988


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
使用 python 编写了多阶段报童模型的动态规划算法。

安排了下学期讲《多元统计分析》,因为我学过这门课,本来不觉得多么难。然而拿到教材后,才知道理论那么深奥,这门课比高等数学都难。我记得硕士期间学这门课老师对理论部分讲的很简单,讲了一些操作,总体讲的很一般。我自己读了好几本多元统计学的教材,发现这些教材参差不齐,没有一个完美的:要么写的太难,堆了不少高深的矩阵知识上去,有一些理论做统计分析时很少用到,我觉得没啥必要都放到书里面去;要么写的太简略,一.
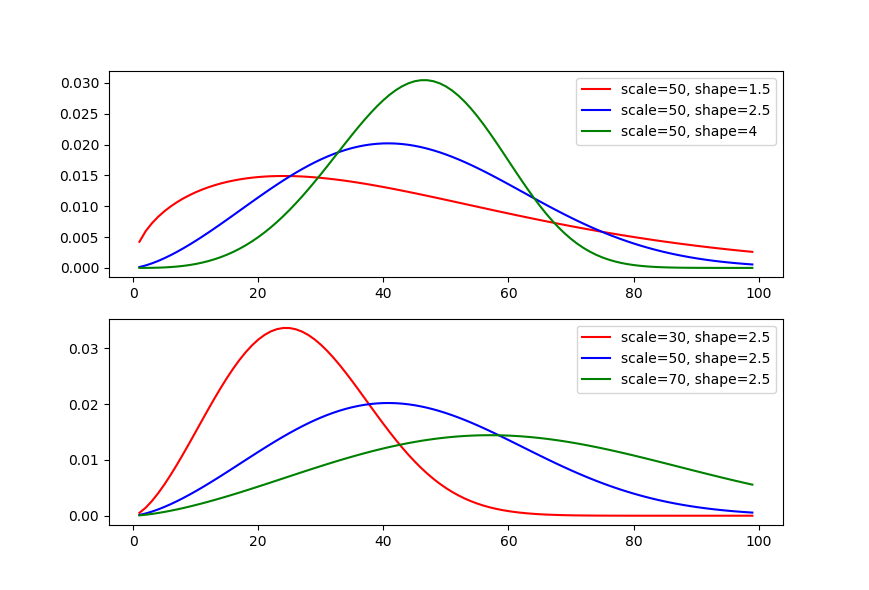
韦伯分布(Weibull distribution) 一般用来统计可靠性或寿命检验时用,例如:预计在有效寿命阶段有多少次保修索赔?预计将在 8 小时老化期间失效的保险丝占多大百分比?在管理科学与工程领域,见到一些学者假定产品的需求为韦伯分布。因为正态分布或者泊松分布过于理想化,韦伯分布相对来说更接近现实一些。韦伯分布的概率密度函数为:f(x,λ,k)={kλ(xλ)k−1e−(x/λ)kx≥...
最近使用 java 调用 cplex, 发现 cplex 对 java 的支持比对matlab强大多了,类跟方法有几百个。但这些类和方法的注释并不是特别详细,还需要结合例子来看懂。一、 准备工作:导入 cplex 库 到 eclipse 中1. 首先从官网上下载 cplex: https://www.ibm.com/developerworks/commun
matlab有强大的矩阵操作,对于c++,若要实现matlab的矩阵功能,我发现只有 vector 容器类最接近了。然而,vector 容器类每次只能在尾部添加一个元素,若要添加一列元素,可以定义一个结构体容器,也可以定义一个指针容器。结构体与指针里面存储一个一维数组。举例,下面是一个指针容器,可以直接在容器里添加一个数组。#include#includeusing names
这些时间序列的原始数据一般为文本格式,我们需要将它转化为时间日期格式。对于很多时间序列数据,有时候经常需要对它们按一定周期进行数据聚合,可以用 Pandas 提供的。函数中的参数为一个字典形式:替换前的名字为字典的 key,替换后的名字为字典的 value。函数第一项为原数据中的值,第二项为需要替换的值。的其他参数中, ‘T’ 表示分钟,‘H’ 表示小时,除了跟。在数据量比较大时,经常会遇到重复数

本文总结了深度学习中三个重要概念: 上下文向量(context vector):在序列模型中用于表示输入序列相关信息的向量,从最初的固定编码器状态发展为注意力机制下的动态加权求和,提升了长序列处理能力。 批量大小(batch size):训练时每次输入的样本数量,影响GPU并行效率、梯度稳定性及学习率设置,常用范围从32到8192不等,需权衡内存与计算效率。 嵌入(embedding):将分类数据
摘要:本文总结了使用PyTorch进行深度学习的标准流程,主要包括:1)数据加载与清洗;2)数据标准化处理;3)数据转换为Tensor格式;4)划分训练/验证/测试集;5)创建Dataset和DataLoader;6)构建神经网络模型类;7)选择损失函数和优化器;8)训练模型;9)预测评估。文章详细说明了每个步骤的具体实现方法,包括数据预处理技巧、模型构建方式、常用损失函数和优化器选择等,为PyT

本文介绍了序列到序列(seq2seq)模型的基本原理和应用。seq2seq模型通过编码器(Encoder)将输入序列转换为固定长度的上下文向量(Context Vector),再通过解码器(Decoder)生成输出序列。文章以LSTM网络为例,展示了如何使用seq2seq模型预测AirPassengers时间序列数据,包括数据预处理、模型构建、训练和评估过程。实验结果表明,该模型能有效预测时间序列

Julia语言在科学计算领域展现出色性能,通过多阶段报童模型的动态规划实验对比,Julia(0.673秒)接近C++(0.313秒)的速度,远快于Java(1.805秒)和Python(40.876秒)。其代码量仅为C++的2/3,同时具备Python的简洁语法和交互式开发环境Pluto。实验使用泊松分布需求模型,展示了Julia在数值计算、类型系统和缓存优化方面的优势,成为兼顾性能与开发效率的新